Adicionar como fonte preferencial no Google
Ao descobrir que grande parte do tráfego do seu site vem de bots, bloqueá-los pode parecer a próxima medida óbvia. Em alguns casos, os números realmente exigem uma resposta imediata.
Recentemente, o PatronView documentou 3,6 milhões de solicitações chegando ao seu site em um único dia, com tráfego proveniente de mais de 360 mil endereços IP. Por fim, o proprietário do site criou um conjunto bastante agressivo de regras do Cloudflare para controlar o tráfego.
Também observamos casos extremos em nossa própria infraestrutura. Em nosso relatório sobre tráfego de IA e bots, um crawler gerou 3,75 milhões de solicitações para URLs de adição ao carrinho em 24 horas. Outro padrão de loop recorrente gerou centenas de milhões de solicitações antes de introduzirmos uma regra para detectá-lo.
Esses casos são reais, mas não representam todos os sites.
Em nossa análise mais recente de mais de 5 mil sites WordPress, os bots de IA foram responsáveis por apenas 1,57% da largura de banda no site mediano, em comparação com 17,8% no 90º percentil e 90,3% no 99º percentil, enquanto mais de mil sites não registraram nenhum consumo de largura de banda por bots de IA.
Essa variação explica por que identificar tráfego de bots de IA e diagnosticar um problema com bots de IA são duas coisas diferentes.
As decisões tomadas em seguida podem afetar o desempenho do site, as integrações, a visibilidade nas pesquisas e a capacidade de ferramentas de IA exibirem seu conteúdo. Antes de alterar qualquer coisa, você precisa saber o que os bots estão realmente fazendo.
Veja alguns erros que observamos os proprietários de sites cometerem quando ignoram essa etapa.
Erro 1: tratar a porcentagem como o diagnóstico
Se os crawlers de IA forem responsáveis por 20% das solicitações do seu site, esse número, por si só, não revela se existe um problema.
Uma grande proporção de solicitações direcionadas a artigos armazenados em cache pode exercer relativamente pouca pressão sobre o aplicativo, enquanto uma quantidade menor de solicitações repetidas a resultados de pesquisa, páginas de produtos com filtros ou URLs do carrinho pode gerar muito mais trabalho.
Esse é um dos motivos pelos quais as estatísticas de bots de toda a rede exigem certo cuidado quando aplicadas a um site específico.
Nossa pesquisa mais recente revelou que o número médio de solicitações de bots de IA por site variou de 667 a 928 por dia em quatro medições, em comparação com uma mediana de apenas 33 a 67 solicitações, enquanto aproximadamente 20% a 27% dos sites não receberam nenhuma solicitação de bots de IA em um dos dias analisados.
Em outras palavras, um pequeno grupo de sites intensamente rastreados eleva a média.
Portanto, se você ler que os bots representam mais da metade do tráfego da web ou vir outro proprietário de site relatando que 99% do tráfego vem de bots, não use esse número para decidir do que o seu próprio site precisa.
Comece pelo tráfego do seu próprio site.
Para os clientes da Kinsta, a seção Proteção contra bots no MyKinsta mostra como as solicitações estão sendo classificadas, incluindo prováveis humanos, bots verificados, prováveis bots, crawlers de IA, crawlers de IA com taxa excessiva, tráfego automatizado e tráfego malicioso.
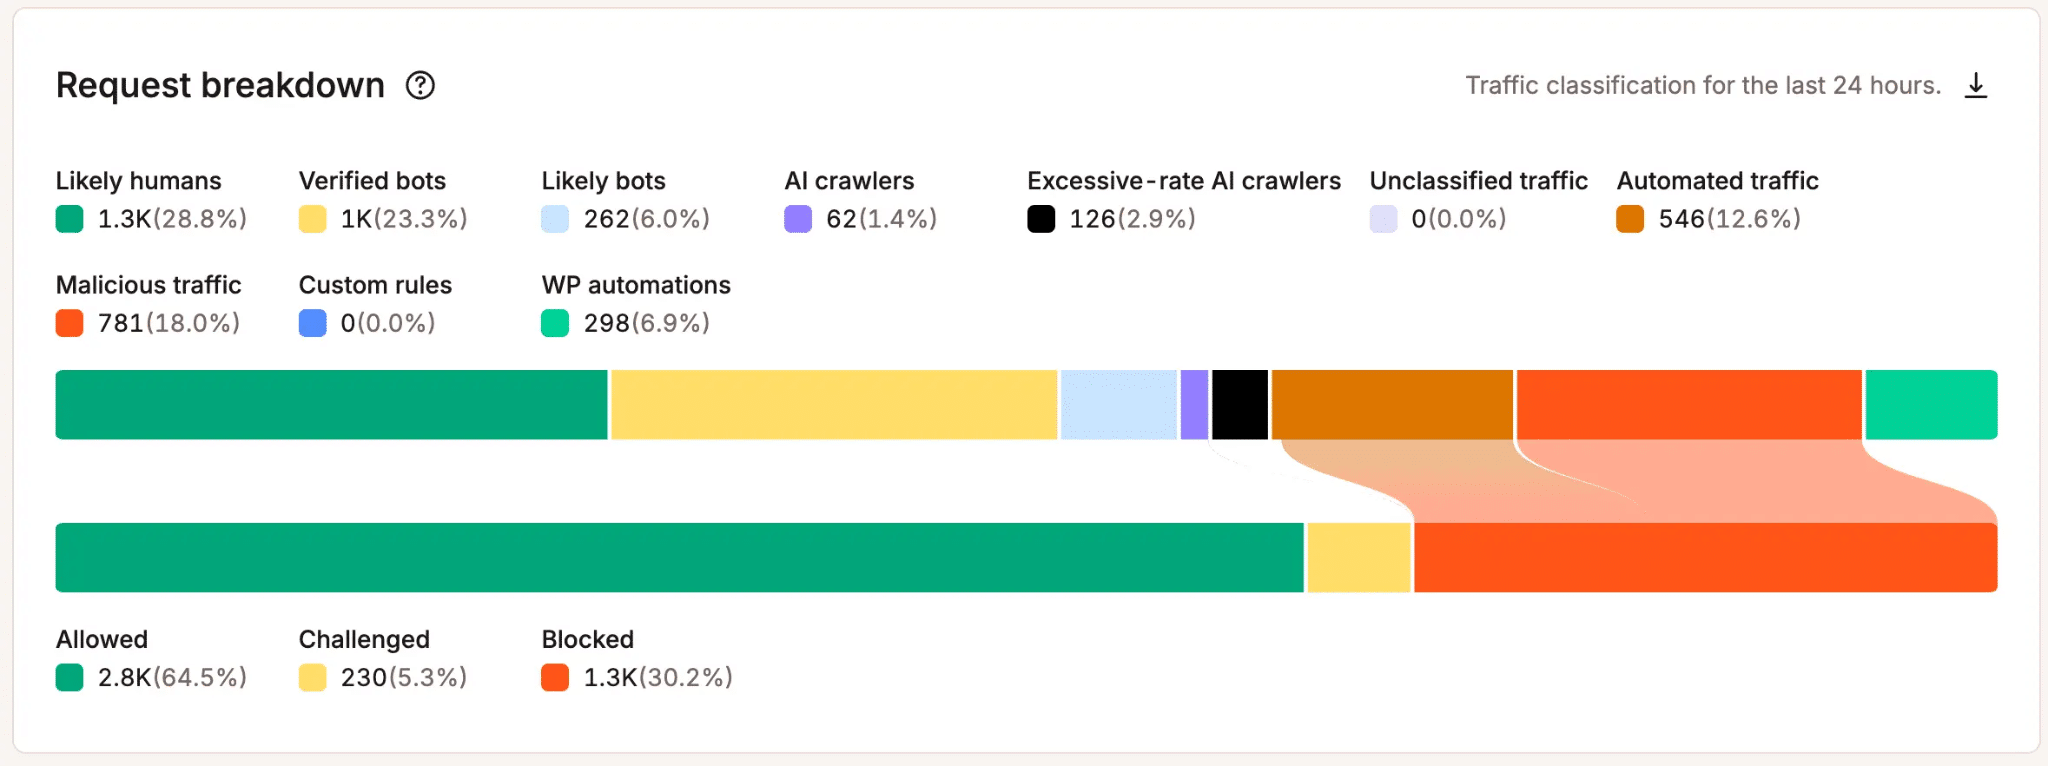
Em seguida, você pode usar Principais origens de tráfego para consultar os caminhos, agentes de usuário, países e endereços IP relacionados a um tipo específico de tráfego.
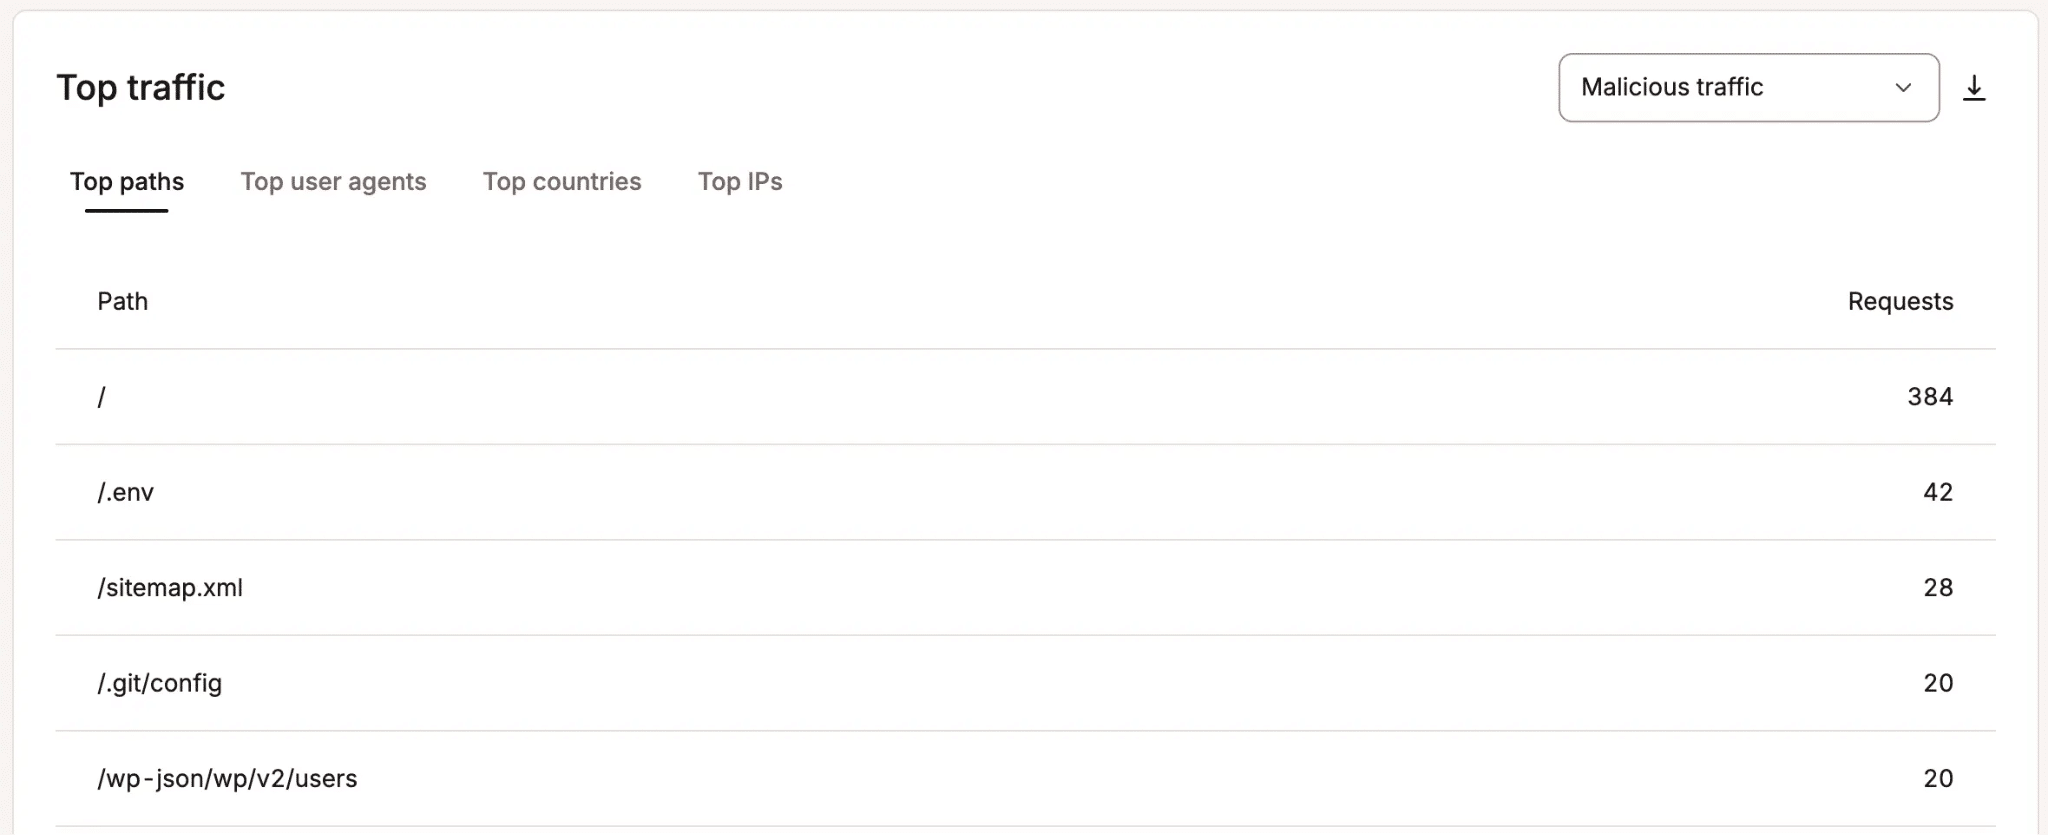
Antes de tomar qualquer medida, você deve conseguir responder a algumas perguntas básicas:
- Quanto tráfego de IA está realmente chegando ao site?
- Quais páginas ou endpoints ele está solicitando?
- Quais crawlers , agentes ou outros sistemas automatizados são responsáveis?
- Parte desse tráfego está afetando o desempenho, a largura de banda, as threads PHP ou a experiência de visitantes reais?
Nosso relatório mais recente apresenta isso como uma análise da posição, do padrão e do perfil do tráfego. Um site que recebe muito pouco tráfego de IA, com um comportamento comum de solicitações, talvez não precise tomar nenhuma medida, enquanto outro que registra tráfego contínuo de crawlers direcionado a URLs dinâmicas que exigem muitos recursos merece uma análise muito mais cuidadosa.
Erro 2: bloquear todos os bots porque o tráfego é automatizado
O termo “bot de IA” agora abrange vários tipos diferentes de tráfego. Alguns crawlers coletam conteúdo público para o treinamento de modelos ou pesquisas com IA, enquanto outros acessam páginas em resposta à solicitação de um usuário.
Essas diferenças são importantes ao decidir o que permitir. A OpenAI, por exemplo, usa o GPTBot para coletar conteúdo que pode ser utilizado para aprimorar seus modelos, enquanto o OAI-SearchBot ajuda a tornar os sites encontráveis na pesquisa do ChatGPT. Portanto, bloquear o OAI-SearchBot pode afetar a exibição do seu conteúdo nos resultados de pesquisa do ChatGPT.
A Anthropic faz uma distinção semelhante. O ClaudeBot coleta conteúdo da web que pode contribuir para o treinamento de modelos, o Claude-SearchBot é usado para pesquisas e o Claude-User pode acessar um site quando alguém que usa o Claude solicita isso.
A Perplexity informa que o PerplexityBot é usado para seu índice de pesquisa e o Perplexity-User para solicitações feitas em resposta à pergunta de um usuário.
O Google oferece aos editores um controle separado, o Google-Extended, para determinar como o conteúdo rastreado pode ser usado com o Gemini. O Google afirma explicitamente que alterar essa configuração não afeta a inclusão nem a classificação na Pesquisa Google.
Agrupar todos esses sistemas em uma única categoria de “IA” elimina informações que você poderia utilizar.
Se preferir não consumir os recursos do site com o treinamento de modelos, você pode optar por restringir crawlers de treinamento e manter acessíveis os sistemas de pesquisa e recuperação. Se o problema for um agente de IA acessando repetidamente um endpoint dinâmico, alterar sua política de acesso para crawlers de treinamento talvez não o resolva.
Também há uma questão comercial envolvida. Nossa pesquisa com consumidores revelou que 44,7% dos entrevistados afirmaram que sempre ou quase sempre visitam o site de uma empresa após receberem uma recomendação de IA. Isso não significa que permitir o acesso de crawlers de IA gere automaticamente tráfego de referência, mas indica que vale a pena considerar a descoberta por IA antes de tomar uma decisão geral sobre visibilidade.
Na Kinsta, o controle Bloquear crawlers de IA permite que os clientes bloqueiem crawlers de IA, inclusive os verificados, sem bloquear crawlers de mecanismos de pesquisa tradicionais, como Googlebot e Bing.
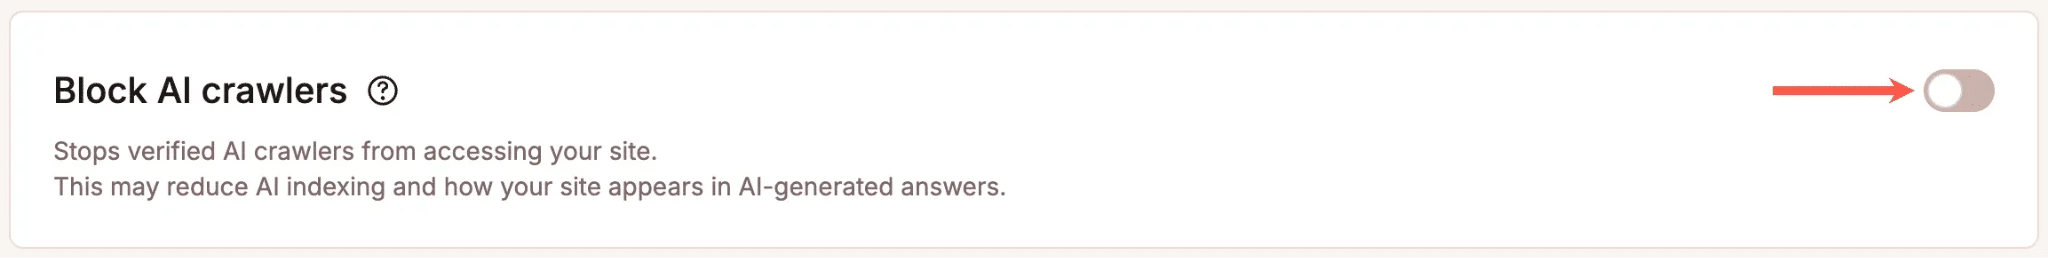
Também alertamos os clientes de que bloquear crawlers de IA pode reduzir a visibilidade em resultados de pesquisa, resumos ou recomendações com tecnologia de IA.
Erro 3: tratar cada pico de crawlers de IA como uma emergência de segurança
Os bots podem causar problemas de segurança por meio de tentativas de força bruta, ataques DDoS, ataques com credenciais e outras formas de automação abusiva, mas um crawler de IA verificado que envia solicitações legítimas em excesso representa um tipo diferente de problema.
Durante nosso evento ao vivo sobre tráfego de bots, Daniel Pataki, CTO da Kinsta, explicou por que se preocupa com a forma como os proprietários de sites respondem quando essas duas situações são confundidas:
“Nesse caso, temo mais uma reação exagerada do que uma reação insuficiente, pois não se trata de um problema de segurança.”
Ele se referia ao problema mais amplo dos crawlers de IA, no qual grande parte do tráfego problemático que observamos vem de sistemas legítimos que realizam rastreamentos de maneira ineficiente, e não de um invasor tentando comprometer o site.
A resposta muda quando o site já está enfrentando problemas. Se os bots estiverem ocupando os recursos do servidor, tornando as páginas mais lentas ou impedindo que clientes reais usem o site, estabilizá-lo deve ser a prioridade. Daniel recomendou bloquear temporariamente o tráfego de bots quando ele estiver causando um problema ativo e investigar o ocorrido depois que o site estiver sob controle.
O erro é transformar essa medida emergencial em uma política permanente sem descobrir o que aconteceu.
A Proteção contra Bots da Kinsta oferece vários níveis de controle, desde a proteção básica contra tráfego malicioso até o bloqueio de automações ou a aplicação de desafios a prováveis bots quando uma proteção mais rigorosa é necessária. Crawlers de IA com taxas excessivas também podem receber desafios nos níveis de proteção apropriados.
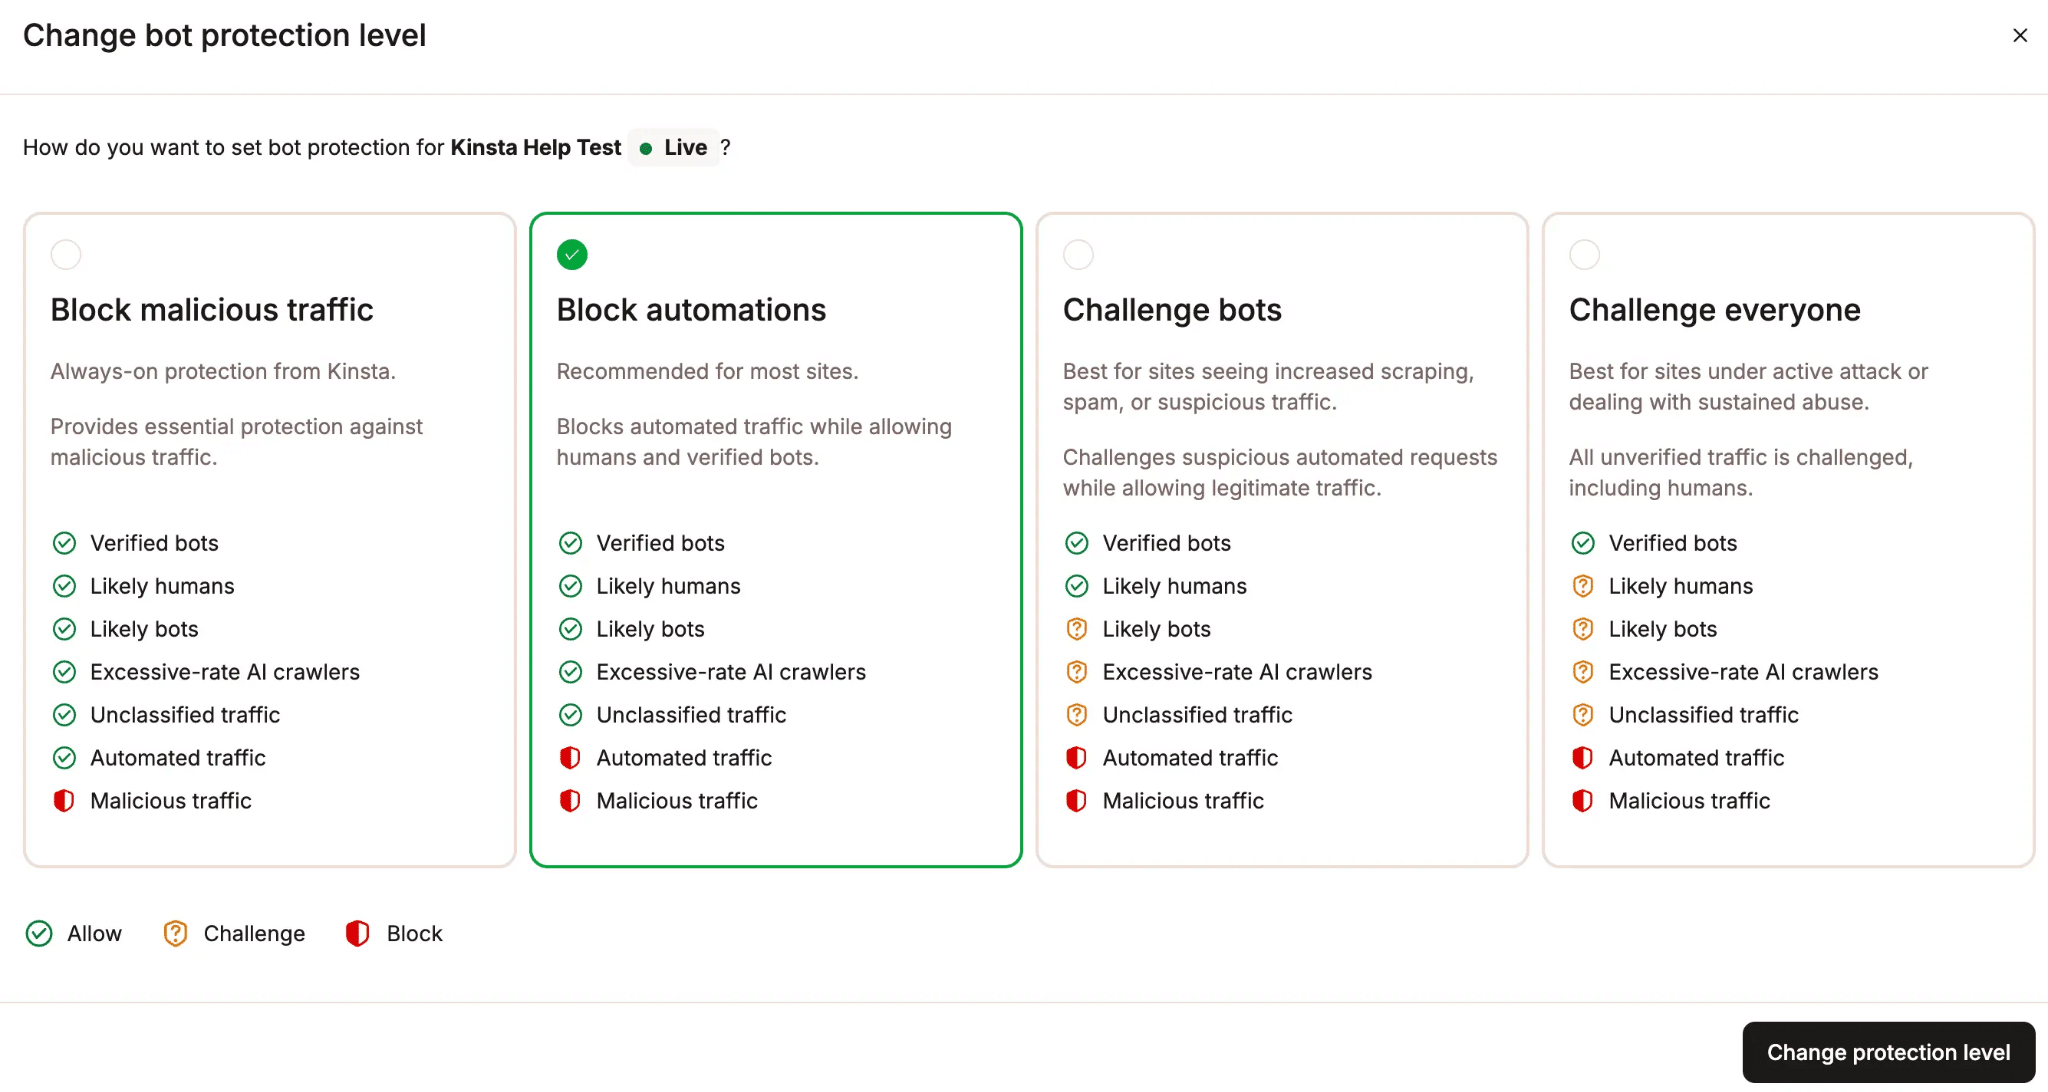
Um incidente repentino de desempenho pode justificar controles mais rigorosos hoje. Depois que o incidente passar, verifique qual tráfego estava chegando ao site e se esses controles mais rigorosos ainda fazem sentido.
Erro 4: observar o volume de solicitações e ignorar para onde elas são direcionadas
Os dados da nossa infraestrutura deixam essa diferença evidente. Uma solicitação para um artigo armazenado em cache e outra para uma página de pesquisa não armazenada em cache do WooCommerce são contabilizadas como uma única solicitação cada, embora a segunda possa exigir muito mais trabalho do servidor.
Veja uma ilustração do evento ao vivo sobre a realidade do tráfego de bots:
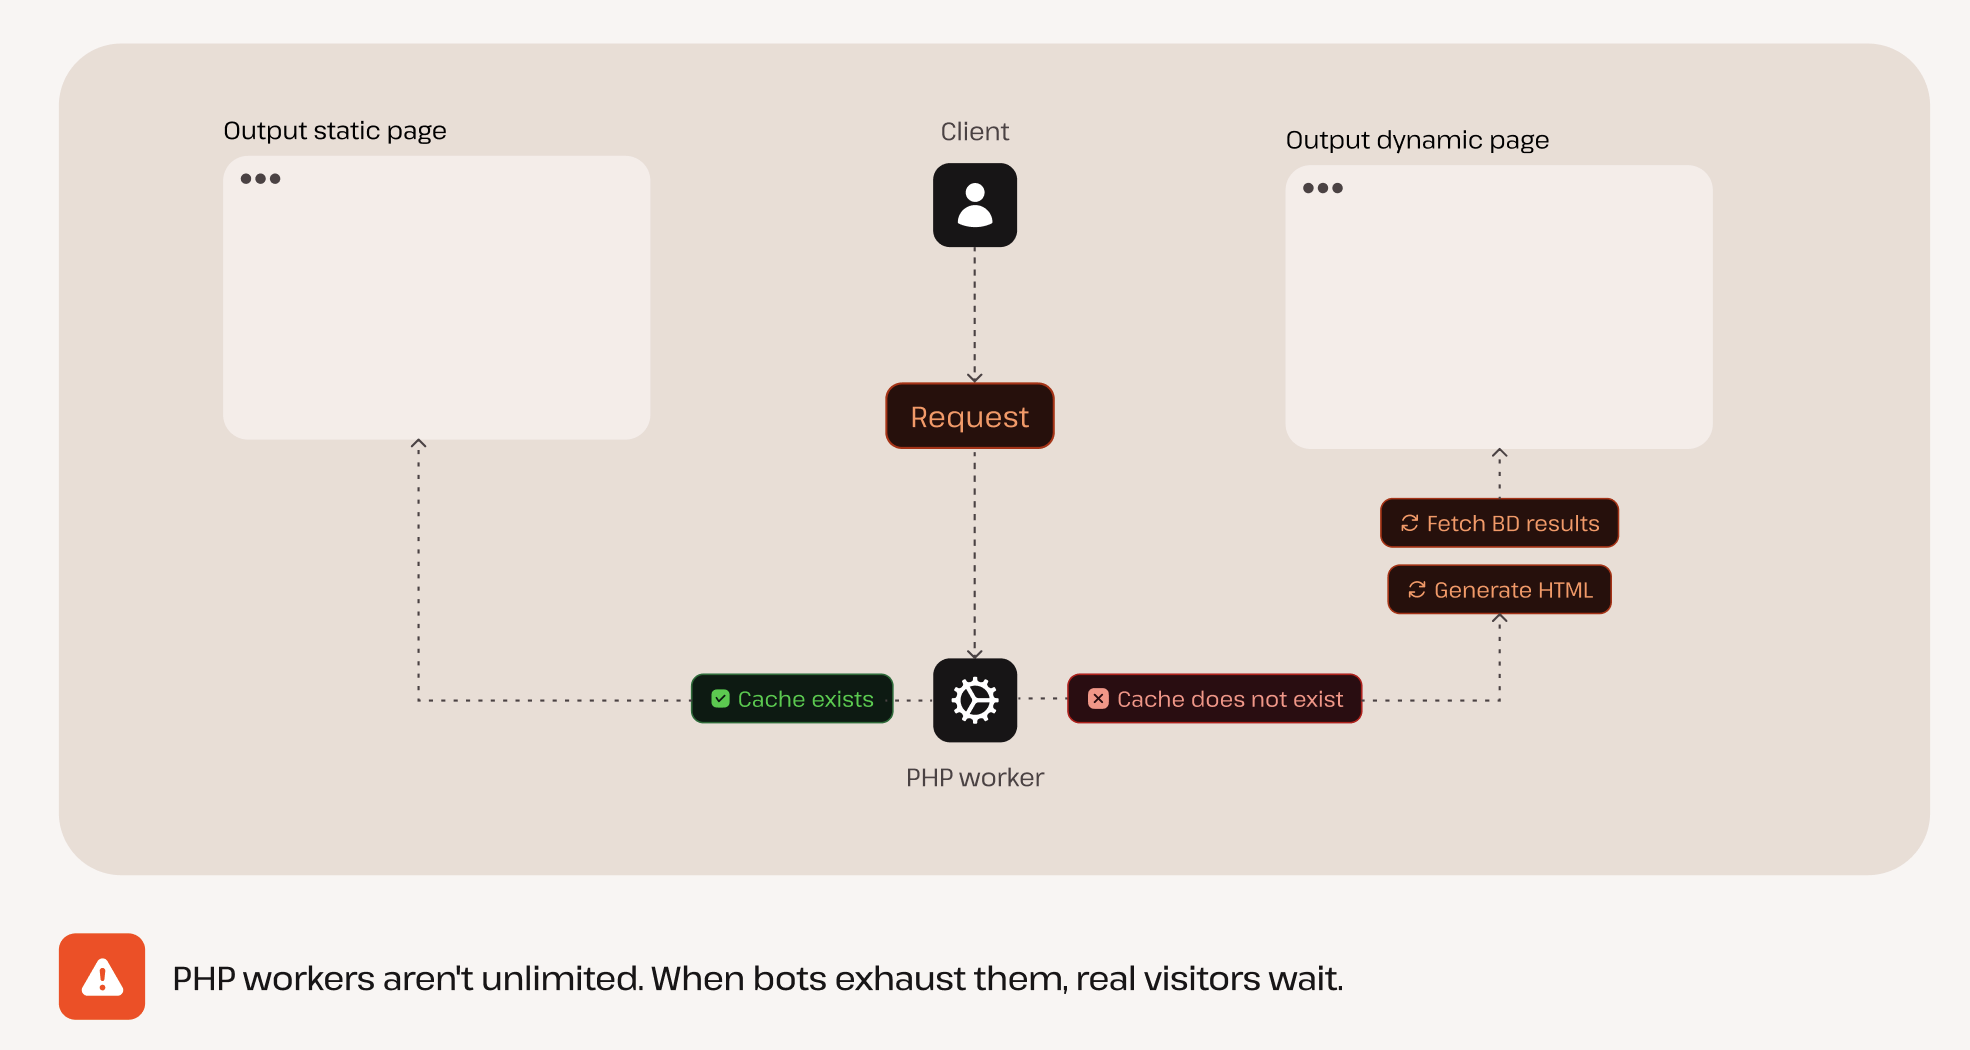
Quando uma página armazenada em cache está disponível, o WordPress pode processar grande parte da solicitação sem gerar a página novamente.
Uma solicitação dinâmica pode precisar de uma thread PHP (também conhecida como worker), consultas ao banco de dados, geração da página e, em alguns casos, gerenciamento de sessão antes que o WordPress possa retornar qualquer conteúdo. As atividades no carrinho e na finalização da compra podem exigir ainda mais trabalho.
Agora, repita esse processo milhares de vezes.
Em três medições realizadas em nosso estudo mais recente, entre 76,9% e 90,5% das solicitações de crawlers de IA foram direcionadas a conteúdo dinâmico. O tráfego humano permaneceu entre 18,3% e 18,9%.
Essa diferença revela muito mais sobre a possível pressão sobre a infraestrutura do que uma simples contagem de solicitações.
Considere o incidente relacionado à adição ao carrinho que identificamos em nossa pesquisa sobre tráfego de bots de IA. Um crawler gerou 3,75 milhões de solicitações em 24 horas, o equivalente a aproximadamente uma solicitação a cada 23 milissegundos. Cada solicitação poderia fazer o WordPress executar tarefas para um “visitante” que jamais compraria algo.
Isso também explica por que dois sites com a mesma porcentagem de tráfego de IA podem apresentar comportamentos muito diferentes.
Um site de conteúdo no qual os crawlers solicitam principalmente artigos armazenados em cache pode processar um grande volume sem muitas dificuldades, enquanto uma loja WooCommerce pode sentir o impacto muito mais cedo se até mesmo uma quantidade menor de solicitações acessar repetidamente a pesquisa, os filtros, as ações do carrinho, as páginas da conta ou outras rotas não armazenadas em cache.
Depois de identificar um pico, não analise apenas o agente de usuário.
No MyKinsta, você pode filtrar Principais origens de tráfego por Crawlers de IA e verificar os caminhos que eles solicitam com mais frequência.
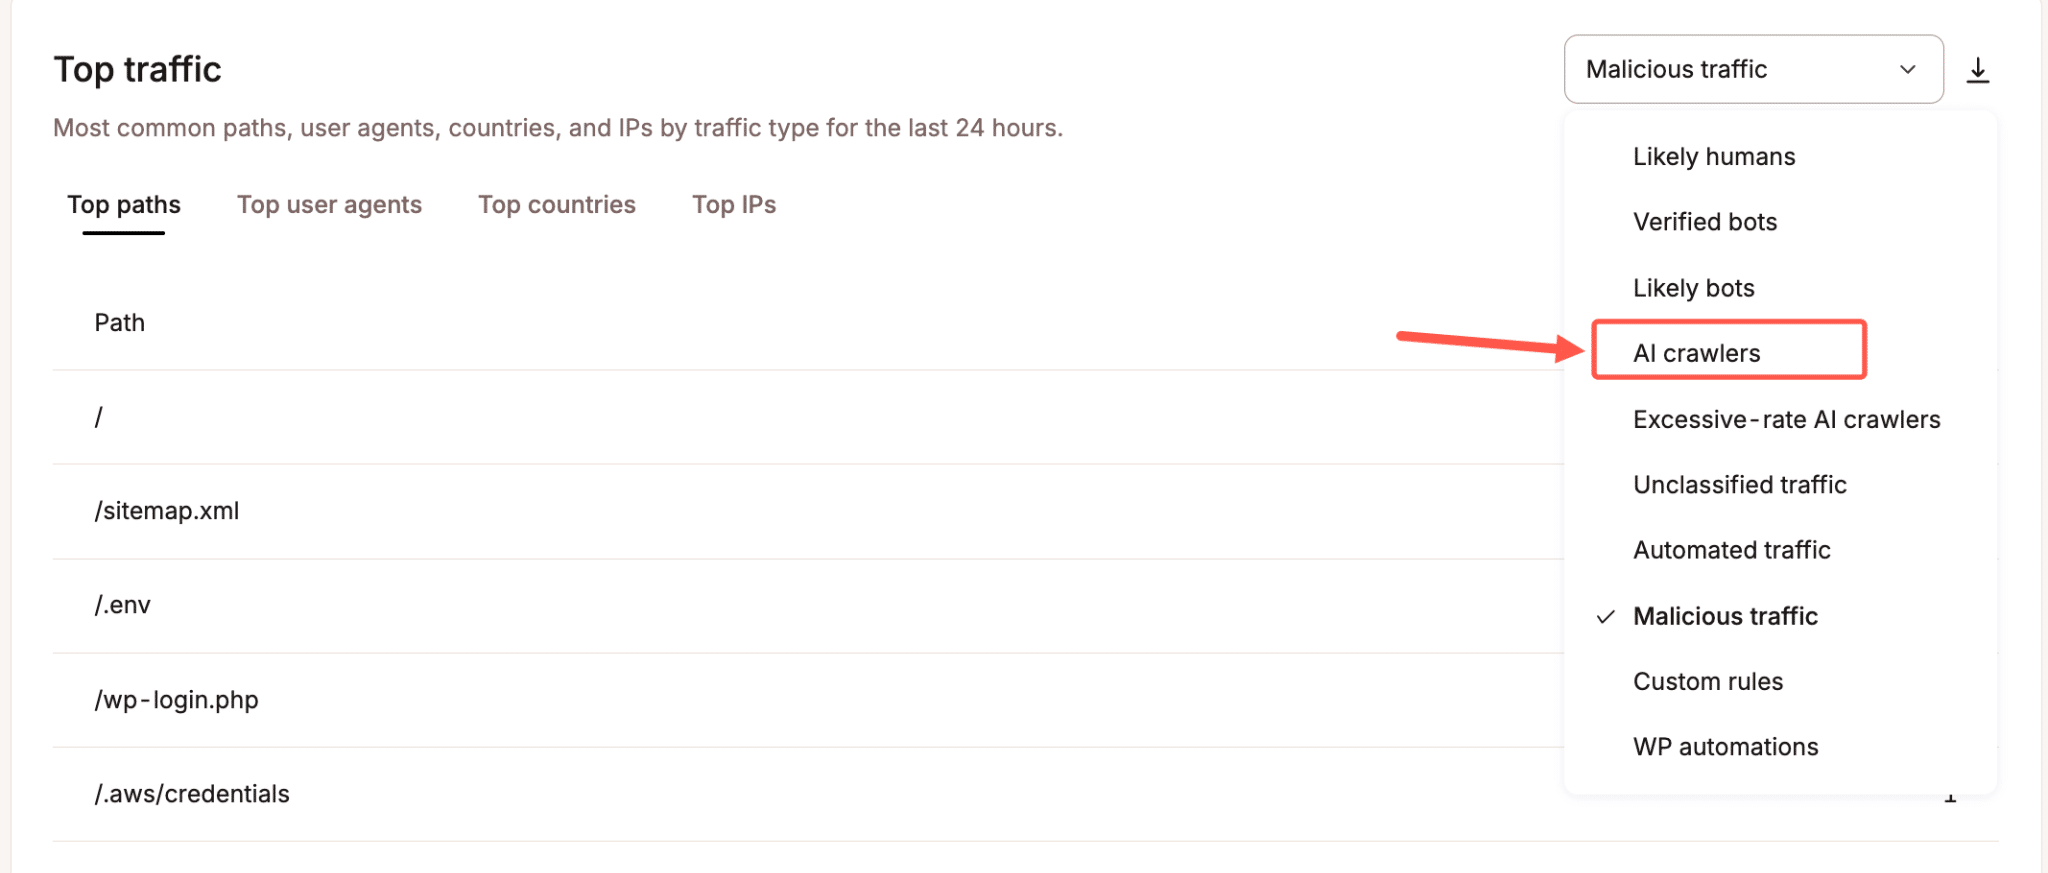
Em seguida, compare essas informações com os dados de cache, largura de banda do servidor e desempenho para verificar se essas solicitações estão chegando ao aplicativo e exigindo processamento.
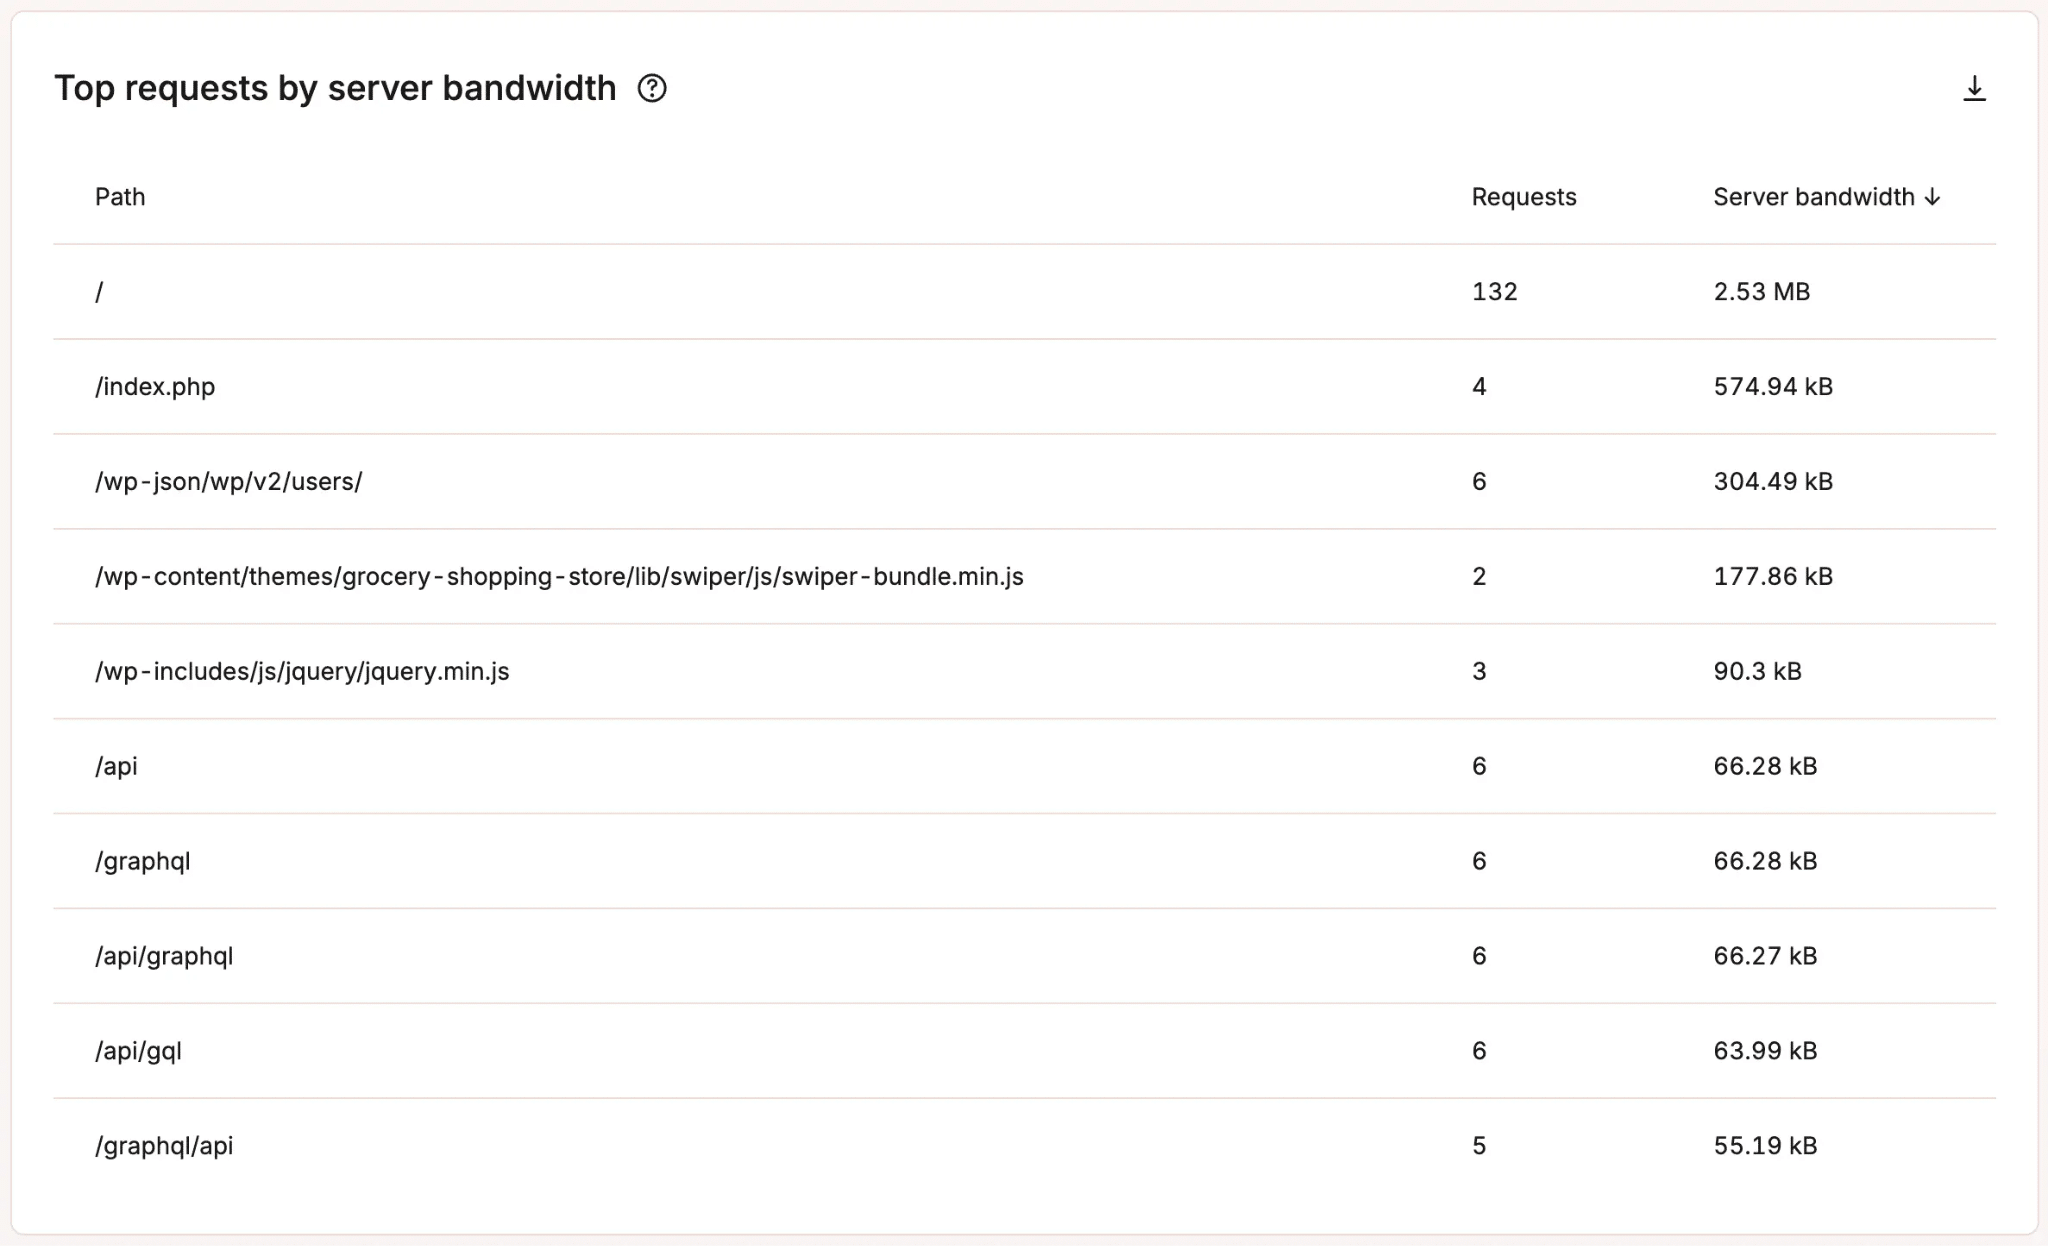
Ver o GPTBot ou outro crawler no topo de um relatório é útil. Ver que milhares de suas solicitações são direcionadas para /blog/ revela uma situação. Ver que elas são direcionadas para resultados de pesquisa ou para uma URL parametrizada do WooCommerce revela outra.
Erro 5: bloquear o crawler e deixar a armadilha de rastreamento
Às vezes, o bot é apenas o elemento que expõe um problema já existente na estrutura de URLs.
Os sites WordPress podem gerar muitas URLs a partir de parâmetros de consulta, páginas de pesquisa, arquivos filtrados, paginação, calendários, variações de produtos e ações de eCommerce.
Uma pessoa pode reconhecer que duas URLs ligeiramente diferentes levam essencialmente à mesma página, enquanto um crawler simplesmente vê mais links para seguir.
Se cada página produzir outro conjunto de URLs que parecem novas, o crawler poderá continuar seguindo-as. É assim que surgem padrões que parecem muito mais agressivos do que qualquer pessoa pretendia.
Observamos isso em nossa pesquisa anterior sobre infraestrutura. Um padrão recorrente se tornou tão grande que uma única regra criada para detectá-lo filtrou 550 milhões de solicitações em 30 dias.
Bloquear o crawler pode interromper a carga imediata, mas não remove o padrão de URL que fez o crawler encontrar novas páginas.
Quando um caminho específico passar repentinamente a dominar o tráfego de crawlers de IA, analise o próprio caminho:
- O WordPress está gerando um grande número de combinações de parâmetros?
- Um crawler consegue continuar avançando indefinidamente por URLs de calendário ou paginação?
- As páginas de pesquisa e filtros estão expondo milhares de variações de URLs?
- URLs de ação, como links para adicionar ao carrinho, podem ser rastreadas sem que isso seja necessário?
- Todas as URLs geradas precisam existir e ser encontradas?
Você ainda pode decidir bloquear o crawler ou aplicar um desafio a ele, mas primeiro entenda o que continuou fazendo com que ele retornasse.
Isso é especialmente importante para agências. Se vários sites de clientes usarem o mesmo plugin, a mesma configuração do WooCommerce, o mesmo tema ou o mesmo padrão de URL, um crawler agressivo poderá expor o mesmo problema em mais de um site. Corrigir esse comportamento pode ser mais útil do que manter uma lista cada vez maior de nomes de bots.
Erro 6: presumir que o robots.txt interrompeu o tráfego
Uma alteração no robots.txt pode ser a resposta adequada quando você deseja instruir um crawler confiável a não acessar parte ou todo o seu site, mas ainda precisa verificar o tráfego depois disso.
O robots.txt depende de o crawler respeitar a instrução e não impede fisicamente que a solicitação chegue ao seu site.
Abordamos essa distinção em detalhes em nosso guia sobre crawlers de IA. O robots.txt comunica preferências de rastreamento, enquanto o llms.txt fornece um índice estruturado de conteúdo para as ferramentas que optarem por consultá-lo. A aplicação das regras ocorre em outro lugar.
Isso é importante após identificar um problema de desempenho, pois apenas editar um arquivo pode transmitir a impressão de que o problema foi resolvido.
Verifique seus registros ou as análises de bots. Se as solicitações do crawler diminuírem após a alteração no robots.txt, você terá evidências de que ela funcionou. Se o tráfego continuar ou você estiver lidando com outro sistema automatizado que não respeite a instrução, será necessário usar um controle de aplicação das regras.
O mesmo se aplica quando o problema é a taxa de solicitações, e não o acesso em si. Um crawler pode ter permissão para consultar seu conteúdo e ainda solicitá-lo em uma taxa que seu site não consegue atender adequadamente.
Erro 7: copiar as regras de firewall de outro site sem verificar o que elas bloqueariam
O exemplo do PatronView é útil porque a resposta do site foi baseada em seus próprios dados.
Seu público está predominantemente na América do Norte, por isso o proprietário aplica desafios ao tráfego proveniente de outros continentes. Ele verificou os dados de visitantes reais antes de aplicar desafios a usuários com versões antigas de navegadores. Ele também monitora quantos visitantes submetidos a desafios realmente conseguem concluí-los. Em determinado período, apenas 0,24% de mais de 100 mil desafios foram resolvidos.
Esses números facilitam a justificativa das regras para esse site, mas aplicar a mesma configuração a uma loja internacional de eCommerce poderia acabar submetendo clientes legítimos a desafios. O mesmo risco surge quando as equipes acumulam várias ferramentas de segurança porque cada uma parece útil por si só.
Um site WordPress pode ter proteção contra bots no nível da hospedagem, regras do Cloudflare, um plugin de segurança, limitação da taxa de solicitações, bloqueios por país e regras personalizadas de WAF, todos atuando sobre a mesma solicitação. Depurar um falso positivo se torna muito mais difícil quando você não sabe qual camada tomou a decisão.
Para clientes da Kinsta, não recomendamos especificamente combinar a Proteção contra Bots da Kinsta com outras camadas personalizadas de proteção contra bots. Classificações conflitantes podem fazer com que visitantes ou integrações legítimas sejam bloqueados.
Níveis de proteção mais altos também podem afetar automações legítimas, como APIs, ferramentas de monitoramento, webhooks e integrações do WordPress. Por isso, o MyKinsta inclui a opção Permitir automações comuns do WordPress e exceções para sempre permitir endereços IP, caminhos e agentes de usuário confiáveis.
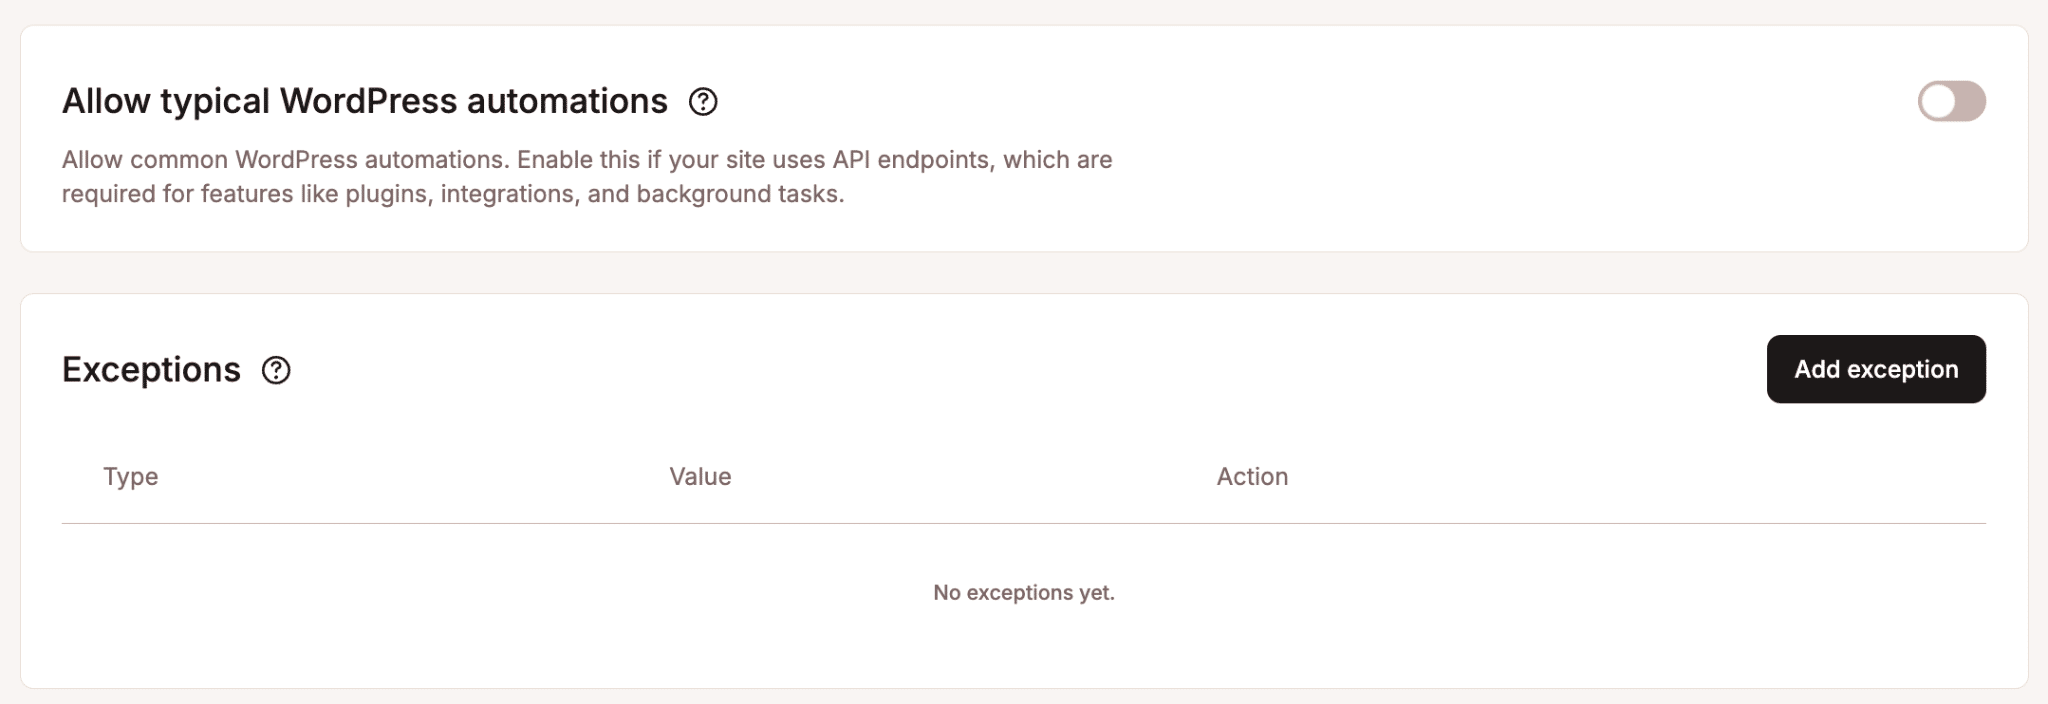
Se você administra uma agência, um processo padrão é mais útil do que um conjunto padrão de regras. Você pode usar o mesmo processo em 20 sites de clientes identificando o tráfego, analisando seus caminhos, verificando o desempenho, escolhendo um controle, testando-o e monitorando o resultado.
O que fazer ao identificar tráfego de bots de IA
Comece pelo que está acontecendo no seu site. Se o tráfego de bots estiver afetando visitantes reais, proteja primeiro o site e, depois, analise o volume de tráfego que você está recebendo, quais caminhos ele acessa e quais sistemas são responsáveis.
A partir daí, escolha a menor alteração que resolva o problema. Isso pode significar atualizar o robots.txt, bloquear um crawler ou aplicar um desafio a ele, corrigir um padrão de URL rastreável ou não fazer nada se o tráfego não estiver causando danos.
Os clientes da Kinsta podem realizar grande parte dessa investigação diretamente no MyKinsta. As análises de tráfego de bots separam crawlers de IA, crawlers de IA com taxas excessivas, bots verificados, tráfego automatizado e outros tipos de solicitações, enquanto Principais origens de tráfego mostra os caminhos, agentes de usuário, países e endereços IP relacionados a eles.
Você também pode comparar essa atividade com o comportamento do cache, a largura de banda do servidor e o desempenho do PHP para verificar se o tráfego está realmente sobrecarregando seu site antes de decidir o que bloquear.