Was den KI-Traffic angeht, gibt es keine durchschnittliche Website
Neue Infrastrukturdaten von mehr als 5.000 WordPress-Seiten zeigen, wie unterschiedlich sich KI-Traffic auf die einzelnen Seiten auswirkt – und was allein schon das Anfragevolumen ausklammert.
Stichprobe
über 5.000 WordPress-Seiten
Zeitraum
Daten der letzten 30 Tage
Quelle
Kinsta-Infrastruktur
Zusammenfassung
KI-Traffic wird oft auf einen Prozentsatz des Web-Traffics reduziert. Unsere Daten zeigen, dass diese Zahl von Website zu Website sehr unterschiedlich ausfallen kann. Auf mehr als 5.000 WordPress-Seiten war die Aktivität von KI-Crawlern gering oder gar nicht vorhanden, während ein viel kleinerer Anteil eine Aktivität verzeichnete, die weit über dem Gesamtdurchschnitt lag.
Der Unterschied lag nicht nur darin, wie viel Traffic ankam, sondern auch darin, was die Website bereitstellen sollte. KI-Crawler forderten weitaus häufiger als menschliche Besucher dynamische, nicht zwischenspeicherbare Inhalte an, wodurch das Anfrageverhalten bei der Bewertung der Auswirkungen auf die Infrastruktur genauso wichtig ist wie das Volumen.
KI verändert auch die Art und Weise, wie Inhalte entdeckt werden. In unserer Verbraucherumfrage gaben 44,7 % der Befragten an, dass sie nach Erhalt einer KI-Empfehlung immer oder meistens die Website eines Unternehmens besuchen, während 61,1 % die Qualität der Website eines Unternehmens mit der Qualität seiner Produkte oder Dienstleistungen in Verbindung bringen.
Da KI bei der Suche eine immer größere Rolle spielt, ist die Website der Ort, an dem die Leute nachsehen, ob die Empfehlung auch stimmt.
Wichtigste Ergebnisse
01. Bandwidth
1,57 %
der Bandbreite entfiel bei der Median-Website auf KI-Bots, verglichen mit 17,8 % im 90. Perzentil und 90,3 % im 99. Perzentil.
02. volume
33-67
AI-Bot-Anfragen gingen täglich bei der Median-Website ein, während der Mittelwert 14–25 Mal höher lag.
03. behavior
77–91 %
der AI-Bot-Anfragen richteten sich auf dynamische oder anderweitig nicht zwischenspeicherbare Inhalte, verglichen mit etwa 18 %–19 % der Anfragen von Menschen.
04. Consumers
44,7 %
der Verbraucher geben an, dass sie nach Erhalt einer KI-Empfehlung immer oder meistens die Website eines Unternehmens besuchen.
05. perception
61,1 %
der Verbraucher verbinden die Qualität der Website eines Unternehmens mit der Qualität seiner Produkte oder Dienstleistungen.
01. Warum eine Zahl auf Netzwerkebene auf der Ebene einer einzelnen Website nicht mehr zutrifft
Der Durchschnitt vermittelt ein falsches Bild
Es ist längst nichts Neues mehr, dass Bots mehr als die Hälfte des Web-Traffics ausmachen. Laut den globalen Daten von Cloudflare liegt das Verhältnis bei Webseitenanfragen derzeit bei 57 % Bots und 43 % Menschen. Zahlen wie diese lassen jeden Website-Betreiber sich fragen, wie viel seines eigenen Traffics noch von Menschen stammt.
Diese Zahl ist auf der von Cloudflare gemessenen Ebene real, und unsere eigenen Daten lagen nahe daran. Bei den WordPress-Seiten in unserer Stichprobe entfielen an einem typischen Tag etwa 54 % auf automatisierten Traffic und 46 % auf menschlichen Traffic.
Ein typischer Tag auf der Kinsta-Flotte
Anteil aller Anfragen an einem typischen Tag, über alle von Kinsta gehosteten Seiten hinweg.
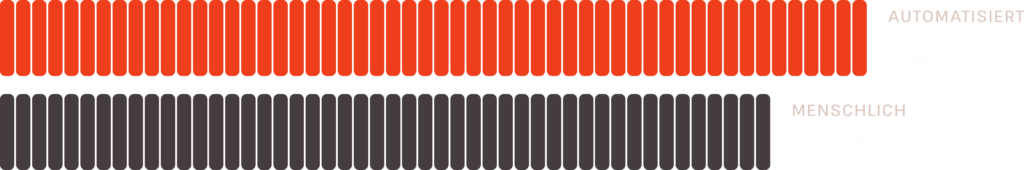
Diese Zahlen gelten auf Netzwerkebene, sind aber irreführend, wenn man sie auf eine einzelne Website anwendet. Wenn Bots für mehr als die Hälfte aller Anfragen im Internet verantwortlich sind, liegt die Vermutung nahe, dass deine eigene Website in etwa dem gleichen Verhältnis entspricht.
Wir haben dieselbe Berechnung für unsere gesamte Infrastruktur durchgeführt. Dann haben wir aufgehört, den Durchschnitt der Websites zu bilden, und festgestellt, dass die mediane Website nur 1,57 % ihrer Bandbreite für KI-Bots aufwendete, wobei mehr als 1.000 Websites gar keinen Traffic durch Bots meldeten.
Diese Erkenntnis warf eine neue Frage auf.
Ein gesamter Prozentsatz kann uns zwar sagen, was im gesamten Netzwerk vor sich geht, gibt einem Website-Betreiber aber keinen Aufschluss darüber, was auf seiner eigenen Website passiert. Und selbst wenn diese Zahl auf Website-Ebene bekannt ist, lässt das Datenverkehrsvolumen noch eine weitere Frage offen: Was verlangen diese Anfragen von der Anwendung?
Auf der Suche nach dieser Antwort hat unser Bericht plötzlich eine neue Richtung eingeschlagen.
02. Der Gesamtwert war korrekt. Die zugrunde liegende Verteilung war jedoch alles andere als gleichmäßig
Ein Web, radikal unterschiedliche Realitäten beim KI-Traffic
Der Durchschnittswert lässt sich immer schwerer rechtfertigen, sobald man sich einzelne Websites ansieht.
Über alle in unserer Analyse berücksichtigten Websites hinweg machten KI-Bots 6,13 % der gesamten Bandbreite aus. Die Median-Website verzeichnete gerade einmal 1,57 %, während mehr als 1.000 der über 5.000 gemessenen Websites gar keinen Anteil verzeichneten. Am anderen Ende der Verteilung machten KI-Bots im 90. Perzentil 17,8 % der Bandbreite aus und im 99. Perzentil sogar 90,3 %.
Ordnet man die Seiten nach absteigendem KI-Traffic, ergibt die Gesamtheit eine Treppe. Jede Stufe ist so breit wie der Anteil der Seiten, den sie abdeckt, und ihre Obergrenze ist ein gemessenes Perzentil. Die vertikale Skala ist logarithmisch – auf einer linearen Skala wäre die Hälfte der Gesamtheit nur ein Haarriss.
Anteil der gesamten Bandbreite, der auf KI-Bots auf 5.168 WordPress-Seiten entfällt, sortiert von am wenigsten bis am meisten
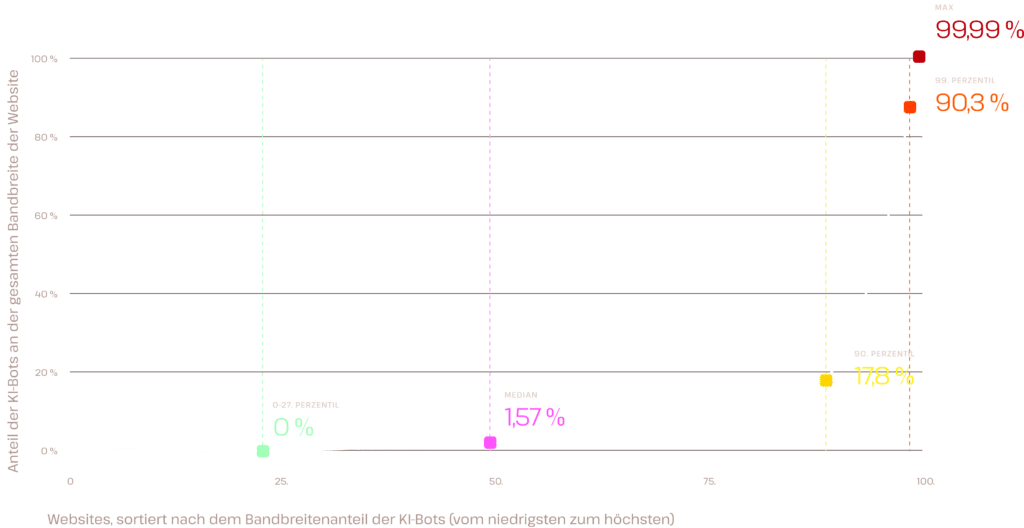
6,13 %
Flotten-Gesamtwert – die eine Zahl, die sich aus dem Durchschnitt ergibt
1,57 %
Median-Website – viermal niedriger als der Gesamtwert
57×
Um wie viel mehr Bandbreite die Website im 99. Perzentil an KI-Bots abgegeben hat als der Median
Die Anzahl der Anfragen zeigte das gleiche unausgewogene Muster: Bei vier Messungen auf Website-Ebene lag der Mittelwert zwischen 667 und 928 KI-Bot-Anfragen pro Website und Tag, während der Median zwischen 33 und 67 lag. Je nach Messung erhielten etwa 20 % bis 27 % der Websites keine KI-Bot-Anfragen.
Deshalb sagt die Aussage „AI-Bots machen 6 % des Traffics aus“ einem Website-Betreiber so gut wie nichts über seine eigene Website aus. Eine Website, die fast keinen AI-Traffic erhält, und eine, bei der der Traffic durch AI-Crawler den Großteil der Aktivität ausmacht, können beide zum gleichen Gesamtprozentsatz beitragen. Infrastrukturentscheidungen müssen daher bei der Website selbst ansetzen.
Das Gleiche gilt für die Identitäten hinter dem Traffic. Die Zusammensetzung der Bots änderte sich während des Messzeitraums: An ruhigeren Tagen waren Meta und Amazon für große Anteile der KI-Crawler-Aktivität verantwortlich, während andere Crawler zu anderen Zeiten an Anteil gewannen. Die Zusammensetzung, die eine bestimmte Website oder einen bestimmten Serverpark erreicht, sollte gemessen und nicht einfach angenommen werden.
Erste Frage
Erste Frage: Wie viel KI-Crawler-Traffic erreicht diese Seite tatsächlich?
Zweite Frage
Zweite Frage: Was passiert, wenn er dort ankommt?
03. Ein Traffic-Bericht zählt jede Anfrage gleich. Server tun das nicht
Was der KI-Traffic von der Website verlangt
It’s no longer news that bots account for more than half of web traffic. Cloudflare’s global data currently puts the split at 57% bots and 43% humans for web page requests. Numbers like this make any site owner wonder how much of their own traffic is still human.A traffic report counts every request the same way, even though some are far more work for the server to handle than others.
Eine Anfrage, die aus dem Cache beantwortet werden kann, und eine, die eine neue, dynamische Antwort erfordert, erscheinen in einem Traffic-Bericht beide als „eine Anfrage“. Das Volumen sagt dir also, wie viel AI-Crawler-Aktivität eine Website erreicht, aber nicht, was passiert, wenn diese Anfragen bearbeitet werden.
Zunächst haben wir geprüft, ob KI-Crawler pro Anfrage mehr Daten übertragen. Bei fünf Messungen machten sie durchschnittlich 6,33 % der Anfragen und 6,42 % der Bandbreite aus, wobei die beiden Werte nie mehr als etwa einen Prozentpunkt voneinander abwichen.
Der größere Unterschied zeigte sich darin, wie diese Anfragen bedient wurden. Im Durchschnitt der drei Messungen wurden 76,3 % der menschlichen Anfragen aus dem Cache bedient, verglichen mit 10,4 % der Anfragen von KI-Crawlern. Bei den gewöhnlichen Cache-Fehltreffern lagen die Werte viel näher beieinander: etwa 3,8 % bei den Menschen und 4,3 % bei den KI-Crawlern.
Der dynamische Traffic machte den größten Teil der Differenz aus. Im Durchschnitt betrafen 84,1 % der Anfragen von KI-Crawlern dynamische Inhalte, verglichen mit 18,6 % der Anfragen von Menschen. Dieses Muster zeigte sich bei allen drei Messungen: Der dynamische Traffic der KI-Crawler lag zwischen 76,9 % und 90,5 %, während der Traffic von Menschen zwischen 18,3 % und 18,9 % blieb.
Chasing that answer is where our report suddenly changed direction.The number is real at the scale Cloudflare measures, and our own data landed close to it. Across the WordPress sites in our sample, a typical day had roughly 54% automated traffic and 46% human traffic.
Was der Server bei jeweils 100 Anfragen tun musste
Gleiche Arbeitsleistung, gegensätzliche Zusammensetzung. Vergleiche die beiden Balken miteinander: Die Form des menschlichen Datenverkehrs ist fast genau umgekehrt.
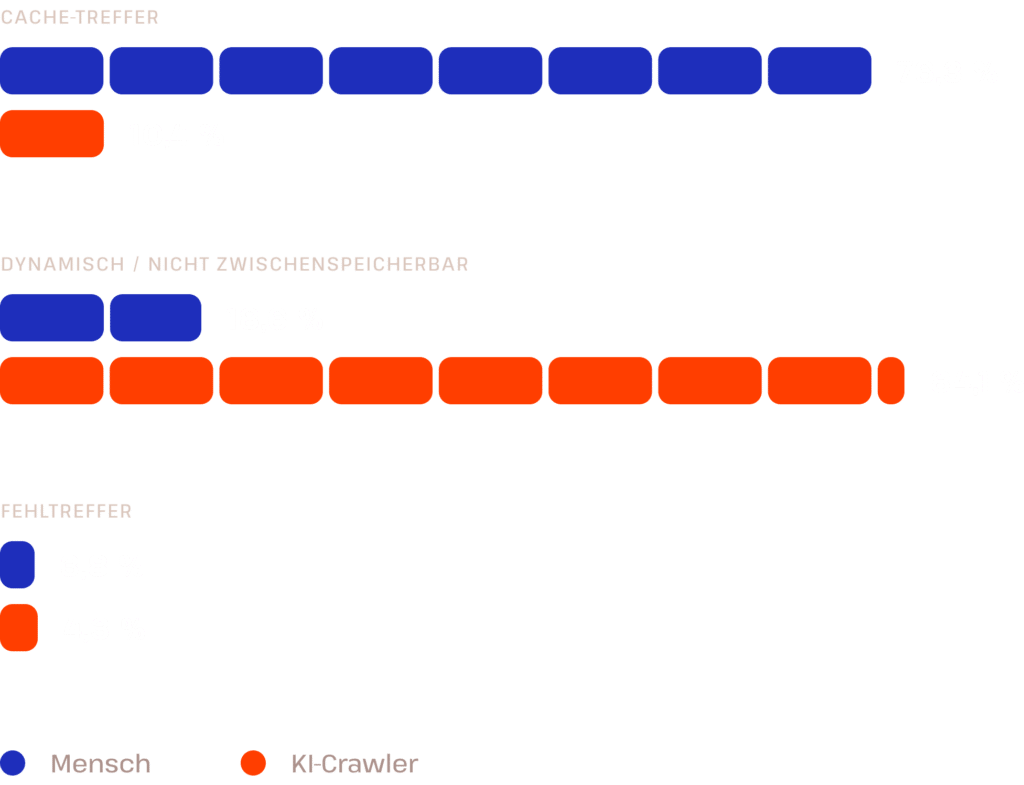
Die Werte sind Durchschnittswerte über drei Messtage
„Die Anzahl der Anfragen sagt dir nur, wie viel Traffic eingegangen ist. Was für die Infrastruktur zählt, ist, wohin diese Anfragen gehen und was die Website tun muss, um sie zu bedienen.“
Daniel Pataki
CTO, Kinsta
Bei WordPress-Websites können dynamische Inhalte Suchergebnisse, gefilterte Listen, Variationen von Abfrage-Strings, Einkaufsaktionen und andere Antworten umfassen, die nicht einfach aus einer vorhandenen zwischengespeicherten Kopie zurückgegeben werden können. In unserem früheren Bericht zum KI-Bot-Traffic haben wir festgestellt, dass ein Crawler innerhalb von 24 Stunden 3,75 Millionen „In den Warenkorb“-Anfragen generierte, während ein anderes sich wiederholendes Muster über einen längeren Zeitraum Hunderte Millionen von Anfragen erzeugte.
Dieses Muster verdeutlicht, warum das Traffic-Volumen allein kein vollständiger Maßstab für KI-Aktivitäten ist. Zwei Websites können einen ähnlichen Anteil an KI-Traffic erhalten, dabei aber sehr unterschiedliche Anforderungen an die Anwendung stellen – je nachdem, wohin diese Anfragen gehen.
Nicht jede Bot-Anfrage ist ein Crawler
„KI-Traffic“ ist ein Sammelbegriff für verschiedene Verhaltensweisen. Manche Systeme crawlen Websites umfassend, während andere Seiten für die Suche oder als Antwort auf eine Nutzeranfrage abrufen. OpenAI, Anthropic und Perplexity verwenden alle für zumindest einige dieser Funktionen separate Identitäten für Crawler und nutzerausgelöste Anfragen.
Diese Unterscheidung ist wichtig, da dieselbe Anzahl an Anfragen sehr unterschiedliche Verhaltensweisen darstellen kann. Ein Crawler, der sich systematisch durch eine Website bewegt, ist nicht dasselbe wie ein Agent, der eine Seite für jemanden abruft, der eine Frage stellt, und Serverprotokolle können zwar das System identifizieren, das die Anfrage stellt, ohne jedoch immer die Absicht dahinter preiszugeben.
111,8 Millionen
Anfragen von KI-Crawlern
8,3 Millionen
KI-Client-Agent-Anfragen im gleichen Zeitraum
Wir haben diesen Unterschied in unseren eigenen Daten festgestellt. Der Assistant-Traffic blieb über den größten Teil des Zeitraums relativ gering, stieg dann aber für kurze Zeit stark an, wobei die Anfragen im Zusammenhang mit Claude, Perplexity und Mistral deutlich schneller zunahmen als der ChatGPT-Traffic.
Für Betreiber lautet die wichtige Erkenntnis: KI-Aktivitäten lassen sich besser nach Typ und Verhalten verstehen als in einer pauschalen Kategorie „KI-Bot”.
04. Server-Logs zeigen nur eine Seite des Weges
Was passiert, nachdem die KI jemanden zu dir weitergeleitet hat
Bisher haben wir in diesem Bericht die Website aus der Sicht des Servers betrachtet, aber Serverprotokolle können nur einen Teil dessen zeigen, was passiert, nachdem die KI in die Customer Journey eingreift.
KI-Systeme stehen zunehmend zwischen den Menschen und den Quellen, die sie früher vielleicht direkt über eine Suche, eine Empfehlung oder einen Link erreicht hätten. Manchmal führt dieser Umweg zu einem Besuch auf der ursprünglichen Website, manchmal aber auch nicht.
Was passiert, wenn die Person doch auf die Seite gelangt?
44,7 %
der Befragten an, dass sie nach Erhalt einer KI-Empfehlung immer oder meistens die Website eines Unternehmens besuchen.
61,1 %
der Befragten an, dass sie die Qualität der Website eines Unternehmens mit der Qualität seiner Produkte oder Dienstleistungen in Verbindung bringen.
Diese Zahl bedeutet nicht, dass 44,7 % des Website-Traffics von KI stammen; sie belegt nicht in jedem Fall einen direkten Verweisweg; und sie beweist nicht, dass diese Besucher eher zu einer Conversion neigen als jemand, der über die Suche oder einen anderen Kanal kommt.
Was sie jedoch zeigt, ist, dass die Unternehmenswebsite nach wie vor wichtig ist. Die Leute besuchen sie immer noch, selbst nachdem die KI ihnen bereits gesagt hat, was sie dort erwartet.
Diese beiden Erkenntnisse verändern die Art und Weise, wie wir Infrastrukturdaten interpretieren sollten. KI-Systeme können auf eine Website zugreifen, bevor eine Person sie überhaupt sieht. Die Person, die schließlich auf die Seite gelangt, hat sich möglicherweise bereits anderswo eine Empfehlung, eine Zusammenfassung oder einen Eindruck gebildet. Ihr Besuch kann daher einem anderen Zweck dienen als der erste Klick zur Entdeckung, um den herum Websites traditionell konzipiert wurden.
Möglicherweise will sie bestätigen, dass das Unternehmen existiert, eine Behauptung überprüfen, Preise vergleichen, Produktdetails untersuchen, Alternativen abwägen oder entscheiden, ob die Empfehlung ihr Vertrauen verdient.
Die Website muss dennoch überzeugen, wenn dieser Moment kommt.
„KI mag zwar verändern, wie Menschen auf eine Website gelangen, aber am Ende einer langen Kette steht immer ein Mensch, der Informationen anfordert.”
Daniel Pataki
CTO, Kinsta
Für technische Teams werden Zuverlässigkeit und Reaktionsfähigkeit zu noch entscheidenderen Bestandteilen des gesamten Geschäftserlebnisses. Und für Marketingfachleute und Markeninhaber hat die KI-basierte Entdeckung die zugrunde liegende Infrastruktur der Website nicht aus der Customer Journey verdrängt.
Beide Seiten treffen im selben System aufeinander.
KI-Systeme fordern die Inhalte an.
Menschen beurteilen, was sie erwartet.
Da beide Zielgruppen auf derselben Website zusammenkommen, ist das Verständnis eures eigenen Traffics der logische nächste Schritt.
05. Position, Muster, Profil – drei Fragen, die du dir in Bezug auf deine eigene Website stellen solltest.
Eine KI-Traffic-Analyse auf Website-Ebene
Die Ergebnisse dieses Berichts zeigen einen einfachen Weg auf, den KI-Traffic für eine einzelne Website zu bewerten. Anstatt vom Branchendurchschnitt auszugehen, solltest du drei Dinge betrachten: Wie viel KI-Traffic du erhältst, was diese Anfragen bewirken und wer oder was dahintersteckt.
„KI-Traffic erfordert nicht auf jeder Website die gleiche Reaktion. Die richtige Entscheidung beginnt damit, zu verstehen, was tatsächlich auf deine Website gelangt und ob es ein Problem verursacht.“
Daniel Pataki
CTO, Kinsta
01. Ausgangslage
Wie viel KI-Traffic erhältst du tatsächlich?
Beginne mit deiner eigenen Basislinie über einen aussagekräftigen Zeitraum. Schau dir die Anfragen von KI-Crawlern und die Bandbreitennutzung an und vergleiche sie dann mit der Verteilung in dieser Studie, statt nur mit dem flottenweiten Durchschnitt.
In unserer Bandbreitenanalyse lag der Median bei 1,57 %, das 90. Perzentil bei 17,8 % und das 99. Perzentil bei 90,3 %. Was die Anfragen betrifft, so erhielten etwa 20 % bis 27 % der Websites an einem bestimmten Messtag überhaupt keine Anfragen von KI-Crawlern.
Es geht nicht darum, jeder Website einen festen Perzentilwert zuzuweisen, sondern festzustellen, ob dein eigener KI-Traffic relativ gering ist, im mittleren Bereich der Verteilung liegt oder sich eher am oberen Ende konzentriert.
02. Muster
Was verlangen diese Anfragen von der Website?
Du musst dir ansehen, wohin KI-Crawler gehen: die von ihnen angeforderten Pfade, wiederkehrende URL-Muster, Abfrageparameter, Such- und Filterseiten, Einkaufsaktionen und andere dynamische Routen.
Unsere Daten zeigten, warum das wichtig ist. Bei drei Messungen gingen 76,9 % bis 90,5 % der Anfragen von KI-Crawlern an dynamische Inhalte, verglichen mit etwa 18 % bis 19 % der menschlichen Anfragen.
Eine Website, die eine moderate Menge an KI-Traffic erhält, der hauptsächlich auf zwischengespeicherte Seiten abzielt, weist ein anderes Infrastrukturbild auf als eine Website, die das gleiche Volumen auf dynamische Routen erhält.
03. Profil
Wer oder was steckt hinter diesen Anfragen?
Trenne den Traffic schließlich, wo immer möglich. Ein Crawler, der sich allgemein durch eine Website bewegt, unterscheidet sich von einem benutzergesteuerten Agenten, der eine Seite für eine bestimmte Aufgabe abruft, und aggressive Automatisierung erfordert möglicherweise eine andere Reaktion als bei beiden.
Eine perfekte Klassifizierung ist nicht das Ziel. Die entscheidende Frage ist, ob die Quelle und das Verhalten des Datenverkehrs erklären, was du beobachtest, und ob irgendetwas eine genauere Untersuchung rechtfertigt.
Position, Muster und Profil ergeben zusammen ein Bild auf Website-Ebene, das ein branchenweiter Prozentsatz nicht offenbart. Eine Website mit wenig KI-Traffic und normalem Anfrageverhalten erfordert möglicherweise keine weitere Beachtung. Eine Website am oberen Ende der Verteilung, bei der Crawler wiederholt dynamische Routen aufrufen, verdient einen genaueren Blick.
conclusion
Was zählt, ist, was auf deiner Website passiert
KI-Traffic wirkt sich nicht auf jede Website gleich aus. Ein flottenweiter Prozentsatz kann zwar beschreiben, was auf Tausenden von Websites passiert, sagt aber dennoch fast nichts über deine eigene aus.
Die gleiche Ungleichmäßigkeit gilt auch dafür, was diese Anfragen von der Website verlangen. KI-Crawler haben in unserer Stichprobe nicht unverhältnismäßig mehr Bandbreite verbraucht, aber sie haben weitaus häufiger als menschliche Besucher dynamische Inhalte angefordert. Wohin diese Anfragen gehen und wie die Website sie bedienen muss, ist genauso wichtig wie die Anzahl der Anfragen.
Keine dieser Infrastrukturkosten würde eine Rolle spielen, wenn niemand die Seite besuchen würde. Aber die Leute tun es trotzdem. Viele Verbraucher besuchen nach Erhalt einer KI-Empfehlung immer noch die Website eines Unternehmens, und was sie dort vorfinden, prägt ihre Meinung über das Unternehmen. Die Website steht zunehmend an beiden Enden dieser Customer Journey: Sie liefert Informationen, auf die KI-Systeme zugreifen können, und bietet ein Erlebnis, das die Menschen selbst bewerten können.
Für Website-Besitzer und -Betreiber sind Branchendurchschnitte ein nützlicher Kontext, aber die entscheidenden Entscheidungen müssen bei eurem eigenen Traffic ansetzen. Wie viel KI-Aktivität erreicht eure Website, was bewirken diese Anfragen und wer oder was steckt dahinter? Das sind die Fragen, die eine weitreichende Veränderung im Web in etwas verwandeln, das ihr tatsächlich messen und steuern könnt.
Die Maßnahme
Fang mit deiner eigenen Website an
Branchendurchschnitte können das Ausmaß des KI-Traffics aufzeigen, sagen aber nichts darüber aus, was auf einer einzelnen Website passiert. Miss, wie viel KI-Traffic deine Website erreicht, schau dir an, wohin diese Anfragen gehen, und identifiziere nach Möglichkeit die Quellen dahinter. Entscheide dann, ob deine Ergebnisse eine Überwachung, Optimierung oder ein Eingreifen erfordern.
Umfang
Wie viel davon erreicht dich?
Verhalten
Was machen diese Anfragen?
Profil
Wer oder was steckt dahinter?
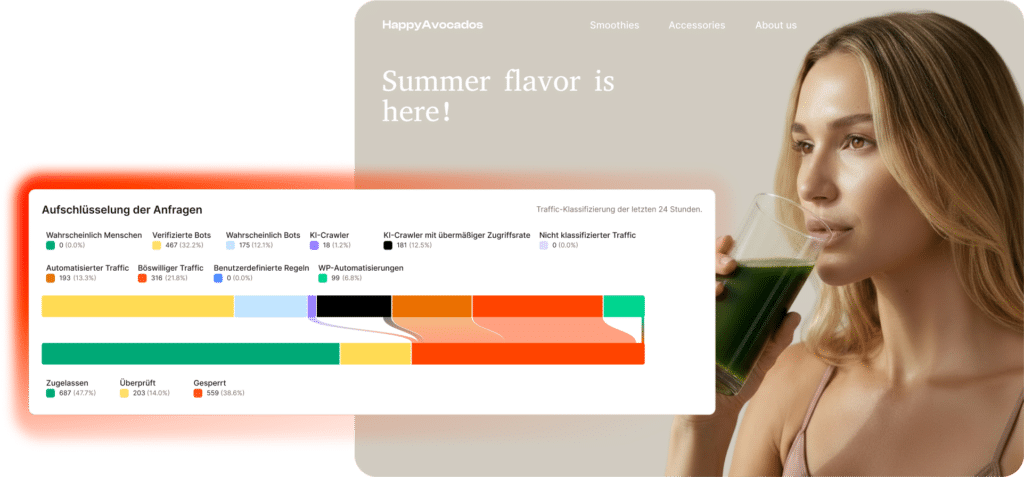
Seht euch an, wie sich der Bot-Traffic auf eurer Website darstellt
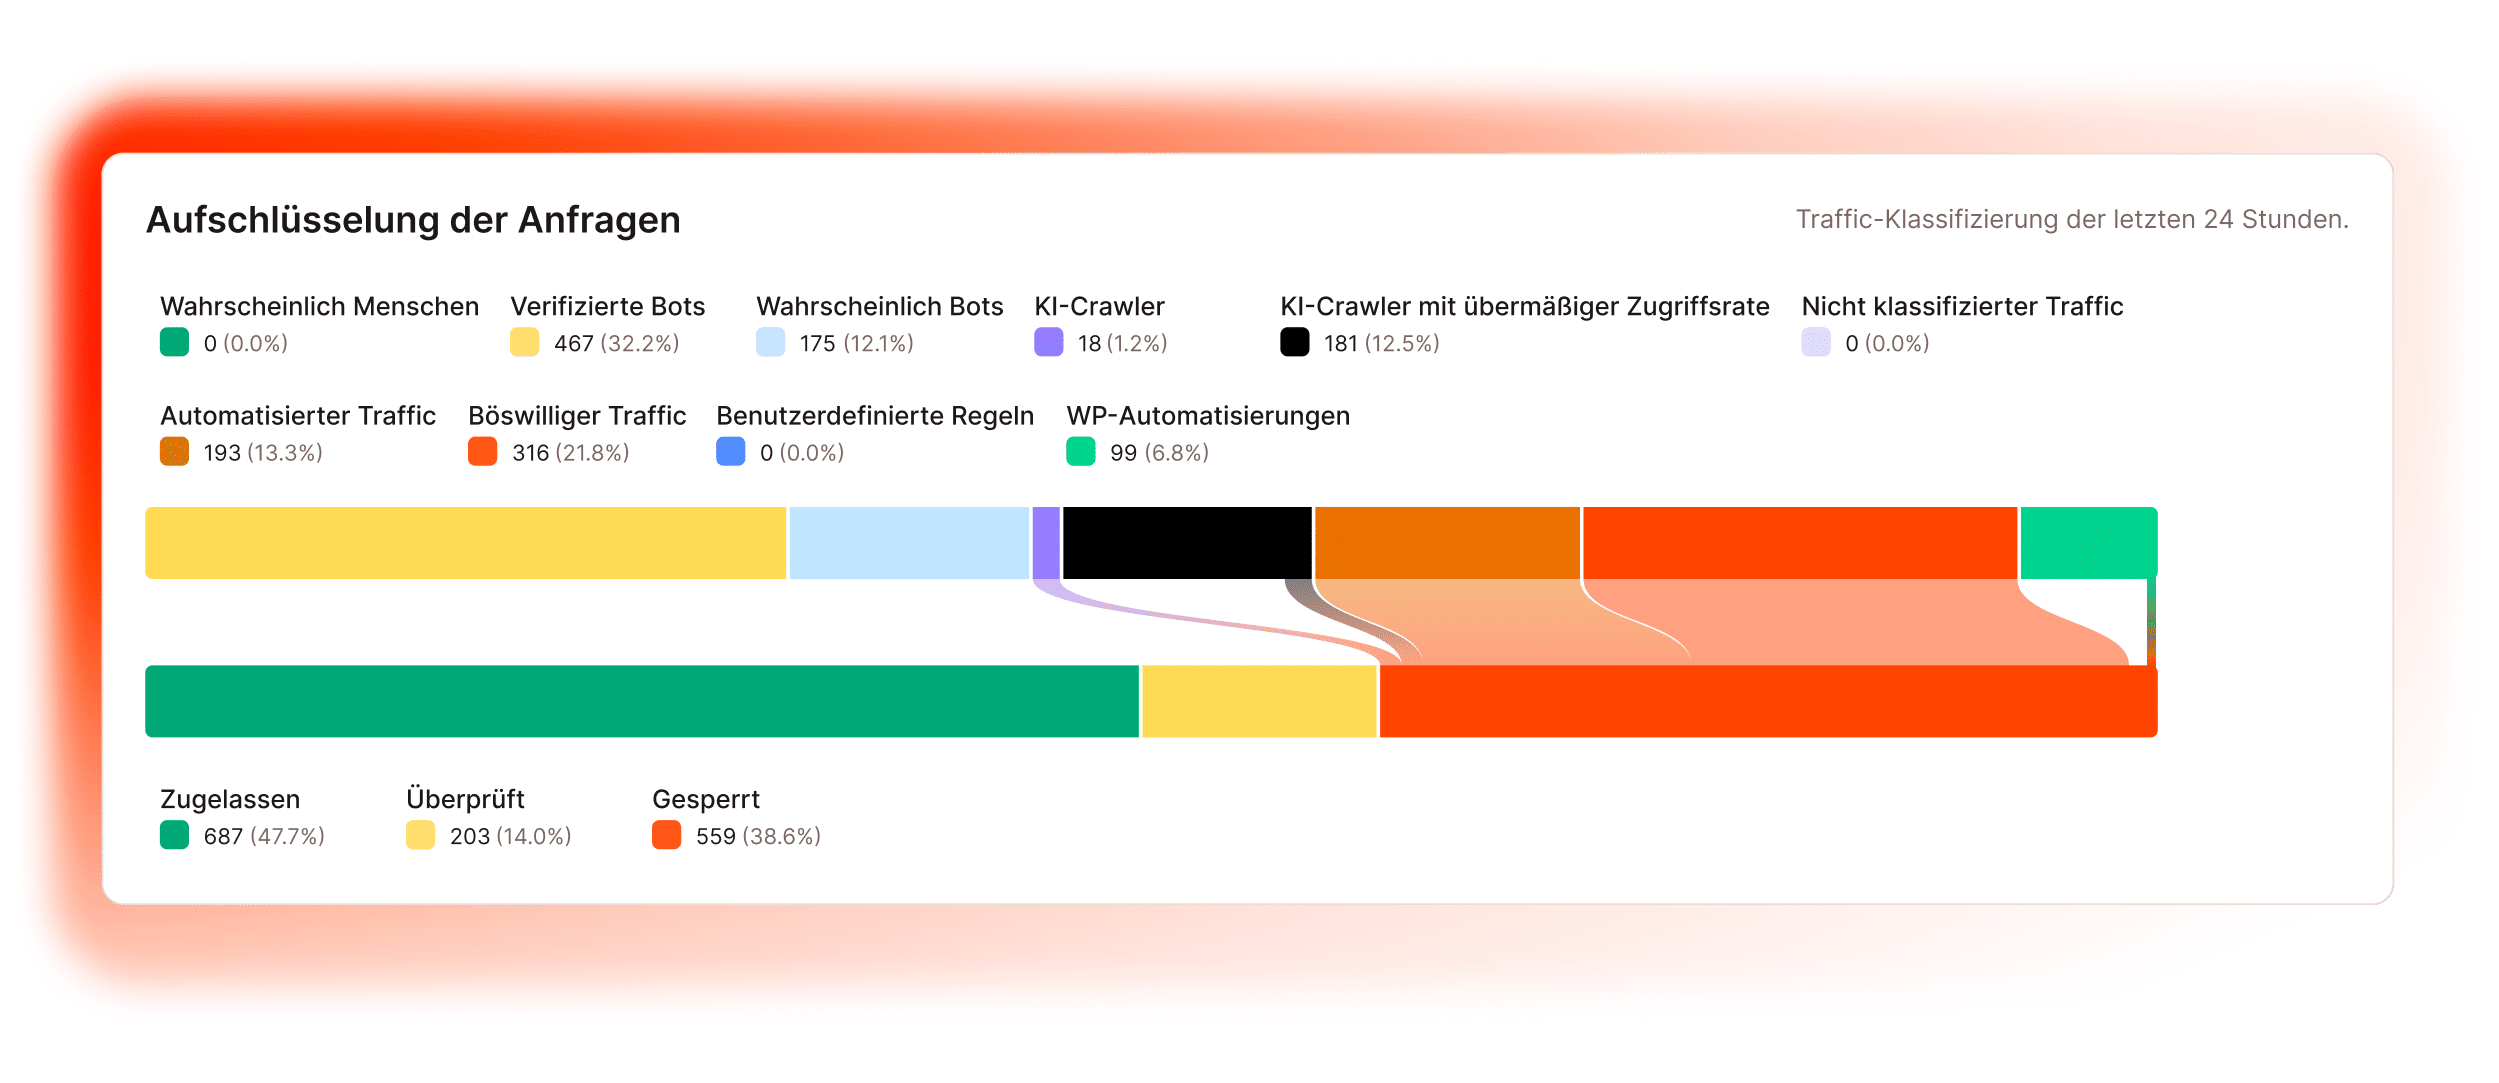
Dieser Bericht wurde dir von Kinsta präsentiert.
Kinsta ist eine Managed-Hosting-Plattform für WordPress, die weltweit 230.000+ Kunden betreut. Unsere Infrastruktur ermöglicht uns einen einzigartigen Einblick darin, wie Websites durch den zunehmenden automatisierten Traffic aufgerufen, bereitgestellt und verändert werden.