En matière de trafic généré par l’IA, il n’existe pas de site web « moyen »
De nouvelles données d’infrastructure issues de plus de 5000 sites WordPress montrent à quel point le trafic généré par l’IA affecte différemment chaque site, et ce que le volume de requêtes à lui seul ne permet pas de cerner
Échantillon
plus de 5000 sites WordPress
Période d’analyse
30 jours de données de requêtes
source
infrastructure Kinsta
Résumé
Le trafic généré par l’IA est souvent réduit à un simple pourcentage du trafic web. Nos données montrent que ce chiffre peut varier considérablement d’un site web à l’autre. Sur plus de 5000 sites WordPress, l’activité des robots d’indexation basés sur l’IA était faible, voire inexistante, tandis qu’une part bien plus restreinte affichait une activité largement supérieure à la moyenne.
La différence ne résidait pas seulement dans le volume de trafic généré, mais également dans la nature des contenus demandés au site. Les robots d’IA étaient bien plus enclins que les visiteurs humains à demander du contenu dynamique et non mise en cache, ce qui rend le comportement des requêtes tout aussi important que leur volume lors de l’évaluation de l’impact sur l’infrastructure.
L’IA modifie également la manière dont les utilisateurs découvrent les sites. Dans notre étude auprès des consommateurs, 44,7 % des personnes interrogées ont déclaré qu’elles se rendaient toujours ou la plupart du temps sur le site web d’une entreprise après avoir reçu une recommandation de l’IA, tandis que 61,1 % associent la qualité du site web d’une entreprise à celle de ses produits ou services.
À mesure que l’IA joue un rôle croissant dans la découverte de contenu, le site web devient le lieu où l’on vérifie la pertinence d’une recommandation.
Key findings
01. Bandwidth
1,57%
de la bande passante d’un site médian était consacrée aux robots IA, contre 17,8 % au 90e centile et 90,3 % au 99e centile.
02. volume
33-67
de requêtes provenant de robots IA ont été enregistrées par jour sur le site médian, tandis que la moyenne était de 14 à 25 fois supérieure.
03. behavior
77% à 91%
des requêtes des robots IA concernaient du contenu dynamique ou ne pouvant être mis en cache, contre environ 18 % à 19 % des requêtes humaines.
04. Consumers
44,7%
des consommateurs déclarent qu’ils visitent toujours ou la plupart du temps le site web d’une entreprise après avoir reçu une recommandation de l’IA.
05. perception
61,1%
des consommateurs associent la qualité du site web d’une entreprise à celle de ses produits ou services.
01. Why a network-scale number breaks down at the level of a single site.
La moyenne ne reflète pas la réalité
Ce n’est plus une nouveauté : les robots représentent plus de la moitié du trafic web. Les données mondiales de Cloudflare indiquent actuellement que, pour les requêtes de pages web, la répartition est de 57 % de robots et 43 % d’humains. De tels chiffres amènent tout propriétaire de site à se demander quelle part de son propre trafic est encore humaine.
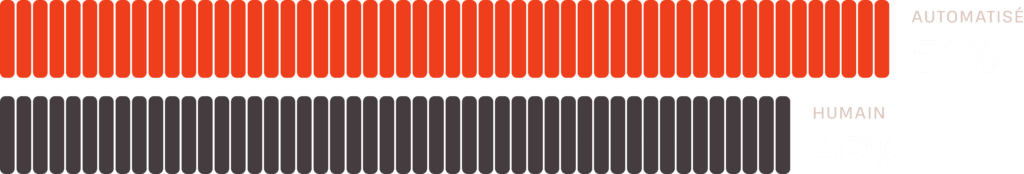
Ce chiffre est réel à l’échelle mesurée par Cloudflare, et nos propres données s’en rapprochent. Sur l’ensemble des sites WordPress de notre échantillon, une journée type comptait environ 54 % de trafic automatisé et 46 % de trafic humain.
One typical day on the kinsta fleet
Share of all requests on a typical day, across Kinsta’s hosted sites
Ces chiffres sont valables à l’échelle du réseau, mais deviennent trompeurs lorsqu’ils sont appliqués à un site individuel. Lorsque les robots sont à l’origine de plus de la moitié des requêtes sur Internet, il est facile de supposer que votre propre site présenterait une répartition similaire.
Nous avons effectué le même calcul sur l’ensemble de notre infrastructure. Nous avons ensuite cessé de calculer la moyenne des sites et avons constaté que le site médian ne consacrait que 1,57 % de sa bande passante aux robots IA, plus de 1 000 sites n’en signalant aucun.
Cette découverte a soulevé une nouvelle question.
Un pourcentage à l’échelle de l’ensemble du parc peut nous indiquer ce qui se passe sur l’ensemble d’un réseau, mais ne permet pas au propriétaire d’un site de savoir ce qui se passe sur son site. Et même une fois que ce chiffre au niveau du site est connu, le volume de trafic laisse encore une autre question sans réponse : que demandent ces requêtes à l’application ?
C’est en cherchant cette réponse que notre rapport a soudainement changé de cap.
02. The aggregate was accurate. The distribution underneath it was not even close to even.
Un seul Web, des réalités radicalement différentes en matière de trafic IA
La moyenne devient plus difficile à défendre dès lors que l’on examine les sites individuellement.
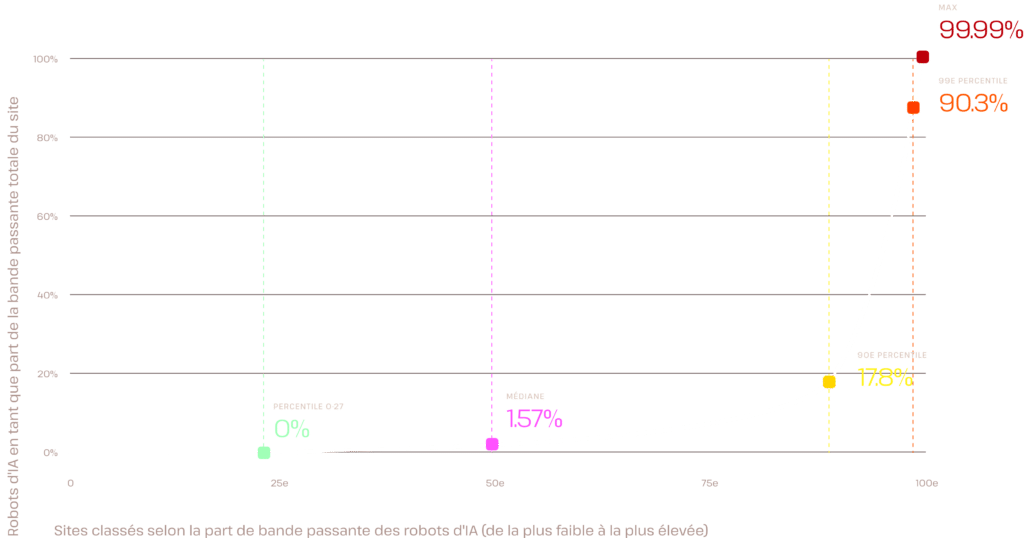
Parmi les sites analysés, les robots IA représentaient 6,13 % de la bande passante totale. Le site médian n’en enregistrait que 1,57 %, tandis que plus de 1000 des quelque 5000 sites mesurés n’en enregistraient aucun. À l’autre extrémité de la distribution, les robots IA représentaient 17,8 % de la bande passante au 90e centile et 90,3 % au 99e centile.
En classant les sites du moins au plus exposé au trafic d’IA, l’ensemble du parc forme un escalier. La largeur de chaque marche correspond à la proportion de sites qu’elle représente, et sa hauteur correspond à un centile mesuré. L’échelle verticale est logarithmique ; sur une échelle linéaire, la moitié du parc apparaîtrait comme un simple trait fin.
Part de la bande passante totale attribuée aux robots d’IA sur 5168 sites WordPress, classés du plus faible au plus élevé
6,13%
Moyenne globale du parc (chiffre unique résultant du calcul de la moyenne)
1,57%
Site médian (quatre fois inférieur à la moyenne globale)
57×
Rapport de bande passante consommée par les robots d’IA entre le site situé au 99e centile et le site médian
Le nombre de requêtes présentait la même répartition déséquilibrée : sur quatre mesures au niveau des sites, la moyenne variait de 667 à 928 requêtes de robots IA par site et par jour, tandis que la médiane variait de 33 à 67. Selon la mesure, environ 20 % à 27 % des sites ne recevaient aucune requête de robots IA.
C’est pourquoi l’affirmation « les robots IA représentent 6 % du trafic » ne dit pratiquement rien au propriétaire d’un site sur son propre site. Un site ne recevant pratiquement aucun trafic provenant de l’IA et un site où le trafic des robots d’exploration IA représente la majeure partie de l’activité peuvent tous deux contribuer au même pourcentage global. Les décisions en matière d’infrastructure doivent donc partir du site lui-même.
Il en va de même pour les entités à l’origine du trafic. La composition des robots a évolué au cours de la période de mesure : Meta et Amazon représentaient une part importante de l’activité des robots d’exploration IA lors des journées plus calmes, tandis que d’autres robots gagnaient en part de marché à d’autres moments. La composition du trafic atteignant un site ou un parc de serveurs donné doit être mesurée, et non supposée.
Première question
quel volume de trafic provenant de robots d’IA atteint réellement ce site ?
Deuxième question
que se passe-t-il une fois arrivés sur le site ?
03. A traffic report counts every request the same way. Servers don’t
Ce que le trafic IA demande au site de faire
Ce n’est plus un secret : les robots représentent plus de la moitié du trafic web. Les données mondiales de Cloudflare indiquent actuellement une répartition de 57 % de robots et 43 % d’humains pour les requêtes de pages web. De tels chiffres amènent tout propriétaire de site à se demander quelle part de son propre trafic provient réellement d’humains. Un rapport de trafic comptabilise chaque requête de la même manière, alors même que certaines exigent du serveur un effort bien plus important que d’autres.
Une requête pouvant être traitée à partir du cache et une autre nécessitant une réponse dynamique générée à la volée apparaissent toutes deux comme « une seule requête » dans un rapport de trafic. Le volume vous indique donc l’ampleur de l’activité des robots d’indexation basés sur l’IA atteignant un site, mais pas ce qui se passe lorsque ces requêtes sont traitées.
Nous avons tout d’abord cherché à déterminer si les robots d’indexation basés sur l’IA transféraient davantage de données par requête. Sur cinq mesures, ils représentaient en moyenne 6,33 % des requêtes et 6,42 % de la bande passante, ces deux chiffres ne s’écartant jamais de plus d’un point de pourcentage environ.
La différence la plus marquée concernait la manière dont ces requêtes étaient traitées. En moyenne sur trois mesures, 76,3 % des requêtes humaines étaient servies à partir du cache, contre 10,4 % des requêtes des robots d’indexation basés sur l’IA. Les échecs de mise en cache ordinaires étaient beaucoup plus proches, s’élevant à environ 3,8 % pour les humains et 4,3 % pour les robots d’indexation basés sur l’IA.
Le trafic dynamique expliquait l’essentiel de cet écart. En moyenne, 84,1 % des requêtes des robots d’indexation alimentaient du contenu dynamique, contre 18,6 % des requêtes humaines. Cette tendance s’est confirmée lors des trois mesures, le trafic dynamique des robots d’indexation variant entre 76,9 % et 90,5 %, tandis que le trafic humain restait compris entre 18,3 % et 18,9 %. C’est en cherchant à répondre à cette question que notre rapport a soudainement pris une nouvelle direction. Ce chiffre est avéré à l’échelle des mesures effectuées par Cloudflare, et nos propres données ont abouti à un résultat similaire. Pour les sites WordPress de notre échantillon, une journée type enregistrait environ 54 % de trafic automatisé et 46 % de trafic humain.
Ce que le serveur a dû exécuter pour chaque tranche de 100 requêtes
Même unité de travail, composition opposée. Comparez les deux barres : la répartition du trafic humain est presque exactement l’inverse de celle du trafic d’IA.
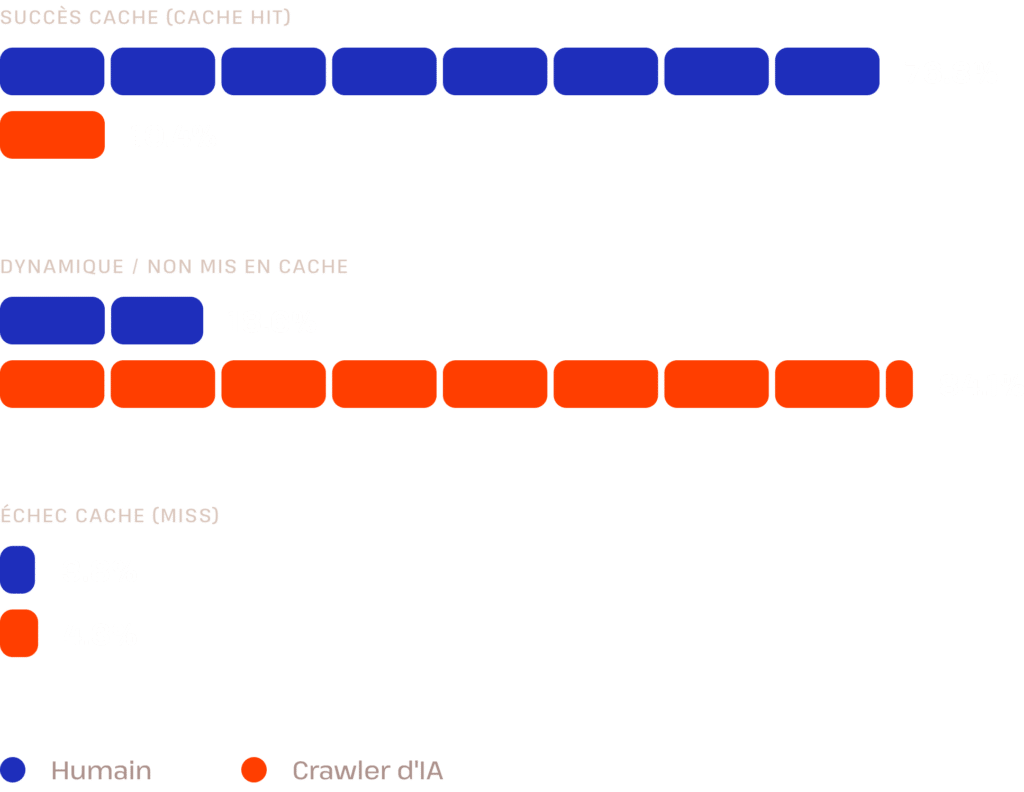
Les valeurs représentent des moyennes calculées sur trois jours d’observation.
« Le nombre de requêtes ne vous indique que le volume de trafic reçu. Ce qui importe pour l’infrastructure, c’est la destination de ces requêtes et ce que le site doit faire pour y répondre. »
Daniel Pataki
directeur technique, Kinsta
Pour les sites WordPress, le contenu dynamique peut inclure des résultats de recherche, des listes filtrées, des variations de chaînes de requête, des actions d’achat et d’autres réponses qui ne peuvent pas être simplement renvoyées à partir d’une copie mise en cache existante. Dans notre précédent rapport sur le trafic des robots IA, nous avions noté qu’un robot d’indexation avait généré 3,75 millions de requêtes « Ajouter au panier » en 24 heures, tandis qu’un autre schéma en boucle avait produit des centaines de millions de requêtes sur une période plus longue.
Ce schéma permet d’expliquer pourquoi le volume de trafic à lui seul ne constitue pas une mesure complète de l’activité des IA. Deux sites peuvent recevoir une part similaire de trafic provenant d’IA tout en imposant des contraintes très différentes à l’application, selon la destination de ces requêtes.
Toutes les requêtes de robot ne proviennent pas d’un robot d’indexation
Le terme « trafic IA » recouvre en réalité plusieurs comportements différents. Certains systèmes explorent les sites de manière générale, tandis que d’autres récupèrent des pages à des fins de recherche ou en réponse à une requête d’utilisateur. OpenAI, Anthropic et Perplexity utilisent tous des identités distinctes pour les robots d’indexation et les requêtes déclenchées par les utilisateurs, au moins pour certaines de ces fonctions.
Cette distinction est importante, car un même nombre de requêtes peut correspondre à des comportements très différents. Un robot d’indexation parcourant systématiquement un site n’est pas comparable à un agent récupérant une page pour une personne posant une question, et les journaux du serveur peuvent identifier le système à l’origine de la requête sans toujours révéler l’intention qui la sous-tend.
111.8M
Requêtes des robots d’exploration (crawlers) d’IA sur 30 jours
8.3M
Requêtes des agents clients d’IA sur la même période
Nous avons constaté cette distinction dans nos propres données. Le trafic lié aux assistants est resté relativement faible pendant la majeure partie de la période, puis a connu une forte hausse pendant une courte période, les requêtes associées à Claude, Perplexity et Mistral augmentant beaucoup plus rapidement que le trafic lié à ChatGPT.
Pour les opérateurs, l’enseignement utile à retenir est que l’activité de l’IA s’appréhende mieux par type et par comportement que sous la forme d’une vaste catégorie unique de « robots IA ».
04. Server logs only show one side of the journey.
Que se passe-t-il une fois que l’IA vous a envoyé un visiteur ?
Jusqu’à présent, dans ce rapport, nous avons examiné le site web du point de vue du serveur, mais les journaux de serveur ne peuvent montrer qu’une partie de ce qui se passe une fois que l’IA intervient dans le parcours.
Les systèmes d’IA s’interposent de plus en plus entre les utilisateurs et les sources auxquelles ils auraient autrefois pu accéder directement via une recherche, une recommandation ou un lien. Parfois, ce détour conduit à une visite sur le site web d’origine ; parfois non.
Que se passe-t-il lorsque la personne arrive effectivement sur le site ?
44,7%
des personnes interrogées ont déclaré qu’elles visitaient toujours ou la plupart du temps le site web d’une entreprise après avoir reçu une recommandation de l’IA.
61,1%
des personnes interrogées ont déclaré associer la qualité du site web d’une entreprise à celle de ses produits ou services.
Ce chiffre ne signifie pas que 44,7 % du trafic du site web provient de l’IA ; il n’établit pas de parcours de référence direct dans tous les cas ; et il ne prouve pas que ces visiteurs soient plus susceptibles de se convertir que ceux arrivant par le biais d’un moteur de recherche ou d’un autre canal.
Ce qu’il montre, en revanche, c’est que le site web de l’entreprise reste important. Les internautes continuent de le consulter, même après que l’IA leur a déjà indiqué ce qu’ils peuvent y trouver.
Ces deux constatations modifient la manière dont nous devons interpréter les données d’infrastructure. Les systèmes d’IA peuvent accéder à un site web avant même qu’une personne ne le consulte. La personne qui finit par y accéder peut déjà avoir une recommandation, un résumé ou une impression formée ailleurs. Sa visite peut donc répondre à un objectif différent de celui du premier clic de découverte, autour duquel les sites web ont traditionnellement été conçus.
Il peut s’agir de confirmer l’existence de l’entreprise, de vérifier une affirmation, de consulter les tarifs, d’examiner les détails d’un produit, de comparer des alternatives ou de décider si la recommandation mérite sa confiance.
Le site web doit tout de même être performant lorsque ce moment arrive.
« L’IA pourrait modifier la manière dont les gens accèdent à un site web, mais au bout de la chaîne, c’est un être humain qui recherche des informations. »
Daniel Pataki
directeur technique, Kinsta
Pour les équipes techniques, la fiabilité et la réactivité deviennent des éléments encore plus cruciaux de l’expérience client globale. Quant aux spécialistes du marketing et aux responsables de marque, la découverte via l’IA n’a pas supprimé l’infrastructure sous-jacente du site web du parcours client.
Les deux parties se rejoignent sur le même système.
Les systèmes d’IA demandent le contenu.
Les utilisateurs jugent ce qui les attend.
Alors que ces deux publics convergent vers le même site, comprendre votre propre trafic constitue l’étape pratique suivante.
04. Position, pattern, profile — three questions to run against your own site.
Un diagnostic du trafic généré par l’IA au niveau du site
Les conclusions de ce rapport mettent en évidence une méthode simple pour évaluer le trafic généré par l’IA sur un site donné. Plutôt que de partir d’une moyenne sectorielle, examinez trois éléments : le volume de trafic généré par l’IA que vous recevez, la nature de ces requêtes et qui ou quoi se cache derrière elles.
« Le trafic IA ne nécessite pas la même réponse sur tous les sites. Pour prendre la bonne décision, il faut d’abord comprendre ce qui atteint réellement votre site et déterminer si cela pose un problème. »
directeur technique, Kinsta
CTO at Kinsta
01. Volume
Quel volume de trafic généré par l’IA recevez-vous réellement ?
Commencez par établir votre propre référence sur une période significative. Examinez les requêtes des robots d’IA et la bande passante, puis comparez-les à la répartition présentée dans cette étude plutôt qu’à la seule moyenne de l’ensemble du parc.
Dans notre analyse de la bande passante, la médiane des sites s’élevait à 1,57 %, le 90e centile à 17,8 % et le 99e centile à 90,3 %. Du côté des requêtes, environ 20 % à 27 % des sites n’ont reçu aucune requête provenant de robots d’indexation basés sur l’IA au cours d’une journée donnée de mesure.
L’objectif n’est pas d’attribuer un percentile définitif à chaque site, mais de déterminer si votre propre trafic généré par l’IA est relativement limité, s’il se situe dans la moyenne de la distribution ou s’il se concentre vers le haut de celle-ci.
02. Modèle
Que demandent ces requêtes au site ?
Vous devez examiner où se rendent les robots d’indexation IA : les chemins qu’ils sollicitent, les modèles d’URL récurrents, les paramètres de requête, les pages de recherche et de filtrage, les actions d’achat et autres parcours dynamiques.
Nos données ont montré pourquoi cela est important. Sur trois mesures, 76,9 % à 90,5 % des requêtes des robots d’indexation IA concernaient du contenu dynamique, contre environ 18 % à 19 % des requêtes humaines.
Un site recevant un trafic d’IA modéré, principalement dirigé vers des pages mises en cache, présente une infrastructure différente de celle d’un site recevant le même volume de trafic vers des routes dynamiques.
03. Profil
Qui ou quoi se cache derrière ces requêtes ?
Enfin, distinguez le trafic dans la mesure du possible. Un robot d’indexation parcourant largement un site est différent d’un agent déclenché par un utilisateur qui récupère une page pour une tâche spécifique, et une automatisation agressive peut nécessiter une réponse différente de celle nécessaire pour l’un ou l’autre.
L’objectif n’est pas d’obtenir une classification parfaite. La question pertinente est de savoir si la source et le comportement du trafic expliquent ce que vous observez et si certains éléments justifient une analyse plus approfondie.
La position, le schéma et le profil constituent ensemble une vue d’ensemble au niveau du site qu’un pourcentage à l’échelle du secteur ne révèle pas. Un site présentant peu de trafic lié à l’IA et un comportement de requêtes ordinaire ne nécessite peut-être pas davantage d’attention. Un site se situant près de la limite supérieure de la distribution, avec des robots d’indexation accédant de manière répétée à des routes dynamiques, mérite quant à lui un examen plus approfondi.
Conclusion
Ce qui importe, c’est ce qui se passe sur votre site
Le trafic IA n’affecte pas tous les sites de la même manière. Un pourcentage à l’échelle de l’ensemble de la flotte peut décrire ce qui se passe sur des milliers de sites web, sans pour autant vous renseigner sur le vôtre.
Cette disparité s’applique également à ce que ces requêtes demandent au site de faire. Dans notre échantillon, les robots d’indexation basés sur l’IA n’ont pas consommé de manière disproportionnée plus de bande passante, mais ils étaient bien plus susceptibles que les visiteurs humains de demander du contenu dynamique. La destination de ces requêtes et la manière dont le site doit y répondre importent tout autant que le nombre de requêtes.
Aucun de ces coûts d’infrastructure n’aurait d’importance si personne ne visitait le site. Mais les visiteurs sont toujours là. De nombreux consommateurs continuent de se rendre sur le site d’une entreprise après avoir reçu une recommandation issue de l’IA, et ce qu’ils y découvrent façonne l’opinion qu’ils se font de l’entreprise. Le site web occupe de plus en plus une place centrale aux deux extrémités de ce parcours : il fournit à la fois des informations accessibles aux systèmes d’IA et une expérience que les utilisateurs peuvent évaluer par eux-mêmes.
Pour les propriétaires et les exploitants de sites, les moyennes du secteur constituent un contexte utile, mais les décisions qui comptent doivent s’appuyer en premier lieu sur votre propre trafic. Quelle est l’ampleur de l’activité liée à l’IA sur votre site, quel est l’objet de ces requêtes, et qui ou quoi se cache derrière elles ? Telles sont les questions qui permettent de transformer une évolution générale du Web en un phénomène que vous pouvez réellement mesurer et gérer.
Passer à l’action
Commencez par votre propre site
Les moyennes du secteur permettent d’évaluer l’ampleur du trafic d’IA, mais elles ne révèlent pas ce qui se passe sur un site spécifique. Mesurez le volume de trafic d’IA atteignant votre site, observez la destination de ces requêtes et identifiez-en les sources lorsque cela est possible. Déterminez ensuite si vos observations nécessitent une surveillance, une optimisation ou une intervention directe.
Volume
Quelle quantité de trafic vous atteint ?
Modèle
Quelles actions ces requêtes effectuent-elles
Profil
Qui ou quoi se trouve à l’origine de ces requêtes ?
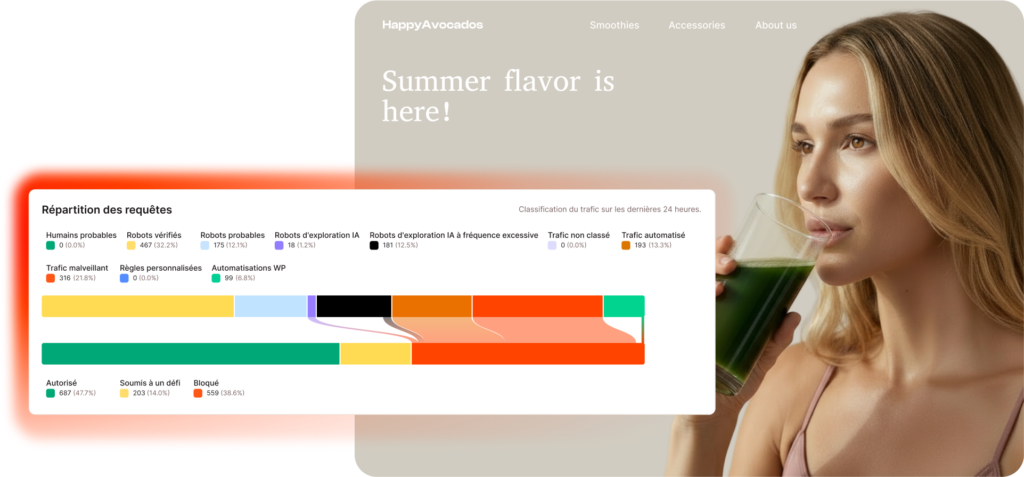
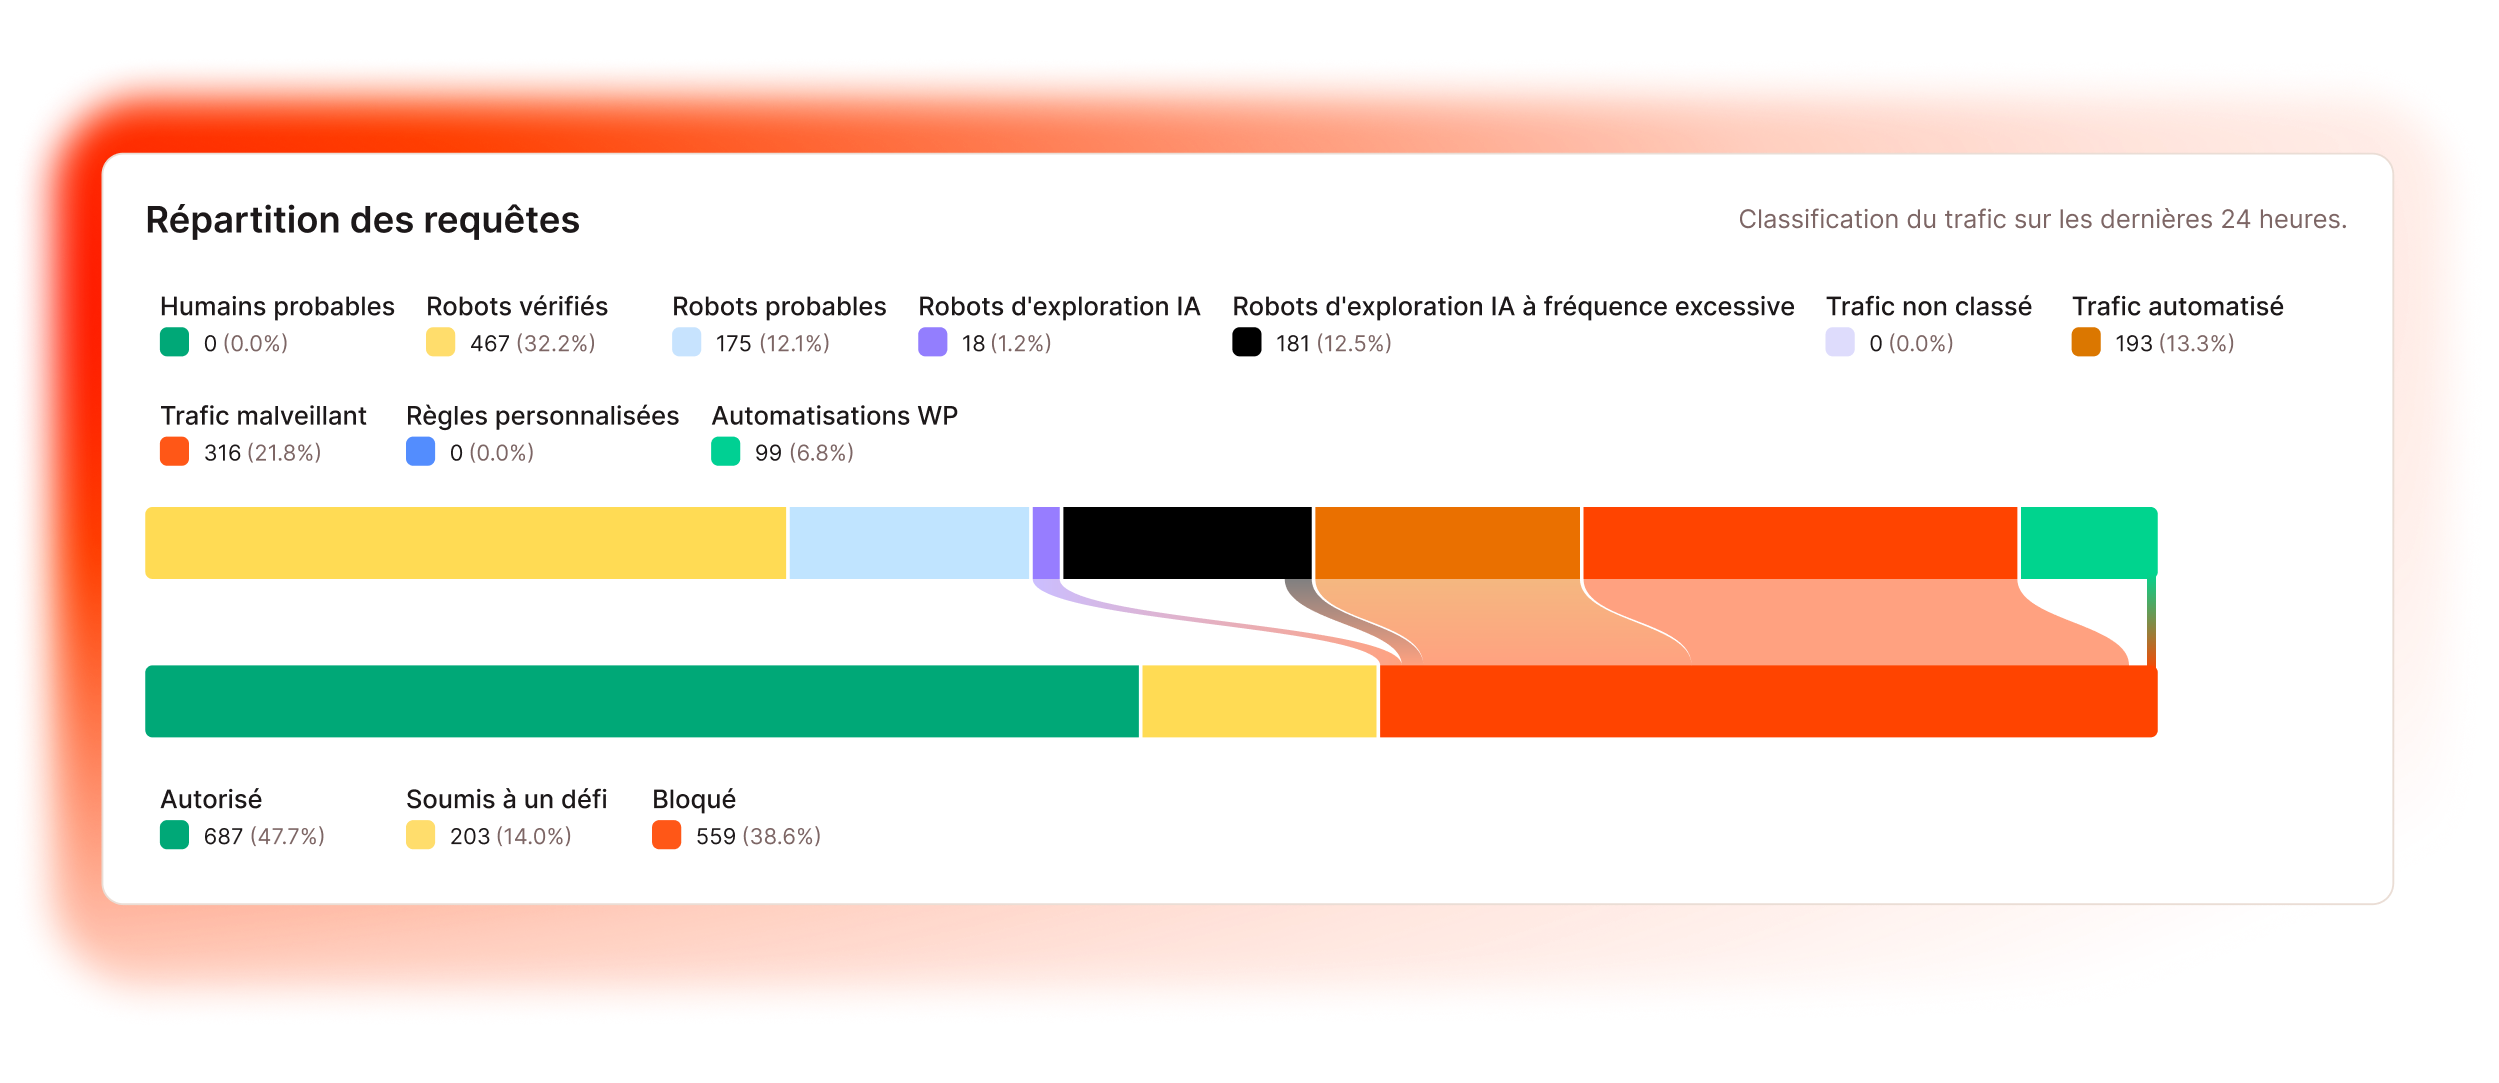
Découvrez à quoi ressemble le trafic des robots sur votre site
Ce rapport vous est proposé par Kinsta.
Kinsta est une plateforme d’hébergement WordPress infogéré qui dessert 230.000 clients dans le monde entier. Notre infrastructure nous offre une perspective unique sur la manière dont les sites web sont consultés, servis et impactés par l’essor du trafic automatisé.