Adicionar como fonte preferencial no Google
Se você quer que seu site apareça nas pesquisas com IA, permitir o acesso de crawlers pode parecer a escolha óbvia. Mas, se o tráfego automatizado consumir recursos demais do servidor, bloqueá-lo pode parecer igualmente razoável. O problema é tratar essas duas opções como mutuamente exclusivas.
Você não precisa dar a todos os bots o mesmo nível de acesso. Alguns crawlers ajudam seu conteúdo a aparecer nos resultados de pesquisa ou de IA, enquanto outros podem acessar seu site com muita frequência sem contribuir significativamente para sua visibilidade. Ao identificar a diferença, você pode decidir onde manter o acesso aberto e onde restringi-lo.
“Crawlers de IA” está se tornando uma categoria ampla demais
Nem todos os crawlers de IA desempenham a mesma função. Por isso, tratá-los da mesma forma pode criar conflitos desnecessários entre visibilidade e desempenho.
O Cloudflare agora divide o tráfego de IA em três categorias amplas:
- Crawlers de pesquisa indexam conteúdo para futuros resultados de pesquisa.
- O tráfego de agentes vem de ferramentas que atuam em tempo real em nome de um usuário.
- Crawlers de treinamento coletam conteúdo para treinar ou ajustar modelos de IA.
A composição do tráfego mostra por que essas distinções são importantes. Segundo o Cloudflare, o treinamento de IA respondia por 52% das solicitações de crawlers em junho de 2026, enquanto os crawlers de uso misto respondiam por mais de 36%. Os crawlers dedicados apenas à pesquisa representavam uma parcela menor, mas ainda desempenhavam um papel importante na descoberta de conteúdo.
A identidade do rastreador, por si só, também revela apenas parte da situação. Uma empresa pode operar vários bots com finalidades diferentes, e um único rastreador pode desempenhar várias funções. Mesmo bots verificados podem causar problemas de desempenho se o volume de solicitações ficar alto demais.
Isso reduz a utilidade de políticas que permitem ou bloqueiam todos os crawlers indiscriminadamente. Se você quer manter a visibilidade nas pesquisas e na descoberta de conteúdo por IA, considere o que cada rastreador realmente faz e o valor que oferece. Entender como os crawlers de IA se comportam ajuda você a decidir o que permitir, restringir ou monitorar.
Comece avaliando o que o rastreador oferece em troca
Depois de distinguir os crawlers por finalidade, a próxima pergunta é o que a atividade deles oferece em troca.
O tráfego automatizado contribui para o posicionamento nas pesquisas tradicionais, as citações por IA, a descoberta de produtos, as recomendações e as pesquisas realizadas em nome dos usuários. Algumas dessas interações podem, com o tempo, levar visitantes ao seu site. Outras podem aumentar a visibilidade sem gerar um clique que você consiga medir facilmente.
O retorno potencial varia bastante. Os dados do Cloudflare sobre a relação entre rastreamentos e visitas provenientes dessas plataformas mostram o tamanho dessa diferença. Ao longo de 2025, a Anthropic, em alguns momentos, rastreou dezenas de milhares de páginas para cada visita que enviou a um site. A proporção da OpenAI geralmente chegava à casa dos milhares, enquanto a da Perplexity frequentemente ficava abaixo de algumas centenas de rastreamentos por visita.
Esses números mudam com o tempo, por isso servem melhor para demonstrar a disparidade do que para estabelecer uma classificação permanente das plataformas de IA. Eles também não capturam todas as formas de valor. O Cloudflare observa que o tráfego de aplicativos nativos de IA pode não incluir o cabeçalho Referer tradicional, impedindo a atribuição de algumas visitas à plataforma. As citações por IA também podem apresentar uma marca ou um conteúdo a usuários que nunca clicam no link.
Ainda assim, a pergunta fundamental continua útil: o que você recebe em troca das solicitações atendidas pelo seu site?
Você pode avaliar essa relação considerando alguns fatores:
| Pergunta | O que você quer identificar |
|---|---|
| O rastreador contribui para as pesquisas ou a descoberta por IA? | Visibilidade potencial |
| Ele envia tráfego de visitas mensurável? | Retorno direto |
| Quais páginas ou endpoints ele solicita? | Custo de infraestrutura |
| Com que frequência ele rastreia o site? | Impacto operacional |
| A solicitação é iniciada por um usuário? | Valor imediato para o usuário |
| Bloqueá-lo eliminaria um canal importante de descoberta? | Risco para a visibilidade |
Dez mil solicitações de crawlers não têm o mesmo valor só porque vêm de sistemas automatizados. Considerar tanto o retorno quanto o custo ajuda você a decidir qual tráfego preservar.
Proteja as páginas que exigem mais recursos em vez de tratar todo o tráfego de bots como igualmente prejudicial
O tipo de rastreador importa, mas o que ele solicita ao acessar seu site também importa. Um bot que carrega periodicamente artigos armazenados em cache gera uma carga de trabalho muito diferente daquela gerada por outro que acessa repetidamente resultados de pesquisa do WordPress, páginas de produtos com filtros, URLs do carrinho e da finalização da compra, endpoints da API REST ou URLs com parâmetros de consulta variáveis. Essas solicitações podem exigir que o WordPress gere uma nova resposta em vez de servir conteúdo do cache.
O impacto dessa diferença se acumula rapidamente. Na análise da Kinsta sobre a atividade de bots, o tráfego automatizado gerou 7,67 milhões de solicitações a URLs de adição ao carrinho em um único período de 24 horas. O ClaudeBot foi responsável por 3,75 milhões delas. O problema não era apenas o fato de um rastreador de IA visitar os sites. O problema era que milhões de solicitações tinham como alvo URLs dinâmicas, nas quais cada acesso podia exigir mais trabalho do aplicativo.
Já abordamos com mais detalhes a relação entre o tráfego de bots e a carga dos servidores WordPress, além do custo de infraestrutura que o tráfego automatizado excessivo pode gerar. O ponto importante aqui é que permitir o acesso de um rastreador não significa dar a ele acesso irrestrito a todas as partes do site.
Pode fazer sentido permitir que um serviço de IA leia um artigo ou uma página de produto pública, caso isso ajude seu conteúdo a aparecer nos resultados de pesquisa ou de IA. Mas há pouco benefício em deixar o mesmo rastreador acessar repetidamente URLs do carrinho, páginas de pesquisa interna ou outras partes do site que exigem muitos recursos para carregar e não contribuem para a descoberta de conteúdo.
Isso oferece outra maneira de pensar na proteção contra bots. Além de perguntar quais crawlers devem ser bloqueados, pergunte também quais solicitações vale a pena atender.
Defina sua política para bots com base no tráfego que você quer preservar
Após identificar quais solicitações mais sobrecarregam seu site, fica mais fácil decidir o que permitir e o que limitar. Uma única lista de permissões ou bloqueios geralmente não é suficiente, pois diferentes crawlers têm finalidades distintas e não oferecem o mesmo valor.
Crawlers de pesquisa tradicionais
Em geral, é recomendável manter o acesso de crawlers de pesquisa legítimos, como Googlebot e Bingbot. Eles continuam importantes para a pesquisa orgânica, e os mesmos índices de pesquisa também estão sendo usados para oferecer experiências de pesquisa cada vez mais orientadas por IA.
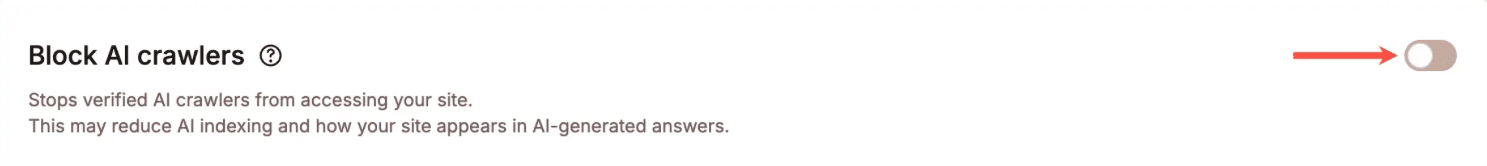
A Kinsta trata os principais crawlers de pesquisa como bots verificados, e a opção Bloquear crawlers de IA não bloqueia o Googlebot nem o Bingbot. Essa distinção é útil porque proteger seu site do tráfego de crawlers de IA não significa automaticamente retirá-lo das pesquisas tradicionais.
Crawlers de pesquisa e recuperação de conteúdo por IA
Se a visibilidade em sistemas de IA é importante para sua empresa, os crawlers de pesquisa e recuperação de conteúdo merecem uma política diferente daquela aplicada aos bots que coletam dados principalmente para treinamento.
Esses crawlers podem acessar conteúdo atualizado para que ferramentas de IA respondam a perguntas, realizem pesquisas, recomendem produtos ou direcionem usuários a páginas úteis. Permitir esse acesso não garante uma citação ou uma visita, mas bloqueá-lo pode eliminar uma das formas pelas quais um sistema de IA encontra ou recupera seu conteúdo mais recente.
Para sites que buscam ativamente visibilidade nas pesquisas com IA, a abordagem prática é permitir esse tráfego onde ele oferece valor e monitorar seu comportamento.
Crawlers de treinamento
Os crawlers de treinamento apresentam uma relação diferente entre custo e benefício. Eles coletam conteúdo para treinar ou ajustar modelos, de modo que sua atividade tem uma relação menos direta com a possibilidade de alguém encontrar seu artigo ou produto mais recente por meio de pesquisas com IA.
Isso não significa que todos os sites devam bloqueá-los automaticamente. Sua decisão pode depender da intensidade do rastreamento, dos recursos consumidos por essas solicitações, da sua estratégia de conteúdo e de seu interesse em que seu conteúdo seja usado no desenvolvimento de modelos.
Se o tráfego de treinamento gerar uma carga considerável e oferecer pouco retorno mensurável ou estratégico, fica mais fácil justificar sua restrição.
Tráfego automatizado desconhecido ou excessivo
Até mesmo um rastreador legítimo pode se tornar um problema quando sua taxa de solicitações fica alta demais.
A Proteção contra Bots da Kinsta classifica os crawlers de IA com taxa excessiva de solicitações separadamente do tráfego comum de crawlers de IA. Isso inclui crawlers verificados quando sua atividade atinge níveis capazes de afetar o desempenho do site. Dependendo do nível de proteção escolhido, a Kinsta pode submeter esse tráfego a um desafio, em vez de tratar a verificação como uma permissão permanente para fazer solicitações ilimitadas.
Suas regras para crawlers podem mudar conforme o tráfego muda. Você pode permitir determinados bots na maior parte do tempo e restringir o acesso se eles começarem a consumir recursos demais ou a afetar o desempenho do site.
A Kinsta oferece vários controles, não apenas uma opção para ativar ou desativar o acesso da IA
Uma política seletiva para bots funciona melhor quando você ajusta a forma como seu site lida com diferentes tipos de tráfego automatizado. A Proteção contra Bots da Kinsta oferece vários controles para isso, em vez de reduzir a decisão a uma única opção de permitir ou bloquear.
A Kinsta oferece quatro níveis de proteção:
- Bloquear tráfego malicioso bloqueia solicitações reconhecidamente maliciosas e permite a passagem de outros tipos de tráfego.
- Bloquear automações adiciona restrições ao tráfego identificado como automatizado.
- Desafiar bots aplica um desafio ao tráfego que a Kinsta identifica como automatizado ou provavelmente automatizado.
- Desafiar todos aplica o nível mais rigoroso de proteção e submete todos os visitantes a um desafio.
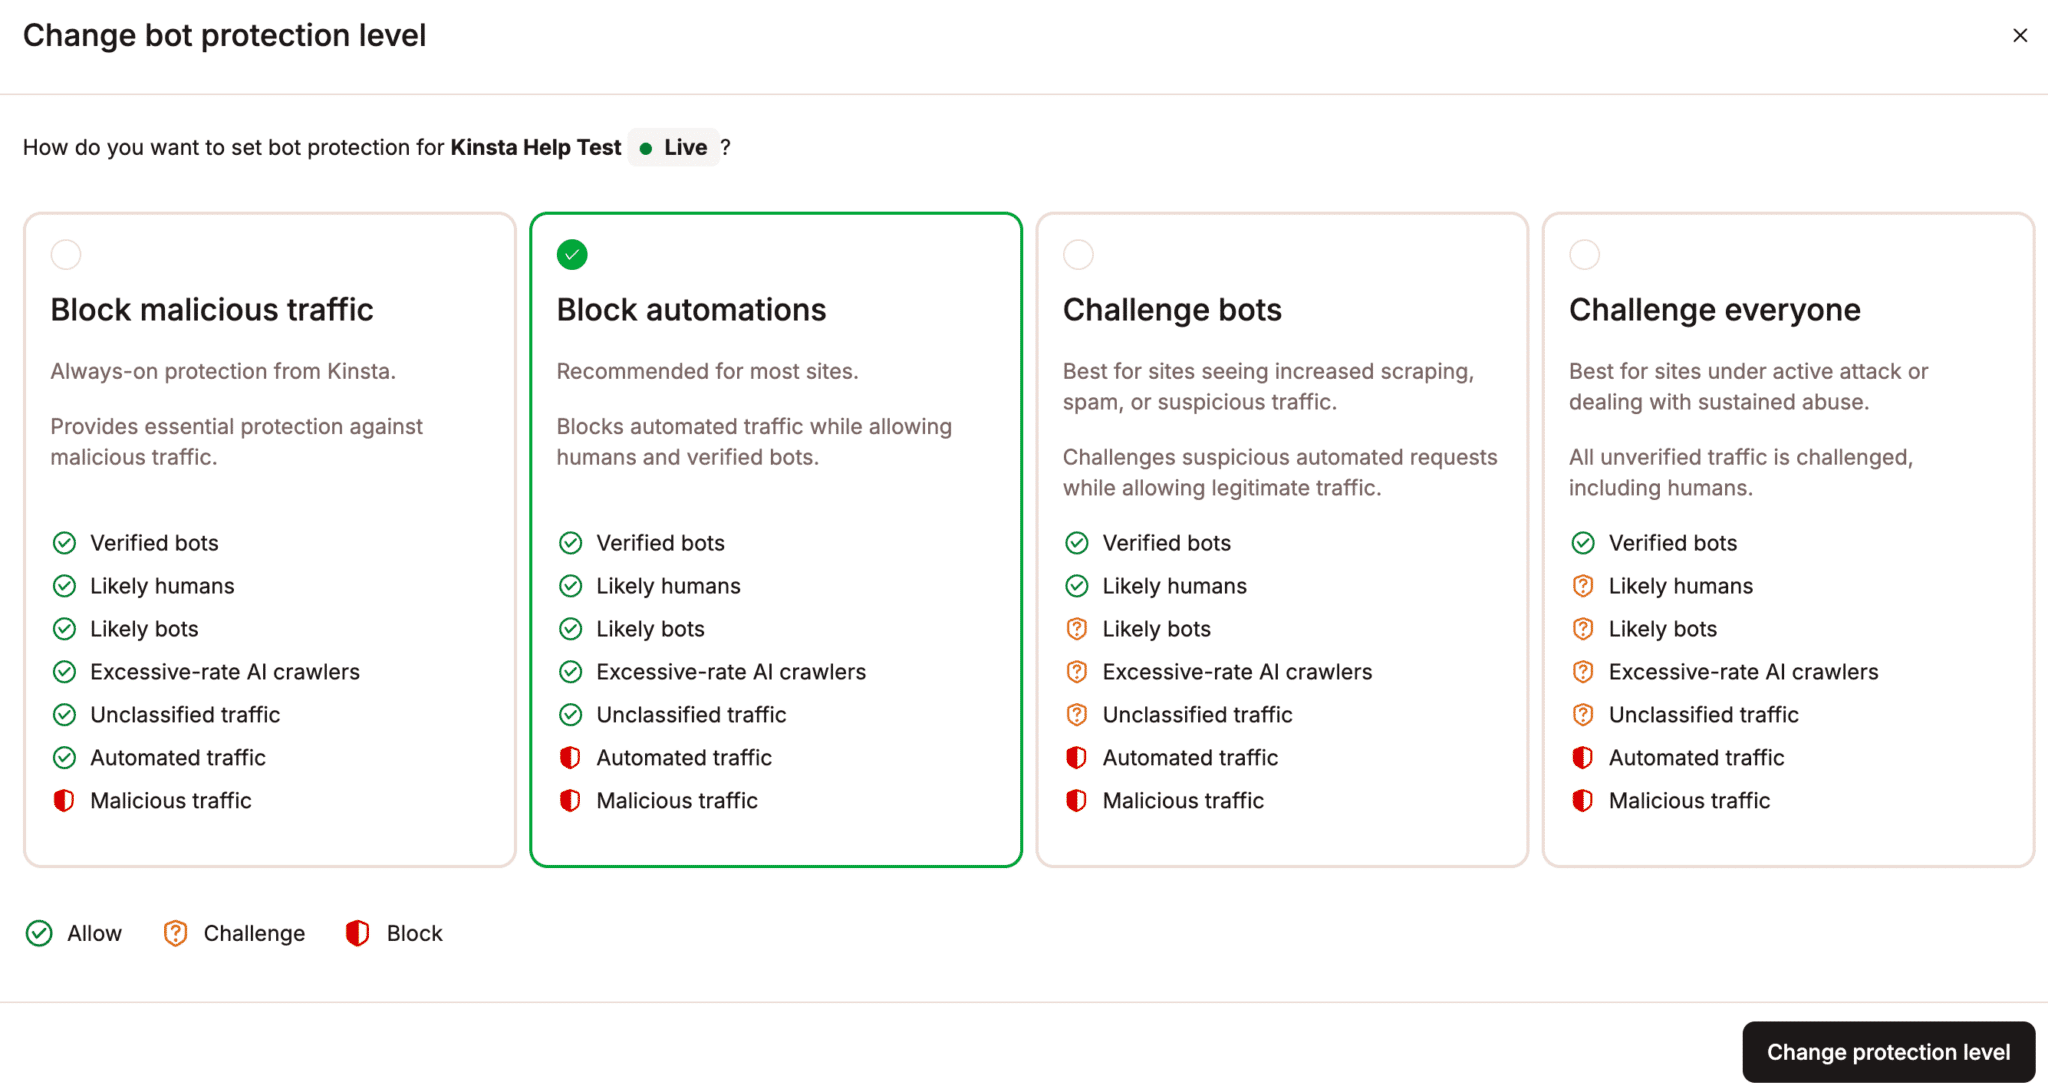
Esses níveis permitem aumentar o rigor da proteção quando o tráfego de bots se torna um problema, sem precisar criar regras manualmente para cada rastreador ou agente de usuário.
Como observado anteriormente, a Kinsta também oferece a opção separada Bloquear crawlers de IA. Quando ativada, ela bloqueia os crawlers de IA contemplados pela opção, inclusive os verificados, mas não bloqueia o Googlebot nem o Bingbot. Assim, é possível restringir parte do rastreamento específico de IA sem impedir que seu site apareça nas pesquisas tradicionais.
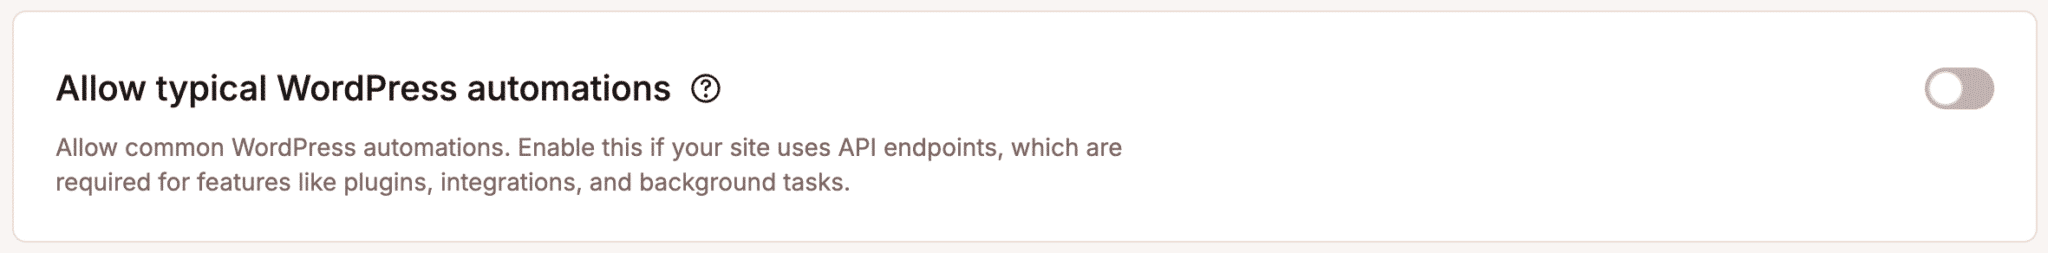
Uma proteção mais rigorosa traz outra preocupação: as automações legítimas. Os sites WordPress dependem de tarefas agendadas, solicitações à API REST, integrações de plugins, serviços de pagamento, ferramentas de monitoramento e outros processos automatizados que você não quer interromper. A opção Permitir automações comuns do WordPress da Kinsta ajuda a preservar essas atividades quando você usa níveis de proteção mais rigorosos.
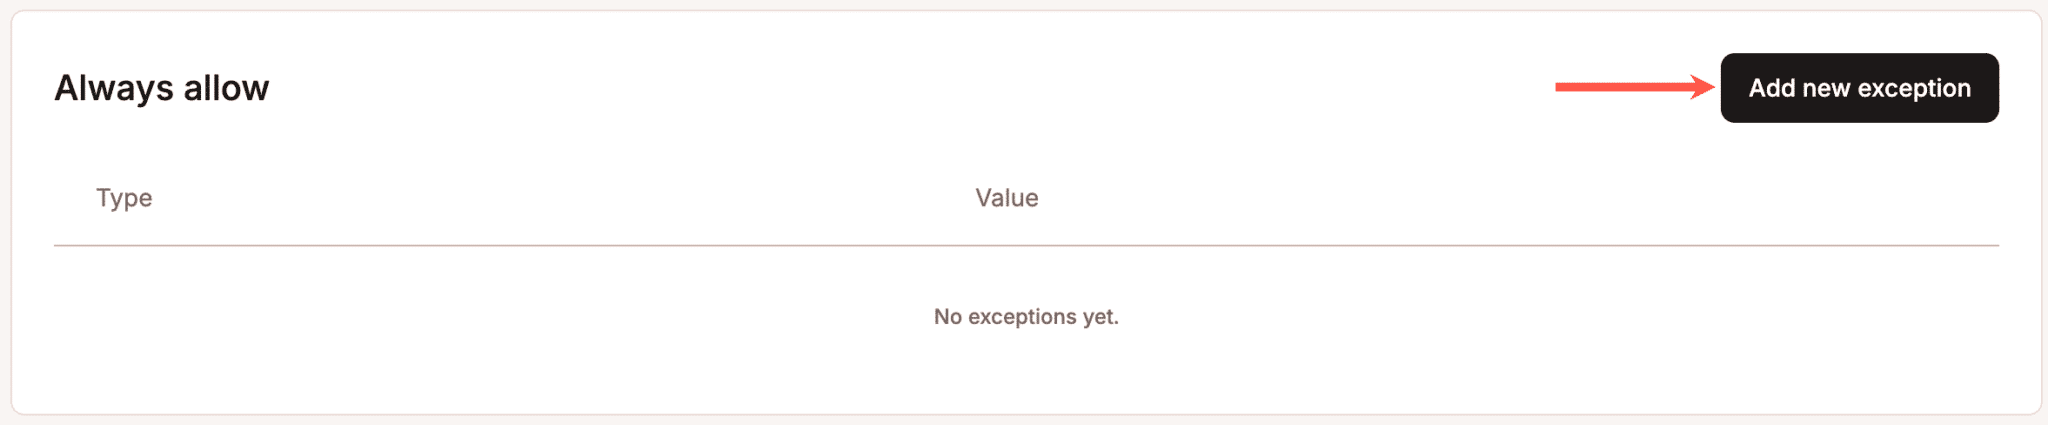
Para o tráfego que exigir um tratamento mais específico, as exceções de Sempre permitir permitem autorizar solicitações com base em um endereço IP, caminho ou agente de usuário.
Juntos, esses controles permitem ajustar sua resposta conforme o tráfego muda. Você pode manter o tráfego útil de pesquisa e de automações, restringir crawlers de IA quando essa decisão fizer sentido e aumentar a proteção quando a atividade automatizada começar a sobrecarregar o site.
Verifique se o equilíbrio adotado está funcionando
A proteção contra bots funciona melhor como um processo contínuo, não apenas como uma configuração feita uma única vez. Depois de ajustar a forma como seu site lida com o tráfego automatizado, você precisa verificar se a mudança melhora realmente o desempenho sem prejudicar canais úteis de descoberta de conteúdo.
Comece comparando o que acontece antes e depois da mudança. Observe:
- Volume de solicitações de crawlers de IA
- Atividade de crawlers de IA com taxa excessiva de solicitações
- Caminhos mais solicitados
- Solicitações permitidas, submetidas a desafio e bloqueadas
- Desempenho do site durante picos de atividade dos crawlers
- Tráfego de pesquisa orgânica
- Tráfego proveniente de plataformas de IA, quando for possível medi-lo
- Conversões ou outras ações valiosas de visitantes provenientes de plataformas de IA
A Kinsta oferece várias formas de investigar essas atividades no MyKinsta. A visualização Detalhamento das solicitações agrupa as solicitações em categorias, incluindo bots verificados, crawlers de IA, crawlers de IA com taxa excessiva de solicitações, tráfego automatizado e bots prováveis. O relatório Tráfego principal pode ajudar você a identificar quais caminhos, agentes de usuário, endereços IP e países geram mais solicitações.
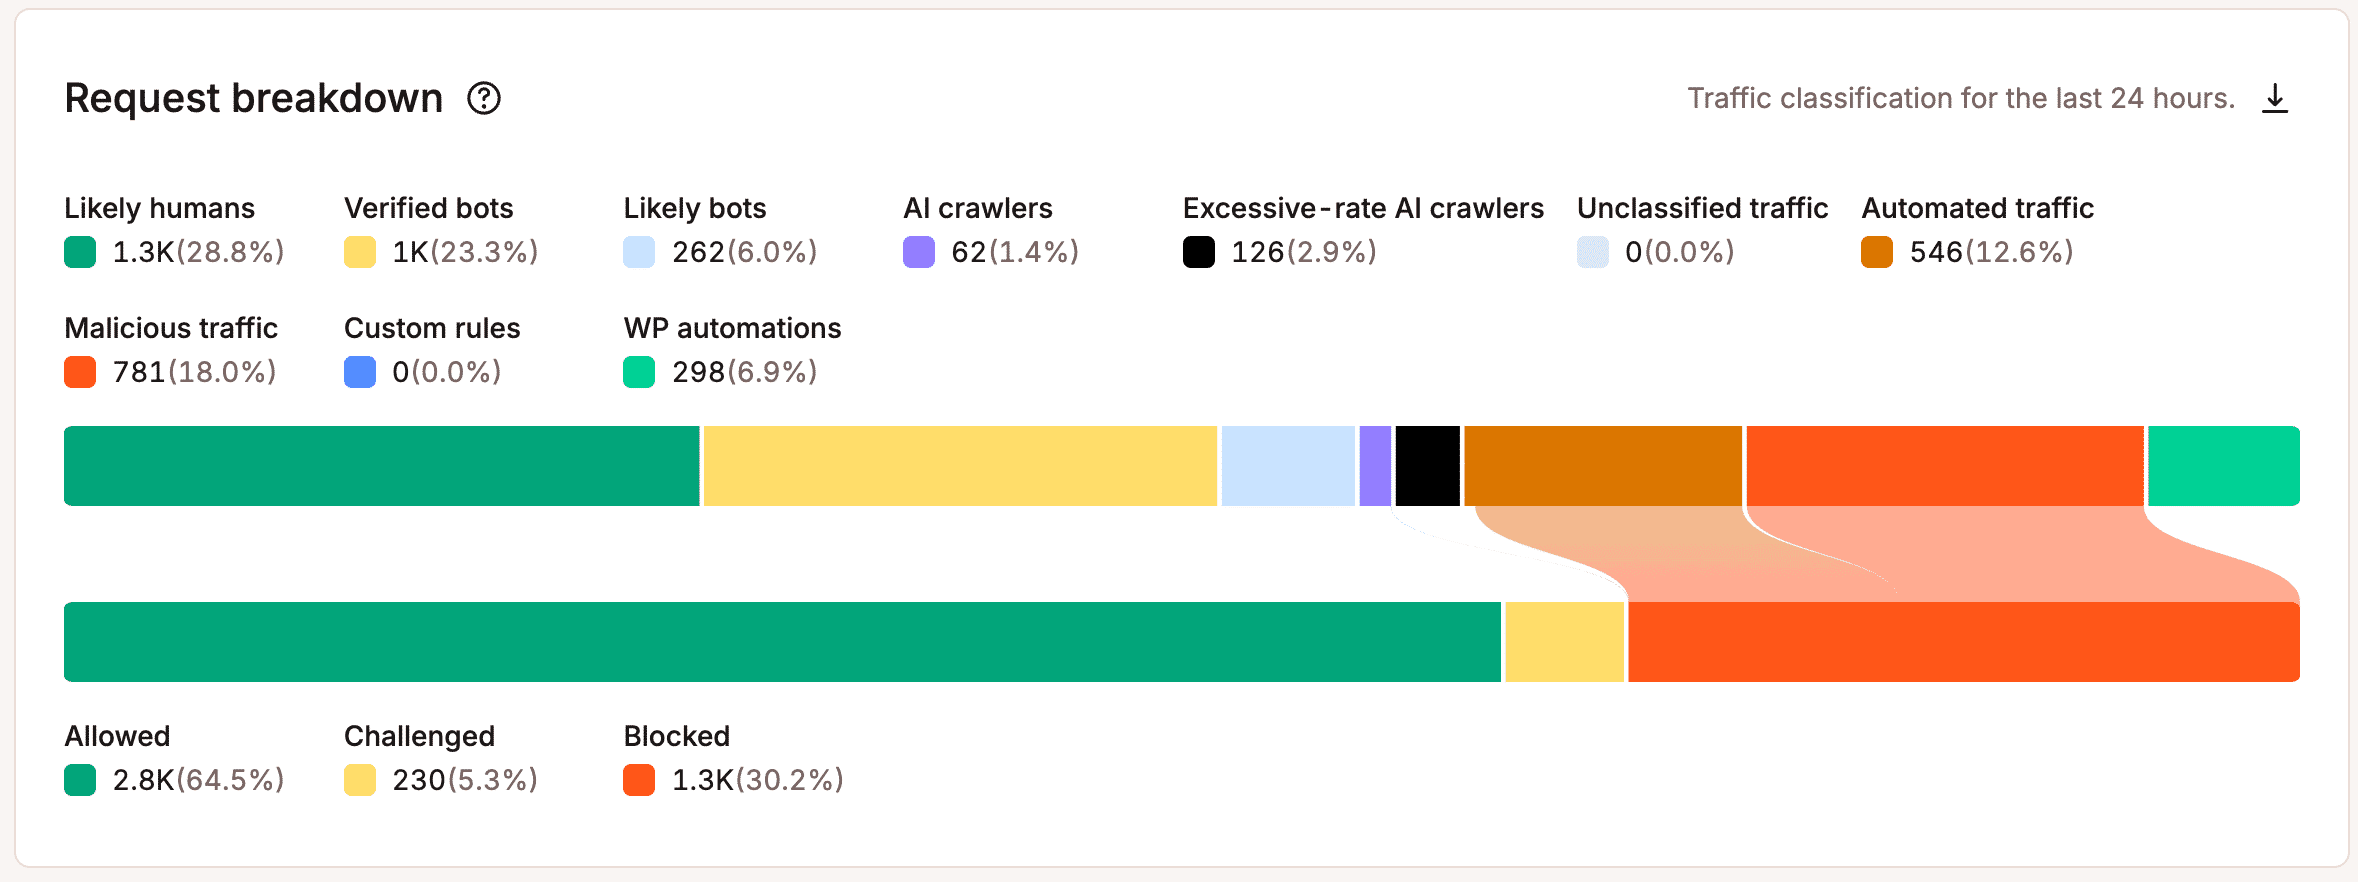
Essas visualizações se tornam especialmente úteis depois que você altera um nível de proteção ou bloqueia uma categoria de crawlers. Se a carga do servidor cair enquanto o tráfego de pesquisa e as visitas provenientes de plataformas de IA permanecerem estáveis, a mudança pode estar produzindo exatamente o resultado esperado. Se o tráfego útil também cair, há motivo para rever a configuração ou adicionar uma exceção mais específica.
O mesmo vale quando as condições mudam. Um rastreador que causa poucos problemas hoje pode aumentar sua frequência de solicitações mais tarde, enquanto um canal de descoberta por IA que atualmente envia pouco tráfego mensurável pode se tornar mais valioso com o tempo.
Um ciclo simples funciona bem: observe, ajuste, compare e, então, mantenha ou reverta a mudança.
Os novos controles de IA do Cloudflare mostram o rumo do gerenciamento de bots
As mudanças recentes do Cloudflare apontam para uma estratégia mais ampla: gerenciar o tráfego automatizado de acordo com o que ele faz, em vez de aplicar a mesma regra a todos os crawlers de IA.
Em julho de 2026, o Cloudflare substituiu sua abordagem única para bots de IA por controles separados para o tráfego de Pesquisa, Agentes e Treinamento. Os proprietários de sites podem permitir cada categoria, bloqueá-la em todo o site ou bloqueá-la apenas nas páginas que exibem anúncios. Desde 15 de setembro, os novos domínios usam configurações padrão que permitem o tráfego de Pesquisa e bloqueiam o tráfego de Agentes e Treinamento nas páginas com anúncios. O Cloudflare também alterou a forma como suas políticas se aplicam a crawlers de múltiplas finalidades, que combinam atividades como Pesquisa e Treinamento.
A mudança é importante porque reconhece um problema que os proprietários de sites já enfrentam. Você pode querer que um rastreador indexe seu conteúdo para que ele seja encontrado, sem dar à mesma empresa acesso ilimitado para treinar modelos. Uma única opção para “bots de IA” não permite expressar bem essa preferência.
Se você hospeda seu site na Kinsta, tenha cuidado ao adicionar outra camada de proteção contra bots a que já existe. Se você também usa sua própria configuração do Cloudflare, com regras personalizadas de WAF ou para bots, o Cloudflare processa essas solicitações primeiro. Em alguns casos, isso pode fazer com que tráfego legítimo seja bloqueado antes mesmo de chegar à Kinsta.
As mudanças do Cloudflare são úteis como indicação do rumo do gerenciamento de bots, mais do que como um conjunto de regras que todos os sites WordPress deveriam copiar. A abordagem de apenas permitir ou bloquear está dando lugar a controles que preservam o tráfego automatizado útil e restringem atividades que oferecem menos valor.
As agências precisam de uma política, não de uma única configuração para todos os clientes
Para as agências, não existe uma política para bots que funcione para todos os clientes. Um site de publicação pode aceitar mais atividade de crawlers de IA se isso ajudar seu conteúdo a ser encontrado, enquanto um site WooCommerce com muito tráfego pode precisar de limites mais rigorosos quando essas solicitações começarem a disputar recursos do servidor com os compradores.
Um estudo de caso sobre o trabalho realizado com a Hall mostra por que essas diferenças importam. Um dos clientes WooCommerce da agência enfrentava períodos de indisponibilidade durante picos de tráfego antes de migrar para a Kinsta. À medida que a receita anual da empresa cresceu de US$ 3 milhões para mais de US$ 50 milhões, manter um desempenho confiável nos períodos de maior demanda tornou-se cada vez mais importante.
As regras para bots devem refletir o funcionamento de cada site. Identifique quais crawlers são importantes para o cliente, quais sobrecarregam mais o site e quais serviços automatizados precisam continuar tendo acesso. Depois, ajuste as regras ao longo do tempo, conforme mudarem o tráfego e as necessidades do cliente.
Controle o acesso sem deixar de aparecer
Você não precisa escolher entre tornar seu site visível para sistemas de IA e protegê-lo do tráfego automatizado excessivo. A pergunta mais útil é quais atividades merecem acesso, onde esse acesso faz sentido e quanto custa ao site atender a essas solicitações.
Mantenha o tráfego de pesquisa e de IA que ajuda as pessoas a encontrar seu site, mas observe o que acontece depois que os crawlers chegam até ele. Se um bot começar a consumir muitos recursos sem oferecer muito benefício, você pode limitar seu acesso. Apenas tome cuidado para não interferir nas automações do WordPress ou em outros serviços dos quais seu site depende.
Essas decisões podem mudar conforme evoluem o comportamento dos crawlers, os padrões de tráfego proveniente de plataformas de IA e suas próprias prioridades. O importante é ter visibilidade suficiente para entender o que está acontecendo e controle suficiente para agir.
Saiba mais sobre a Proteção contra Bots da Kinsta e confira os resultados do nosso Relatório sobre Tráfego de IA e Bots.
Carlo é um apaixonado por webdesign e desenvolvimento frontend. Ele tem mais de 10 anos de experiência com WordPress e colaborou com diversas universidades e instituições educacionais na Itália e na Europa. Carlo já publicou inúmeros artigos e guias sobre WordPress, tanto em sites italianos quanto internacionais, além de revistas impressas. Você pode seguir ele no LinkedIn e no X.