Aggiungi come fonte preferita su Google
Se vuoi che il tuo sito compaia nei risultati di ricerca basati sull’AI, consentire l’accesso ai crawler può sembrare la scelta più ovvia. Ma se il traffico automatizzato consuma troppe risorse del server, bloccarlo sembra altrettanto ragionevole. Il problema è considerare queste due opzioni come mutuamente esclusive.
Non devi dare a ogni bot lo stesso livello di accesso. Alcuni crawler aiutano i tuoi contenuti ad apparire nei risultati di ricerca o in quelli basati sull’AI, mentre altri potrebbero sovraccaricare il sito senza apportare grandi benefici alla visibilità. Una volta capito quali sono gli uni e quali gli altri, puoi decidere dove lasciare l’accesso libero e dove renderlo più restrittivo.
La categoria “crawler AI” sta diventando troppo generica
Non tutti i crawler AI svolgono lo stesso lavoro, quindi trattarli tutti allo stesso modo può creare compromessi inutili tra visibilità e prestazioni.
Cloudflare ora raggruppa il traffico AI in tre grandi categorie:
- I crawler di ricerca indicizzano i contenuti per i futuri risultati di ricerca.
- Il traffico degli agenti proviene da strumenti che agiscono in tempo reale per conto di un utente.
- I crawler di addestramento raccolgono contenuti per addestrare o mettere a punto modelli di AI.
La composizione del traffico mostra perché queste distinzioni sono importanti. Cloudflare riporta che, a giugno 2026, l’addestramento dell’AI rappresentava il 52% delle richieste dei crawler, mentre i crawler a uso misto ne rappresentavano oltre il 36%. Il crawling dedicato esclusivamente alla ricerca rappresenta una quota minore, ma svolge comunque un ruolo importante nella reperibilità dei contenuti.
Anche l’identità del crawler da sola non dice tutto. Un’azienda può gestire diversi bot per scopi diversi, e un singolo crawler può svolgere più funzioni. Persino i bot verificati possono creare problemi di prestazioni se il volume delle richieste diventa troppo elevato.
Questo rende meno utili le politiche generiche di autorizzazione o blocco. Se vuoi rimanere visibile nei risultati di ricerca e nella scoperta basata sull’AI, concentrati su ciò che ogni crawler fa effettivamente e sul valore che offre. Capire come si comportano i crawler AI ti offre una base migliore per decidere cosa consentire, limitare o monitorare.
Inizia chiedendoti cosa ti offre in cambio il crawler
Una volta classificati i crawler in base allo scopo, la domanda successiva è: cosa ti offre in cambio la loro attività?
Il traffico automatizzato supporta i tradizionali posizionamenti nei motori di ricerca, le citazioni basate sull’AI, la scoperta dei prodotti, i consigli e le ricerche effettuate per tuo conto. Alcune di queste interazioni possono alla fine indirizzare visitatori al tuo sito. Altre possono aumentare la visibilità senza generare un clic facilmente misurabile.
Il potenziale ritorno varia notevolmente. I dati di Cloudflare sul rapporto tra scansione e referral mostrano quanto possa essere ampio il divario. Nel corso del 2025, Anthropic a volte ha scansionato decine di migliaia di pagine per ogni referral inviato a un sito web. Il rapporto di OpenAI ha generalmente raggiunto le migliaia, mentre quello di Perplexity è spesso rimasto al di sotto di poche centinaia di scansioni per referral.
Queste cifre cambiano nel tempo, quindi sono più utili come prova della disparità che come classifica definitiva delle piattaforme di AI. Inoltre, non tengono conto di ogni forma di valore. Cloudflare sottolinea che il traffico proveniente da app native di AI potrebbe non includere un’intestazione Referrer tradizionale, il che significa che alcune visite non vengono attribuite alla piattaforma. I riferimenti generati dall’AI possono anche far conoscere un brand o un contenuto a utenti che non cliccano mai sul link.
Comunque, la domanda di fondo rimane utile: cosa ottieni in cambio delle richieste che il tuo sito gestisce?
Puoi valutare questo rapporto guardando alcuni fattori:
| Domanda | Cosa stai cercando di capire |
| Il crawler supporta la ricerca o la scoperta tramite AI? | Visibilità potenziale |
| Invia traffico di provenienza misurabile? | Ritorno diretto |
| Quali pagine o endpoint richiede? | Costo dell’infrastruttura |
| Con quale frequenza esegue il crawling? | Impatto operativo |
| È l’utente ad attivare la richiesta? | Valore immediato per l’utente |
| Bloccarlo eliminerebbe un importante canale di scoperta? | Rischio di visibilità |
Diecimila richieste da parte di crawler non hanno lo stesso valore solo perché provengono da sistemi automatizzati. Considerare sia il ritorno che il costo ti offre una base migliore per decidere quale traffico mantenere.
Proteggi le richieste costose invece di considerare tutto il traffico dei bot ugualmente dannoso
Il tipo di crawler è importante, ma lo è anche ciò che richiede una volta raggiunto il tuo sito. Un bot che carica periodicamente articoli memorizzati nella cache crea un carico di lavoro molto diverso rispetto a uno che colpisce ripetutamente i risultati di ricerca di WordPress, le pagine dei prodotti filtrate, gli URL del carrello e del checkout, gli endpoint delle API REST o gli URL con parametri di query variabili. Queste richieste possono costringere WordPress a generare una nuova risposta invece di servire i contenuti dalla cache.
Questa differenza si accumula rapidamente. Nell’analisi di Kinsta sull’attività dei bot, il traffico automatizzato ha generato 7,67 milioni di richieste agli URL “aggiungi al carrello” in un solo periodo di 24 ore. ClaudeBot ne ha generati 3,75 milioni. Il problema non era semplicemente che un crawler basato sull’intelligenza artificiale visitasse i siti. Era che milioni di richieste prendevano di mira URL dinamici, dove ogni visita poteva potenzialmente richiedere più lavoro da parte dell’applicazione.
Abbiamo già approfondito altrove il rapporto tra il traffico dei bot e il carico sui server WordPress, oltre ai costi di infrastruttura che un traffico automatizzato eccessivo può comportare. Il punto importante qui è che l’accesso di un crawler non deve necessariamente significare accesso a ogni singola parte di un sito.
Può avere senso lasciare che un servizio di AI legga un articolo pubblico o una pagina di prodotto, se questo aiuta i tuoi contenuti a comparire nei risultati di ricerca o di AI. Ma non c’è quasi nessun vantaggio nel lasciare che lo stesso crawler colpisca ripetutamente gli URL del carrello, le pagine di ricerca interne o altre parti del sito che sono costose da caricare e non migliorano la visibilità.
Questo ti offre un altro modo di pensare alla protezione dai bot. Invece di chiederti solo quali crawler bloccare, chiediti anche quali richieste vale la pena soddisfare.
Crea la tua politica sui bot in base al traffico che vuoi preservare
Una volta che sai quali richieste mettono più sotto pressione il tuo sito, è più facile decidere cosa consentire e cosa limitare. Di solito un unico elenco di autorizzazioni o di blocchi non basta, perché i diversi crawler hanno scopi diversi e non tutti apportano lo stesso valore.
Crawler di ricerca tradizionali
Di solito conviene mantenere i crawler di ricerca legittimi come Googlebot e Bingbot. Sono ancora importanti per la ricerca organica, e gli stessi indici di ricerca vengono utilizzati anche per alimentare esperienze di ricerca sempre più basate sull’intelligenza artificiale.
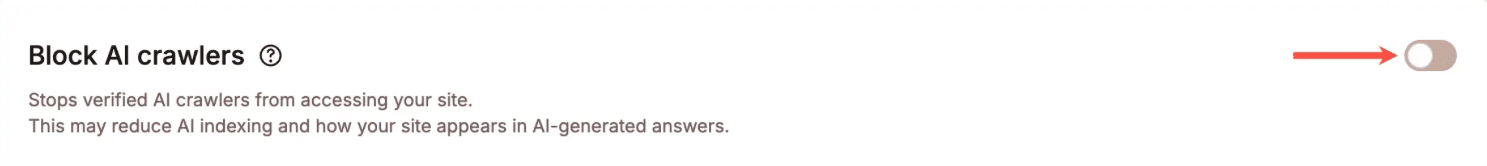
Kinsta considera i principali crawler di ricerca come bot verificati e la sua impostazione Blocca crawler AI non blocca né Googlebot né Bingbot. Questa distinzione è davvero utile perché proteggere il tuo sito dal traffico dei crawler AI non significa automaticamente escluderlo dalla ricerca tradizionale.
Crawler di ricerca e recupero basati sull’AI
Se la visibilità nell’AI è importante per la tua attività, i crawler di ricerca e recupero meritano una politica diversa rispetto ai bot che raccolgono principalmente dati di addestramento.
Questi crawler possono accedere ai contenuti attuali in modo che gli strumenti di AI possano rispondere a domande, effettuare ricerche, consigliare prodotti o indirizzare gli utenti verso pagine utili. Consentirne l’accesso non garantisce una citazione o un rinvio, ma bloccarli può eliminare uno dei modi in cui un sistema di AI trova o recupera i tuoi contenuti più recenti.
Per i siti che puntano attivamente alla visibilità nella ricerca basata sull’AI, l’approccio pratico è quello di consentire questo traffico laddove apporta valore e monitorarne il comportamento.
Crawler di addestramento
I crawler di addestramento comportano un compromesso diverso. Raccolgono contenuti per addestrare o mettere a punto i modelli, quindi la loro attività ha un legame meno diretto con la possibilità che qualcuno trovi il tuo ultimo articolo o prodotto tramite la ricerca basata sull’AI.
Questo non significa che ogni sito debba bloccarli automaticamente. La tua decisione potrebbe dipendere da quanto eseguono il crawling, dalle risorse che queste richieste consumano, dalla tua strategia di contenuti e dal fatto che tu voglia o meno che i tuoi contenuti vengano utilizzati per lo sviluppo dei modelli.
Se il traffico di addestramento crea un carico sostanziale fornendo al contempo un ritorno misurabile o strategico minimo, limitarlo diventa più facile da giustificare.
Traffico automatizzato sconosciuto o eccessivo
Anche un crawler legittimo può diventare un problema quando la sua frequenza di richiesta diventa troppo alta.
Protezione bot di Kinsta classifica i crawler AI con frequenza eccessiva separatamente dal normale traffico dei crawler AI. Ciò include anche i crawler verificati quando la loro attività raggiunge livelli che potrebbero influire sulle prestazioni del sito. A seconda del livello di protezione che scegli, Kinsta può mettere in discussione quel traffico invece di considerare la verifica come un’autorizzazione permanente a effettuare richieste illimitate.
Le tue regole sui crawler possono cambiare al variare del traffico. Potresti decidere di consentire l’accesso a determinati bot per la maggior parte del tempo, per poi restringere l’accesso se iniziano a utilizzare troppe risorse o a influire sulle prestazioni del sito.
Kinsta offre diversi controlli, non solo un interruttore “AI on/off”
Una politica selettiva sui bot funziona meglio quando regoli il modo in cui il tuo sito gestisce i diversi tipi di traffico automatizzato. Protezione bot di Kinsta ti offre diversi controlli per farlo, invece di ridurre la decisione a una singola impostazione “consenti” o “blocca”.
Kinsta offre quattro livelli di protezione:
- Blocca traffico dannoso blocca le richieste dannose note, lasciando passare il resto del traffico.
- Blocca le automazioni aggiunge restrizioni al traffico automatizzato confermato.
- Verifica bot applica una verifica al traffico che Kinsta identifica come automatizzato o potenzialmente automatizzato.
- Verifica tutti applica il livello di protezione più rigoroso e richiede l’autenticazione a tutti i visitatori.
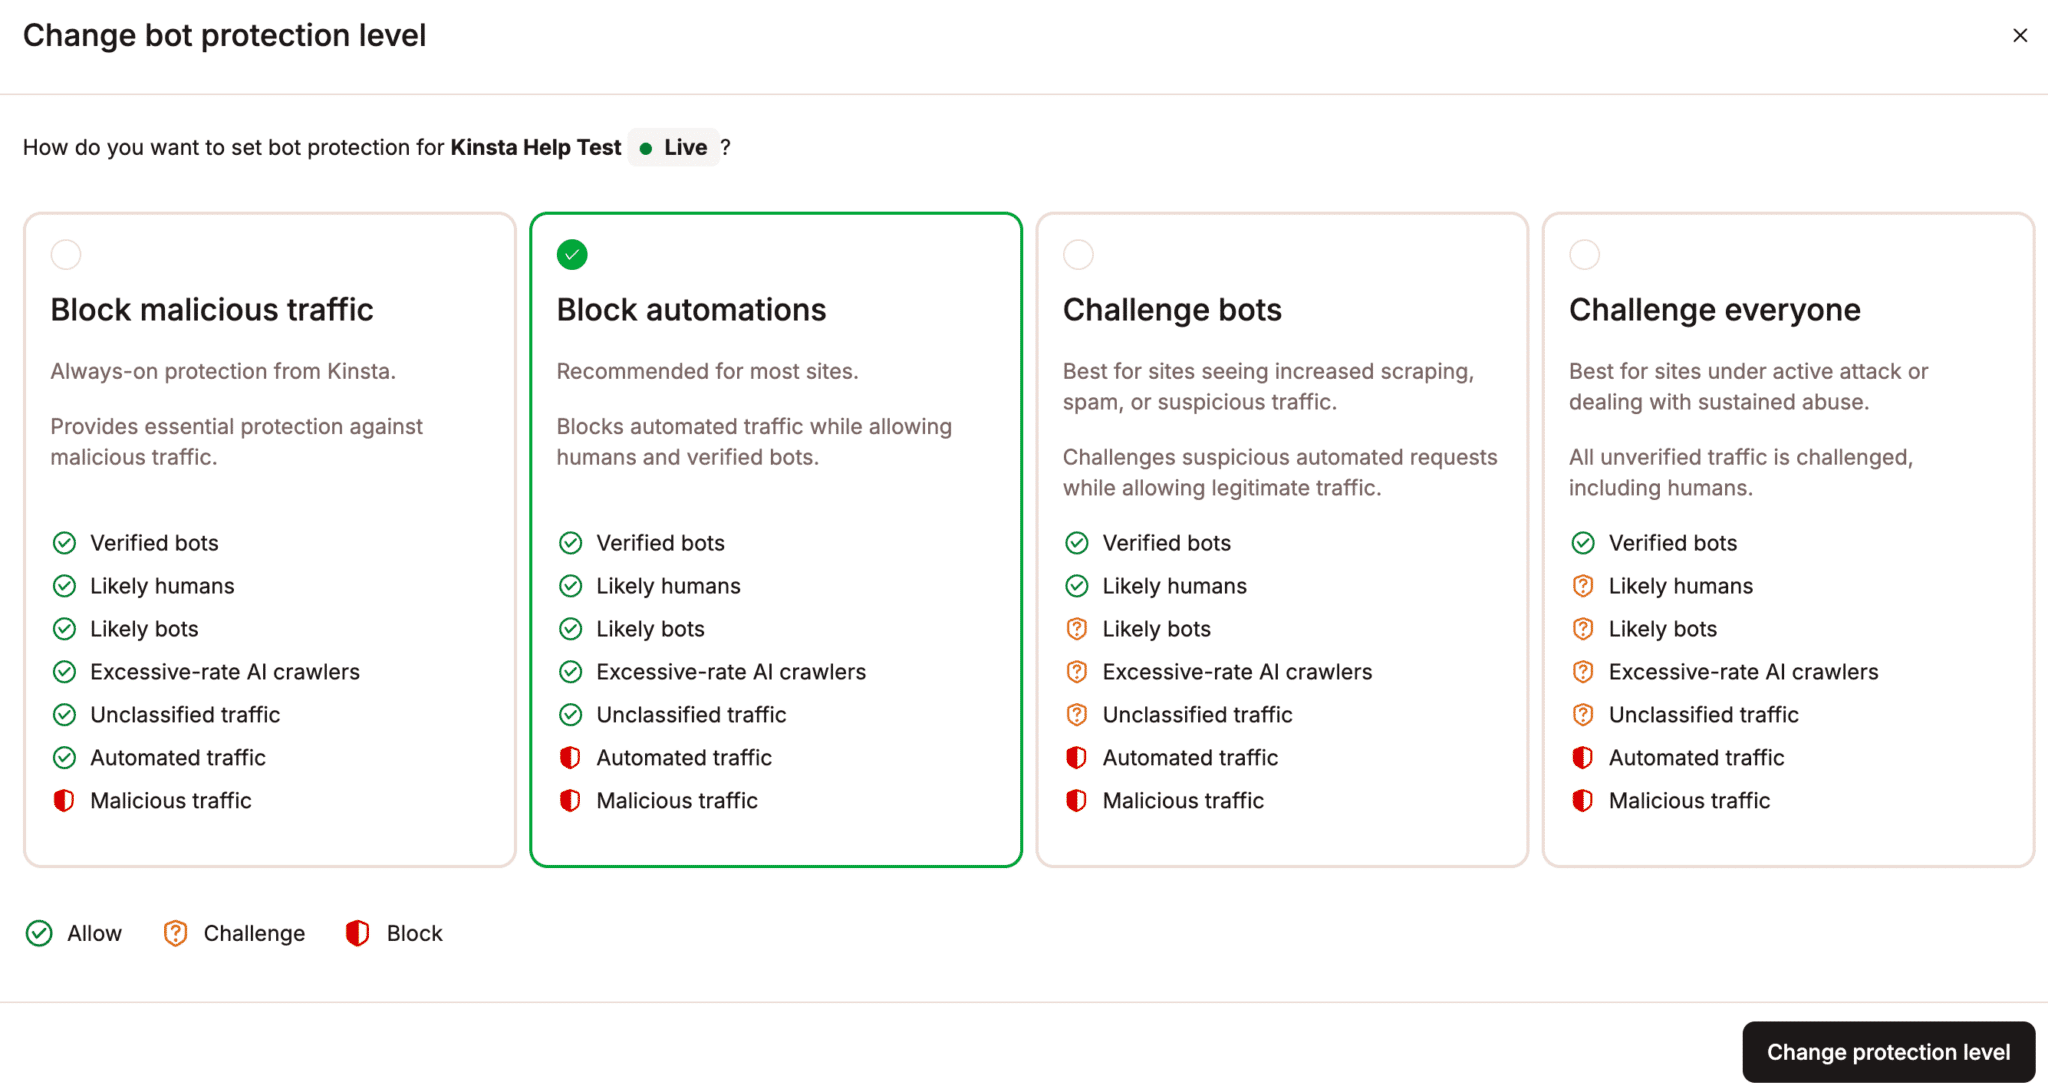
Questi livelli ti permettono di aumentare il livello di protezione quando il traffico dei bot diventa un problema, senza dover creare manualmente regole per ogni crawler o user agent.
Come già detto, Kinsta offre anche un’impostazione separata Blocca crawler AI. Quando è abilitata, blocca i crawler AI supportati, compresi quelli verificati, ma non blocca Googlebot o Bingbot. Questo ti permette di limitare alcune attività di crawling specifiche dell’AI senza isolare il tuo sito dalla ricerca tradizionale.
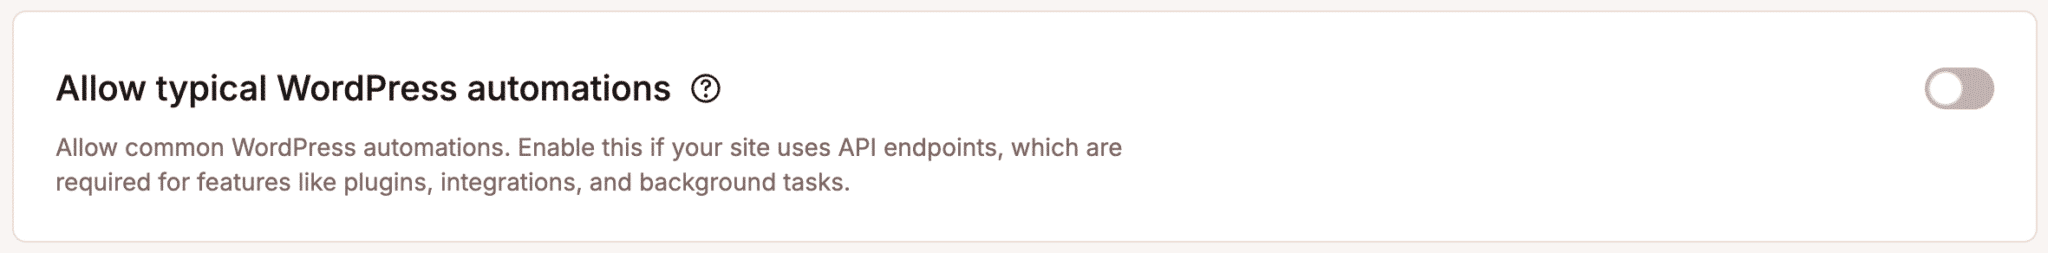
Una protezione più rigorosa crea però un’altra preoccupazione: l’automazione legittima. I siti WordPress si basano su attività pianificate, richieste API REST, integrazioni di plugin, servizi di pagamento, strumenti di monitoraggio e altri processi automatizzati che non vuoi interrompere. L’opzione Consenti automazioni tipiche di WordPress di Kinsta aiuta a preservare tali attività quando usi livelli di protezione più elevati.
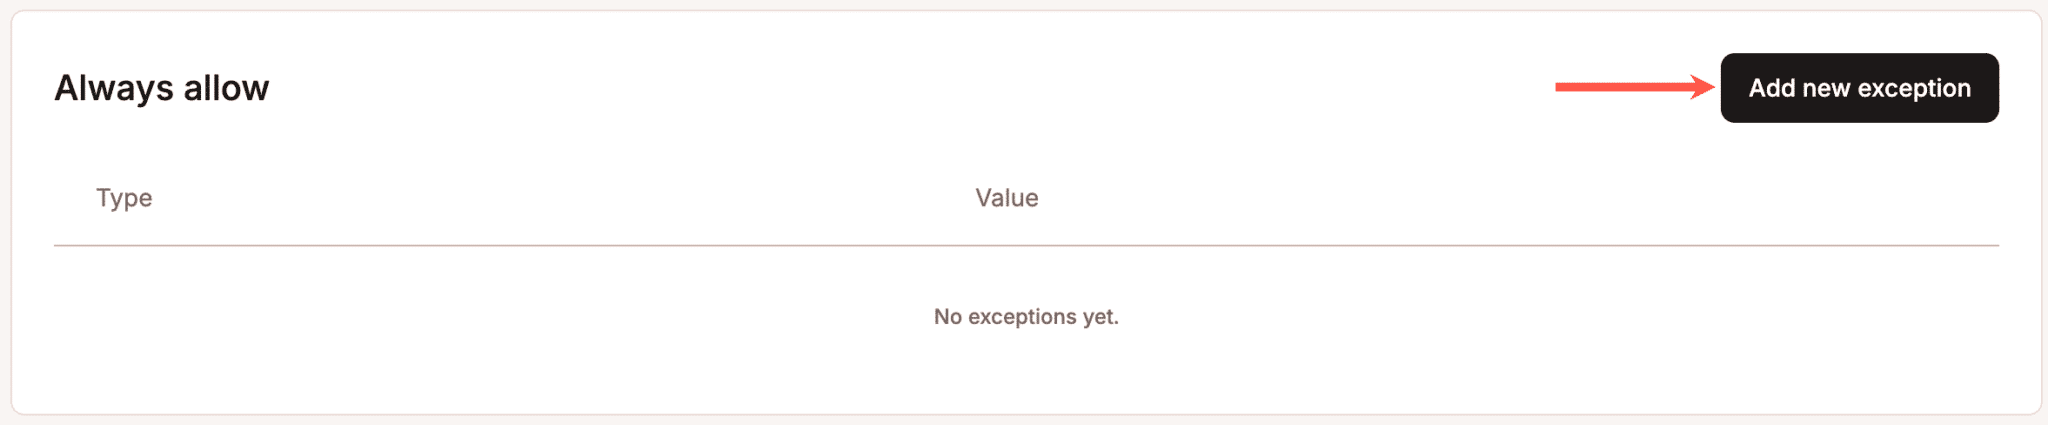
Per tutto ciò che richiede un trattamento più specifico, le eccezioni Consenti sempre ti permettono di autorizzare il traffico in base a un indirizzo IP, un percorso o uno user agent.
Insieme, questi controlli ti danno la possibilità di adattare la tua risposta al variare del traffico. Puoi mantenere attivo il traffico utile proveniente da ricerche e automazioni, limitare i crawler AI quando ne vale la pena e aumentare la protezione quando l’attività automatizzata inizia a mettere troppo sotto pressione il sito.
Verifica se il tuo equilibrio funziona davvero
La protezione dai bot funziona al meglio come processo continuo e non solo come configurazione una tantum. Dopo aver regolato il modo in cui il tuo sito gestisce il traffico automatizzato, devi verificare se la modifica migliora effettivamente le prestazioni senza tagliare fuori canali di scoperta utili.
Inizia confrontando cosa succede prima e dopo aver apportato una modifica. Controlla:
- Volume delle richieste dei crawler AI
- Attività dei crawler AI a frequenza eccessiva
- Percorsi più richiesti
- Richieste consentite, verificate e bloccate
- Le prestazioni del sito durante i picchi di attività dei crawler
- Traffico di ricerca organico
- Traffico proveniente dai referral dell’AI, laddove è possibile misurarlo
- Conversioni o altre azioni di valore da parte dei visitatori provenienti da AI
Kinsta offre diversi modi per analizzare questa attività in MyKinsta. La vista Suddivisione delle richieste raggruppa le richieste in categorie, tra cui bot verificati, crawler AI, crawler AI con frequenza eccessiva, traffico automatizzato e probabili bot. Il report Traffico principale può poi aiutarti a identificare quali percorsi, user agent, indirizzi IP e paesi generano il maggior numero di richieste.
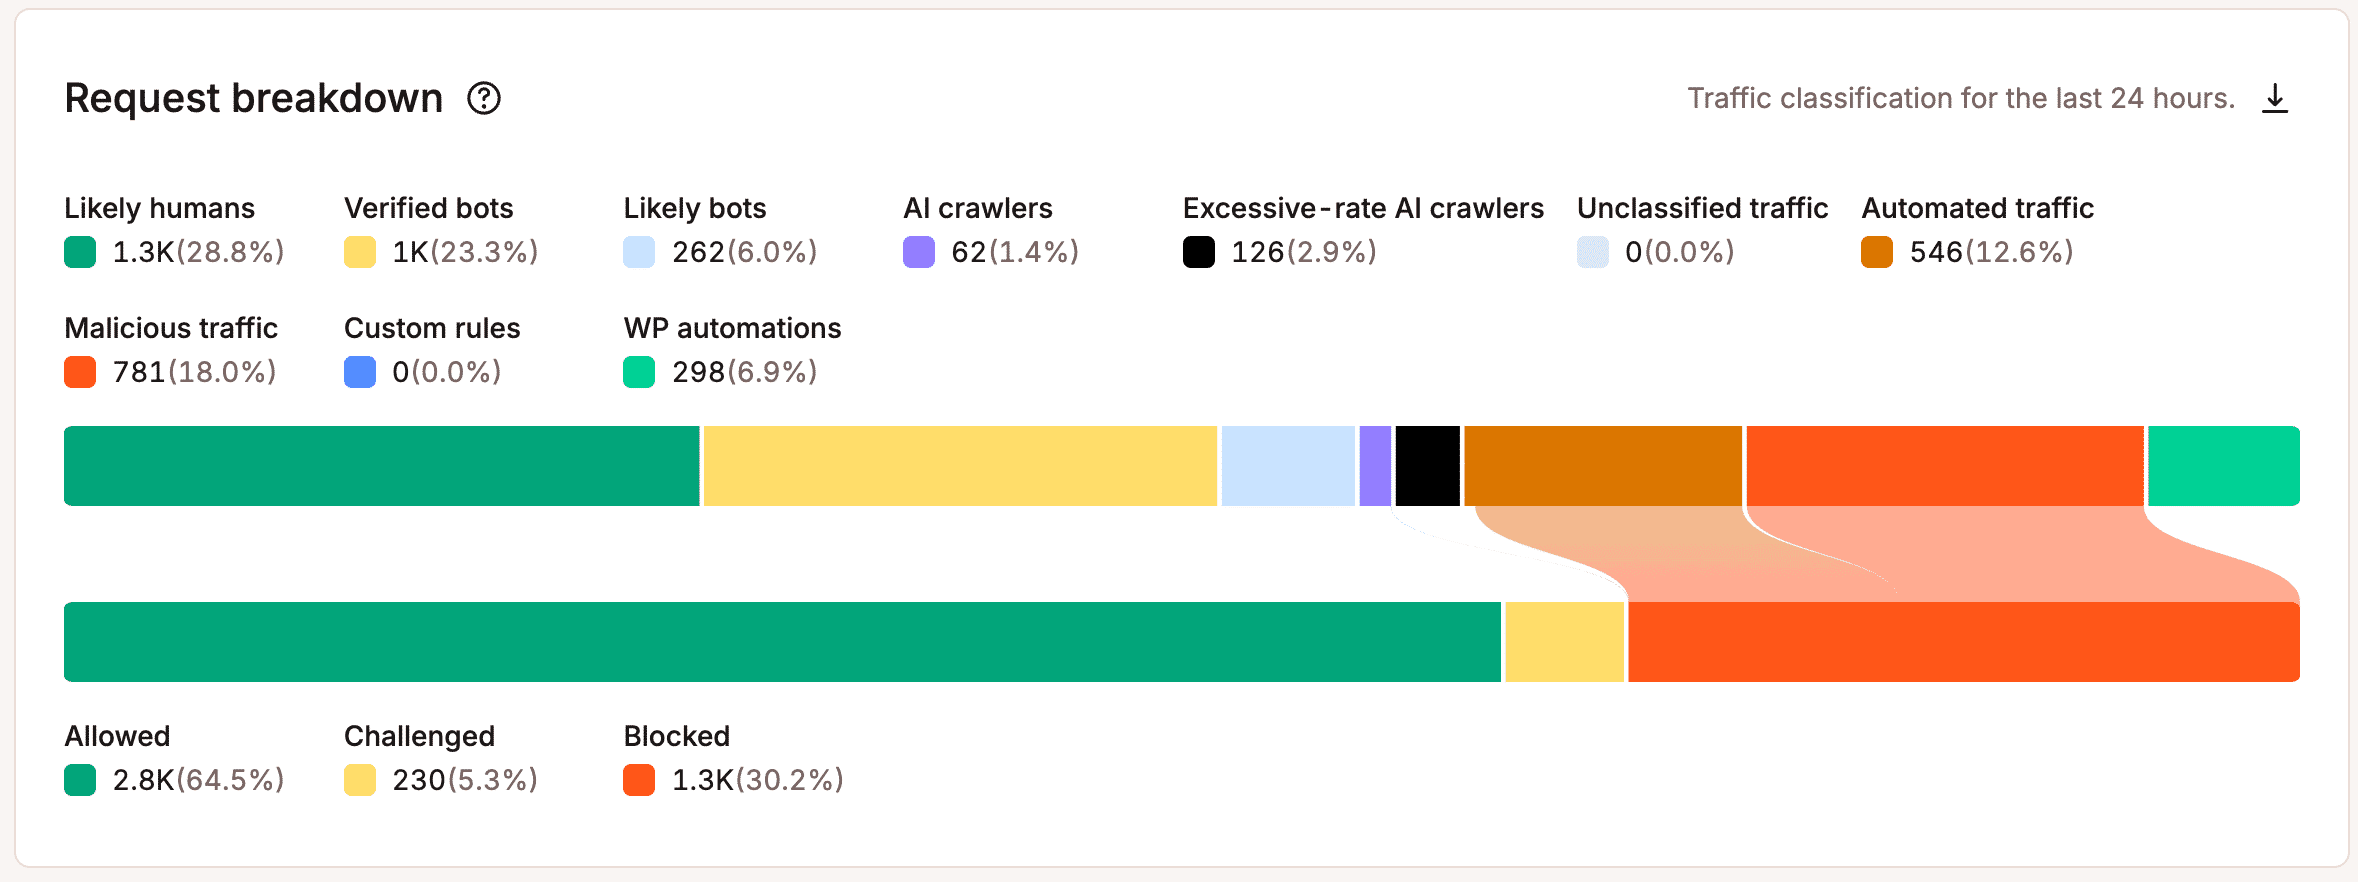
Queste visualizzazioni diventano particolarmente utili dopo aver modificato un livello di protezione o bloccato una categoria di crawler. Se il carico del server diminuisce mentre il traffico di ricerca e i referral dell’AI rimangono stabili, la modifica potrebbe funzionare esattamente come previsto. Se invece anche il traffico utile diminuisce, hai un motivo per rivedere l’impostazione o aggiungere un’eccezione più mirata.
Lo stesso vale quando le condizioni cambiano. Un crawler che oggi causa pochi problemi potrebbe aumentare la sua frequenza di richiesta in futuro, mentre un canale di scoperta tramite AI che ora invia poco traffico misurabile potrebbe diventare più prezioso col tempo.
Un semplice ciclo funziona bene: osserva, modifica, confronta, poi mantieni o annulla la modifica.
I nuovi controlli AI di Cloudflare indicano la direzione che sta prendendo la gestione dei bot
Le recenti modifiche di Cloudflare indicano la stessa strategia più ampia: gestire il traffico automatizzato in base a ciò che fa, piuttosto che applicare la stessa regola a ogni crawler basato sull’AI.
A luglio 2026, Cloudflare ha sostituito il suo approccio unico per i bot basati sull’AI con controlli separati per il traffico di ricerca, degli agenti e di addestramento . I proprietari dei siti possono autorizzare ogni categoria, bloccarla su tutto il sito o bloccarla solo sulle pagine che mostrano annunci pubblicitari. A partire dal 15 settembre, i nuovi domini utilizzano impostazioni predefinite che consentono il traffico di ricerca, bloccando invece quello degli agenti e di addestramento sulle pagine con annunci. Cloudflare modifica anche il modo in cui le sue politiche si applicano ai crawler con scopi misti che combinano attività come la ricerca e l’addestramento.
Questo cambiamento è importante perché riconosce un problema che i proprietari dei siti già affrontano. Potresti voler permettere a un crawler di indicizzare i contenuti per la scoperta senza però concedere allo stesso operatore un accesso illimitato per l’addestramento dei modelli. Un unico interruttore per i “bot AI” non riesce a esprimere bene questa preferenza.
Se hai un hosting con Kinsta, fai attenzione a non aggiungere ulteriori livelli di protezione dai bot a quelli già presenti. Se utilizzi anche la tua configurazione Cloudflare con regole WAF o anti-bot personalizzate, Cloudflare gestisce per primo quelle richieste. In alcuni casi, ciò può significare che il traffico legittimo venga bloccato prima ancora che Kinsta lo veda.
Le modifiche di Cloudflare sono utili non tanto come una nuova serie di regole che ogni sito WordPress dovrebbe copiare, quanto piuttosto come indicazione della direzione che sta prendendo la gestione dei bot. L’approccio binario sta lasciando il posto a controlli che ti permettono di preservare il traffico automatizzato utile, limitando al contempo le attività che offrono meno valore.
Le agenzie hanno bisogno di una politica, non di un’impostazione unica per ogni cliente
Per le agenzie, non esiste un’unica politica sui bot che vada bene per tutti i clienti. Un editore potrebbe essere disposto a consentire una maggiore attività dei crawler AI se questo aiuta la visibilità, mentre un sito WooCommerce ad alto traffico potrebbe aver bisogno di limiti più rigidi quando quelle richieste iniziano a competere con gli acquirenti per le risorse del server.
Un caso di studio sul lavoro svolto con Hall mostra perché queste differenze contano. Uno dei clienti WooCommerce dell’agenzia aveva problemi di downtime durante i picchi di traffico prima di passare a Kinsta. Man mano che l’azienda cresceva da 3 milioni a oltre 50 milioni di dollari di fatturato annuo, garantire prestazioni affidabili durante i picchi di domanda diventava sempre più importante.
Le regole per i bot dovrebbero riflettere il funzionamento effettivo di ogni sito. Cerca di capire quali crawler sono importanti per il cliente, quali mettono più sotto pressione il sito e quali servizi automatizzati devono rimanere accessibili. Poi modifica le regole nel tempo, man mano che il traffico cambia e le esigenze del cliente si evolvono di conseguenza.
Controlla l’accesso senza scomparire
Non devi scegliere tra rendere il tuo sito visibile ai sistemi di AI e proteggerlo da un traffico automatizzato eccessivo. La domanda giusta è: quale attività merita l’accesso, in quali casi tale accesso ha senso e quanto costa al tuo sito gestirla.
Mantieni il traffico proveniente dai motori di ricerca e dall’AI che aiuta le persone a trovare il tuo sito, ma presta attenzione a cosa succede una volta che quei crawler ci arrivano. Se un bot inizia a consumare molte risorse senza apportare grandi benefici, puoi limitarne l’accesso. Basta fare attenzione a non interferire con le automazioni di WordPress o con altri servizi da cui dipende il tuo sito.
Queste decisioni potrebbero cambiare man mano che il comportamento dei crawler, i modelli di provenienza dell’AI e le tue priorità si evolvono. L’importante è avere abbastanza visibilità per capire cosa sta succedendo e abbastanza controllo per reagire.
Scopri di più su Protezione bot di Kinsta e dai un’occhiata ai risultati del nostro rapporto sul traffico AI e bot.
Carlo è cultore appassionato di webdesign e front-end development. Gioca con WordPress da oltre 20 anni, anche in collaborazione con università ed enti educativi italiani ed europei. Su WordPress ha scritto centinaia di articoli e guide, pubblicati sia in siti web italiani e internazionali, che su riviste a stampa. Lo trovate su LinkedIn.