Aggiungi come fonte preferita su Google
Quando scopri che gran parte del traffico del tuo sito web proviene dai bot, bloccarli può sembrare la mossa più ovvia da fare. In alcuni casi, i numeri richiedono davvero una risposta immediata.
PatronView ha recentemente registrato 3,6 milioni di richieste sul proprio sito in un solo giorno, con traffico proveniente da oltre 360.000 indirizzi IP. Il proprietario del sito ha quindi creato una serie di regole Cloudflare piuttosto aggressive per tenere sotto controllo il traffico.
Anche sulla nostra infrastruttura abbiamo riscontrato casi estremi. Nel nostro rapporto sul traffico generato da AI e bot, un crawler ha generato 3,75 milioni di richieste verso URL di “aggiungi al carrello” in 24 ore. Un altro modello di loop ripetitivo ha generato centinaia di milioni di richieste prima che introducessimo una regola per bloccarlo.
Questi casi sono reali, ma non rappresentano tutti i siti web.
Nella nostra ultima analisi su oltre 5.000 siti WordPress, i bot AI rappresentavano solo l’1,57% della larghezza di banda nel sito mediano, rispetto al 17,8% al 90° percentile e al 90,3% al 99°, mentre più di 1.000 siti non hanno registrato alcuna larghezza di banda dovuta ai bot AI
È proprio questa variazione a spiegare perché individuare il traffico dei bot AI e diagnosticare un problema legato a questi bot sono due cose diverse.
Le decisioni che prenderai in seguito possono influire sulle prestazioni del sito, sulle integrazioni, sulla visibilità nei motori di ricerca e sulla capacità degli strumenti AI di trovare i tuoi contenuti. Prima di cambiare qualsiasi cosa, devi sapere cosa stanno effettivamente facendo i bot.
Ecco alcuni errori che vediamo commettere da chi gestisce siti quando saltano questo passaggio.
Errore 1: considerare la percentuale come una diagnosi
Se i crawler basati sull’AI rappresentano il 20% delle richieste del sito, quel numero da solo non ti dice se c’è un problema.
Una quota elevata di richieste verso articoli in cache potrebbe esercitare una pressione relativamente bassa sull’applicazione, mentre un numero minore di richieste che colpiscono ripetutamente i risultati di ricerca, le pagine dei prodotti filtrate o gli URL del carrello può creare molto più lavoro.
Questo è uno dei motivi per cui le statistiche sui bot a livello di rete richiedono una certa cautela quando vengono applicate a un singolo sito.
La nostra ultima ricerca ha rilevato che il numero medio di richieste dei bot basati sull’intelligenza artificiale per sito variava da 667 a 928 al giorno su quattro misurazioni, rispetto a una mediana di sole 33-67 richieste, mentre circa il 20%-27% dei siti non ha ricevuto alcuna richiesta da bot AI nel giorno in cui è stata effettuata la misurazione.
In altre parole, un piccolo gruppo di siti sottoposti a intense attività di crawling fa salire la media.
Quindi, se leggi che i bot costituiscono più della metà del traffico web, o vedi un altro proprietario di sito che segnala un traffico da bot pari al 99%, non usare quel numero per decidere di cosa ha bisogno il tuo sito.
Parti dal tuo traffico.
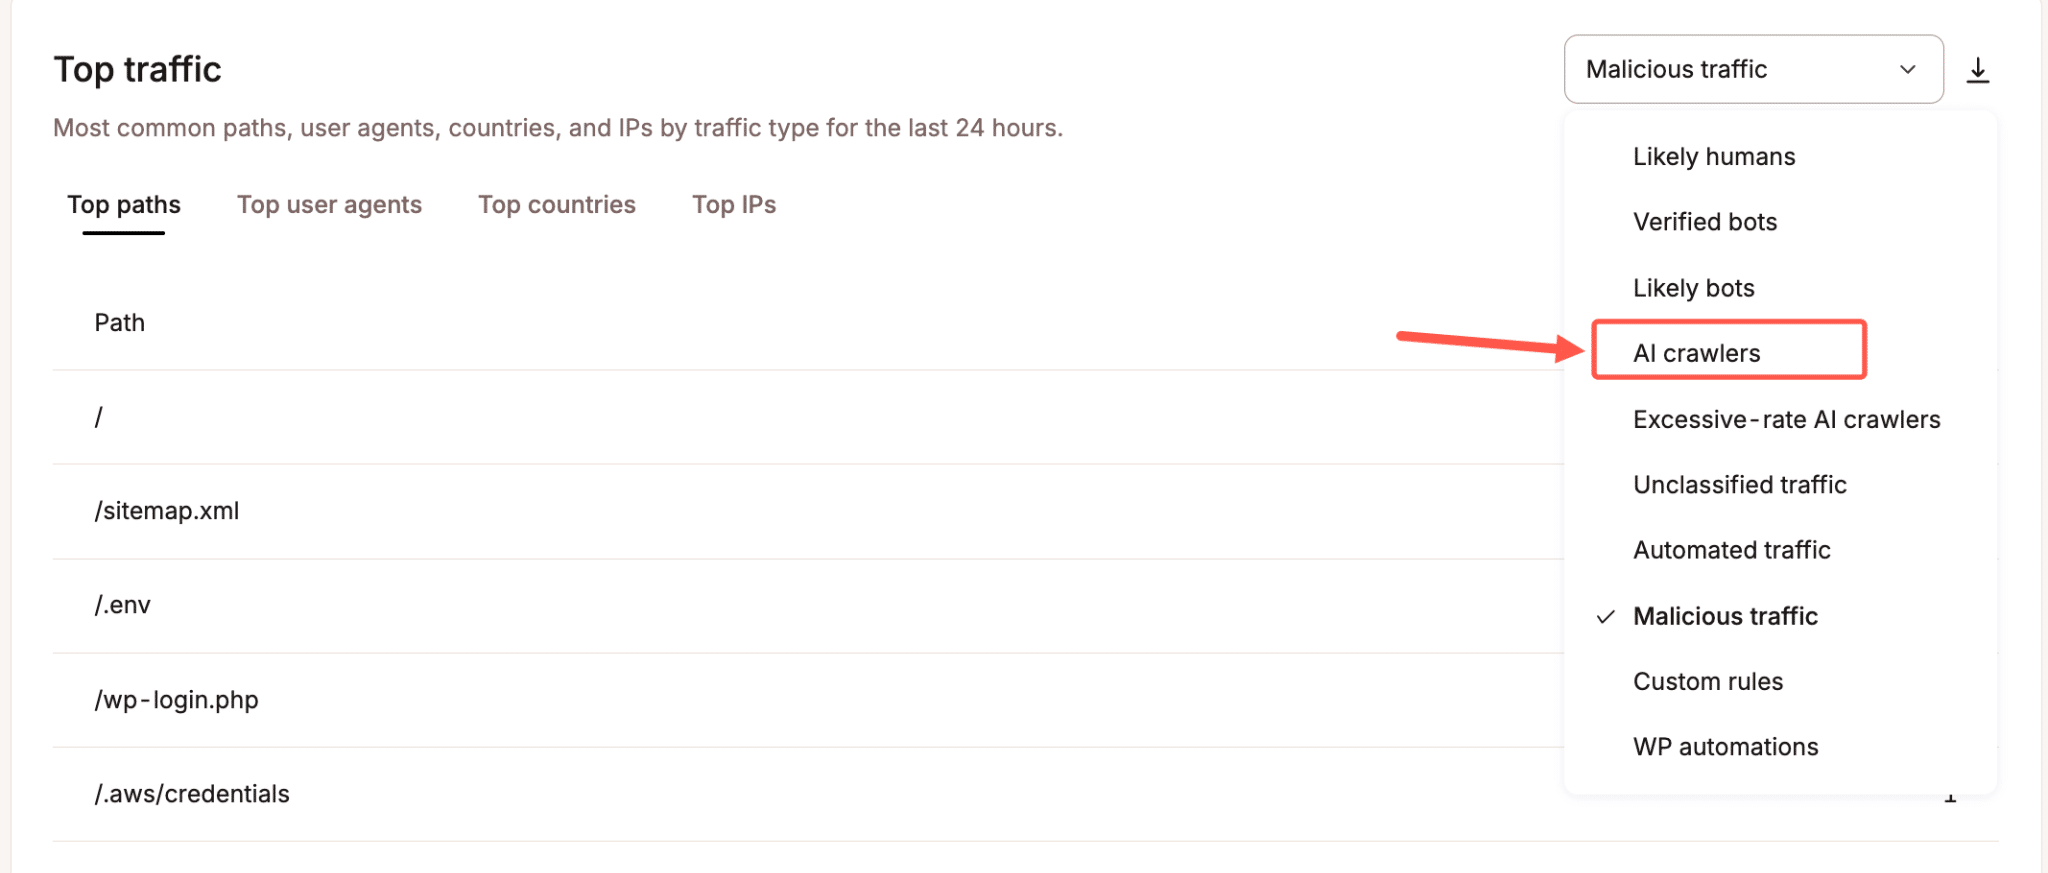
Per i clienti Kinsta, la sezione Protezione bot in MyKinsta mostra come vengono classificate le richieste, inclusi utenti probabilmente umani, bot verificati, bot probabili, crawler AI, crawler AI con frequenza eccessiva, traffico automatizzato e traffico dannoso.
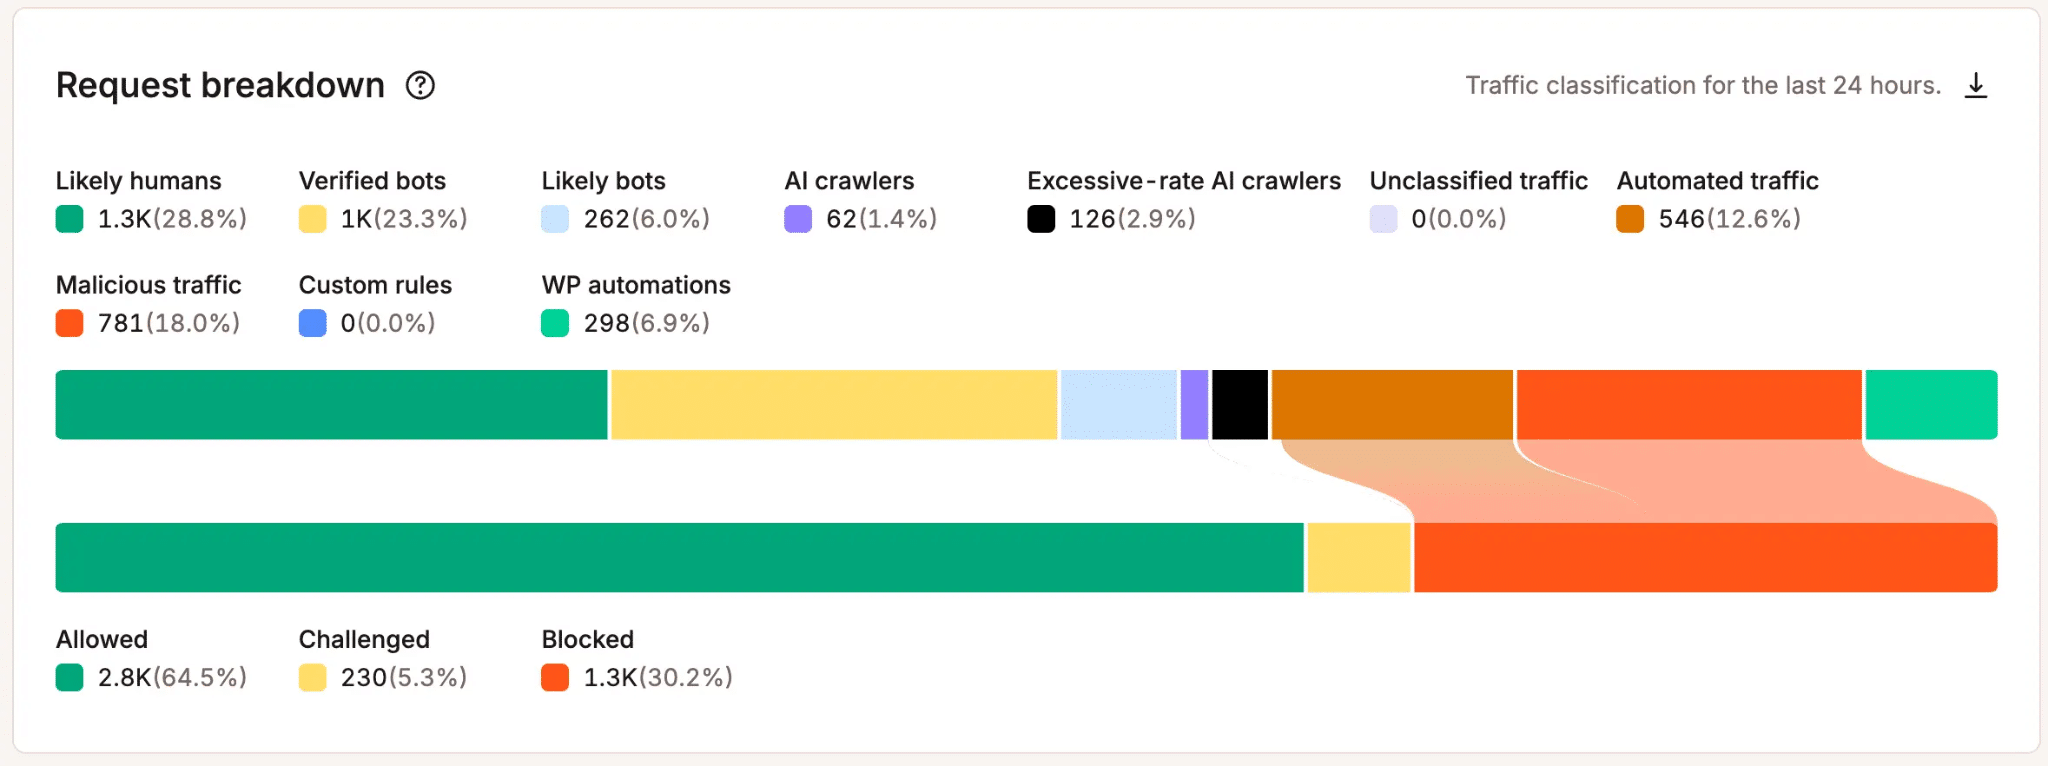
Puoi poi usare la schermata Traffico principale per vedere i percorsi, gli user agent, i paesi e gli indirizzi IP dietro a un tipo specifico di traffico.
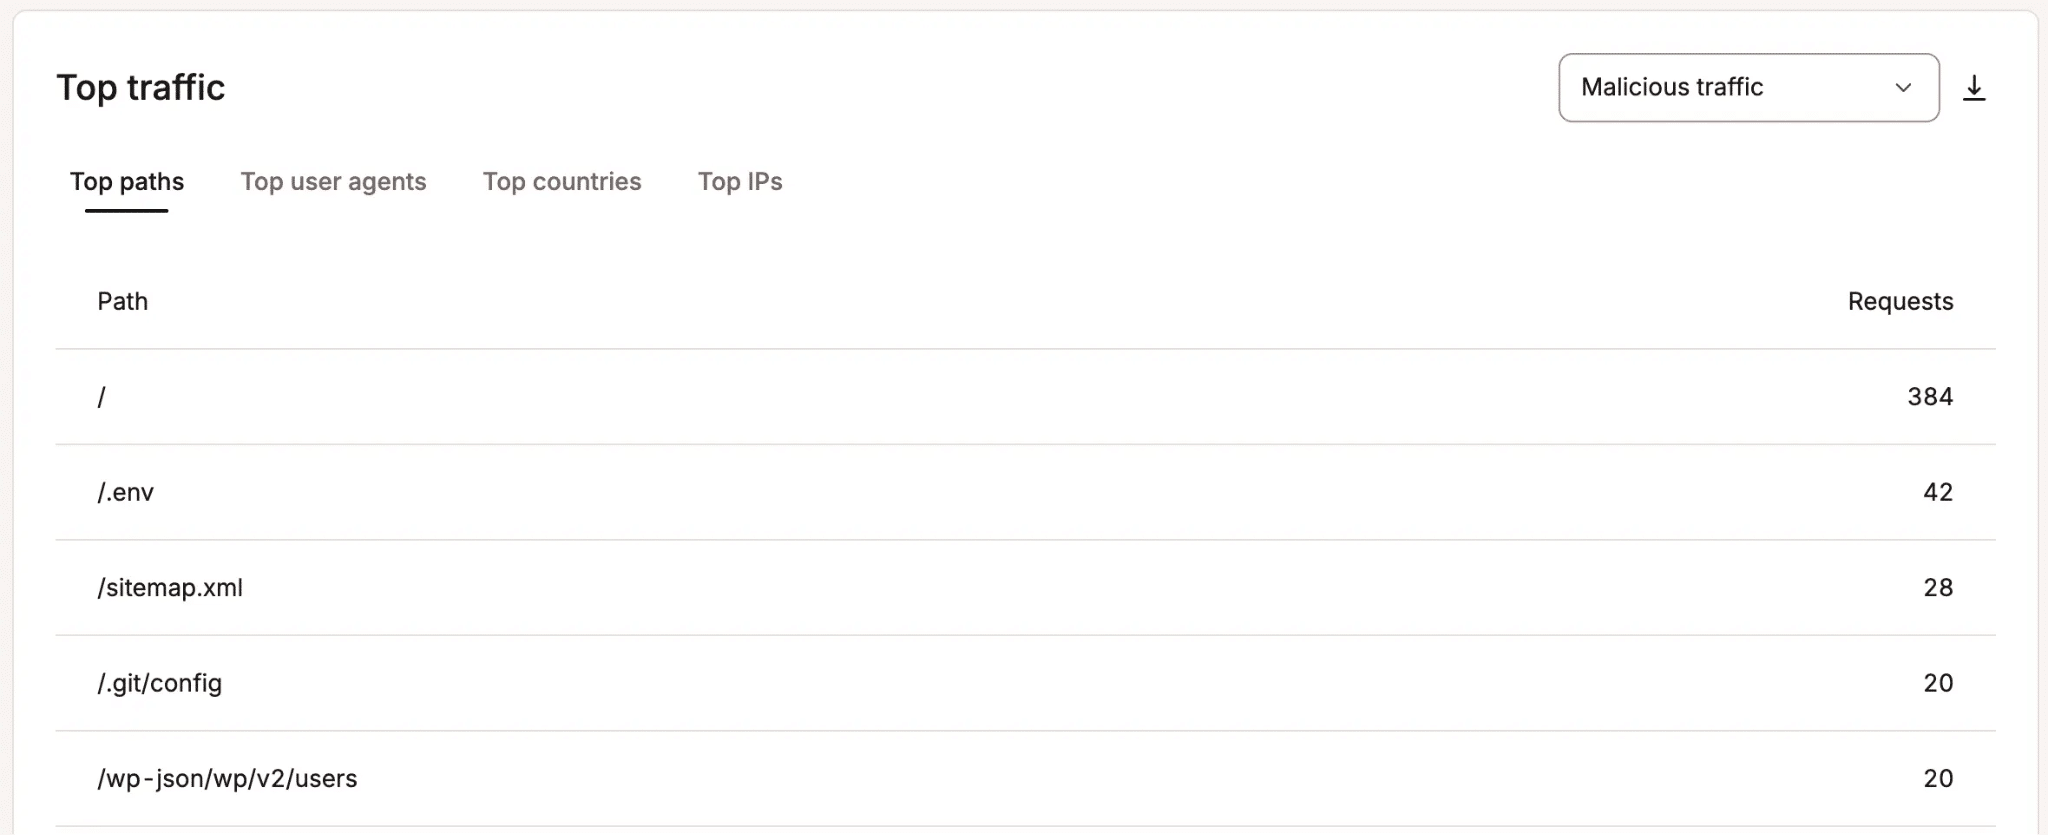
Prima di agire, dovresti essere in grado di rispondere ad alcune domande di base:
- Quanto traffico AI raggiunge effettivamente il sito?
- Quali pagine o endpoint sta richiedendo?
- Quali crawler, agenti o altri sistemi automatizzati ne sono responsabili?
- Qualche parte di quel traffico sta influenzando le prestazioni, la larghezza di banda, i thread PHP o l’esperienza dei visitatori reali?
Il nostro ultimo rapporto inquadra la questione analizzando la posizione, il modello e il profilo del traffico. Un sito che riceve pochissimo traffico generato dall’AI con un comportamento di richiesta normale potrebbe non richiedere alcun intervento, mentre uno che registra un traffico costante di crawler su URL dinamici costosi merita un’analisi molto più approfondita.
Errore n. 2: bloccare tutti i bot solo perché il traffico è automatizzato
Il termine “bot AI” ora copre diversi tipi di traffico. Alcuni crawler raccolgono contenuti pubblici per l’addestramento dei modelli o la ricerca AI, mentre altri recuperano pagine in risposta alla richiesta di un utente.
Queste differenze sono importanti quando decidi cosa consentire. OpenAI, ad esempio, usa GPTBot per i contenuti che potrebbero servire a migliorare i suoi modelli, mentre OAI-SearchBot aiuta a rendere i siti web reperibili nella ricerca di ChatGPT. Bloccare OAI-SearchBot può quindi influire sulla visibilità dei tuoi contenuti nei risultati di ricerca di ChatGPT.
Anche Anthropic fa una distinzione simile. ClaudeBot raccoglie contenuti web che possono contribuire all’addestramento dei modelli, Claude-SearchBot viene utilizzato per la ricerca, mentre Claude-User può recuperare un sito web quando qualcuno che usa Claude lo richiede.
Perplexity riferisce che PerplexityBot viene utilizzato per il proprio indice di ricerca e Perplexity-User per le richieste effettuate in risposta alle domande degli utenti.
Google offre agli editori un’impostazione separata Google-Extended che regola come i contenuti sottoposti a crawling possono essere utilizzati con Gemini. Google afferma esplicitamente che modificare tale impostazione non influisce sull’inclusione o sul posizionamento nella Ricerca Google.
Mettere tutti questi sistemi in un unico calderone chiamato “AI” significa sprecare informazioni che potresti utilizzare.
Se preferisci non impiegare le risorse del sito per l’addestramento dei modelli, puoi scegliere di limitare l’accesso ai crawler di addestramento, lasciando il sito accessibile ai sistemi di ricerca e recupero. Se il tuo problema è un agente AI che colpisce ripetutamente un endpoint dinamico, cambiare la politica relativa ai crawler di addestramento potrebbe non risolverlo.
C’è anche una questione commerciale da considerare. La nostra ricerca sui consumatori ha rilevato che il 44,7% degli intervistati ha dichiarato di visitare sempre o quasi sempre il sito web di un’azienda dopo aver ricevuto un consiglio dall’AI. Questo non significa che l’accesso dei crawler AI generi automaticamente traffico di provenienza da referral, ma significa che vale la pena considerare la scoperta tramite AI prima di prendere una decisione generica sulla visibilità.
Su Kinsta, il controllo Blocca crawler di AI permette ai clienti di bloccare i crawler AI, compresi quelli verificati, senza bloccare i crawler dei motori di ricerca tradizionali come Googlebot e Bing.
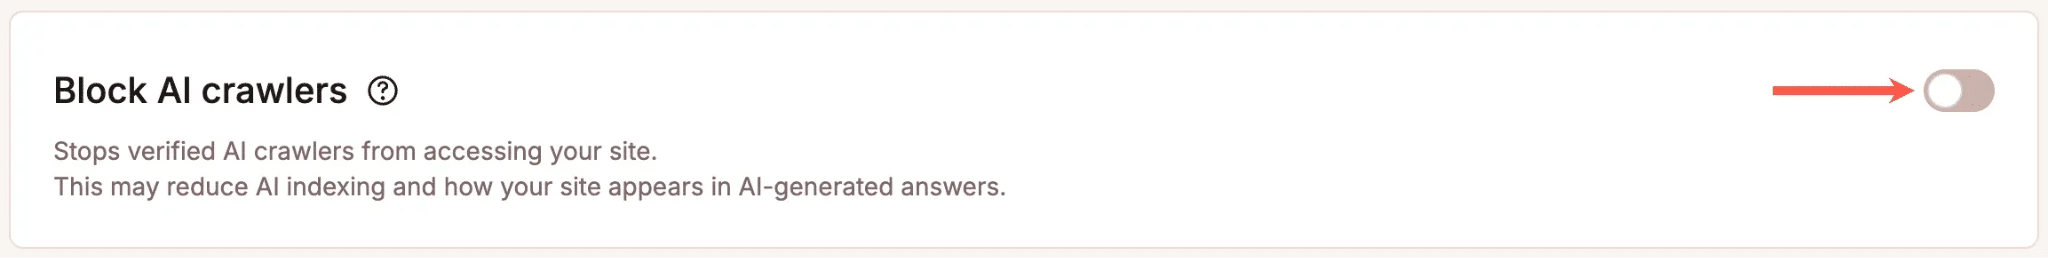
Avvertiamo inoltre i clienti che bloccare i crawler AI può ridurre la visibilità nei risultati di ricerca, nei riassunti o nei consigli basati sull’intelligenza artificiale.
Errore 3: considerare ogni picco di crawler AI come un’emergenza di sicurezza
I bot possono creare problemi di sicurezza tramite tentativi di forza bruta, attacchi DDoS, attacchi alle credenziali e altre forme di automazione abusiva, ma un crawler AI verificato che invia troppe richieste legittime è un problema di altro tipo.
Durante il nostro evento live sul traffico bot, il CTO di Kinsta Daniel Pataki ha spiegato perché lo preoccupa il modo in cui chi gestisce siti reagisce quando queste due cose vengono confuse:
“In questo caso temo una reazione eccessiva più di quanto temo una reazione insufficiente, perché non si tratta di un problema di sicurezza.”
Si riferiva al problema più ampio dei crawler AI, dove gran parte del traffico fastidioso che vediamo proviene da sistemi legittimi che eseguono il crawling in modo inefficiente, piuttosto che da un hacker che cerca di compromettere il sito.
La risposta cambia quando il sito è già in difficoltà. Se i bot stanno occupando le risorse del server, rallentando le pagine o impedendo ai clienti reali di usare il sito, la priorità è stabilizzare il sito. Daniel ha consigliato di bloccare temporaneamente il traffico dei bot quando causa un problema concreto, per poi indagare una volta che il sito è sotto controllo.
L’errore è trasformare quella misura di emergenza in una politica permanente senza capire cosa sia successo.
Protezione bot di Kinsta offre diversi livelli di controllo, dalla protezione di base contro il traffico dannoso al blocco delle automazioni o alla verifica dei bot sospetti quando serve una protezione più rigorosa. Anche i crawler AI con frequenza eccessiva possono essere sottoposti a verifica ai livelli di protezione appropriati.
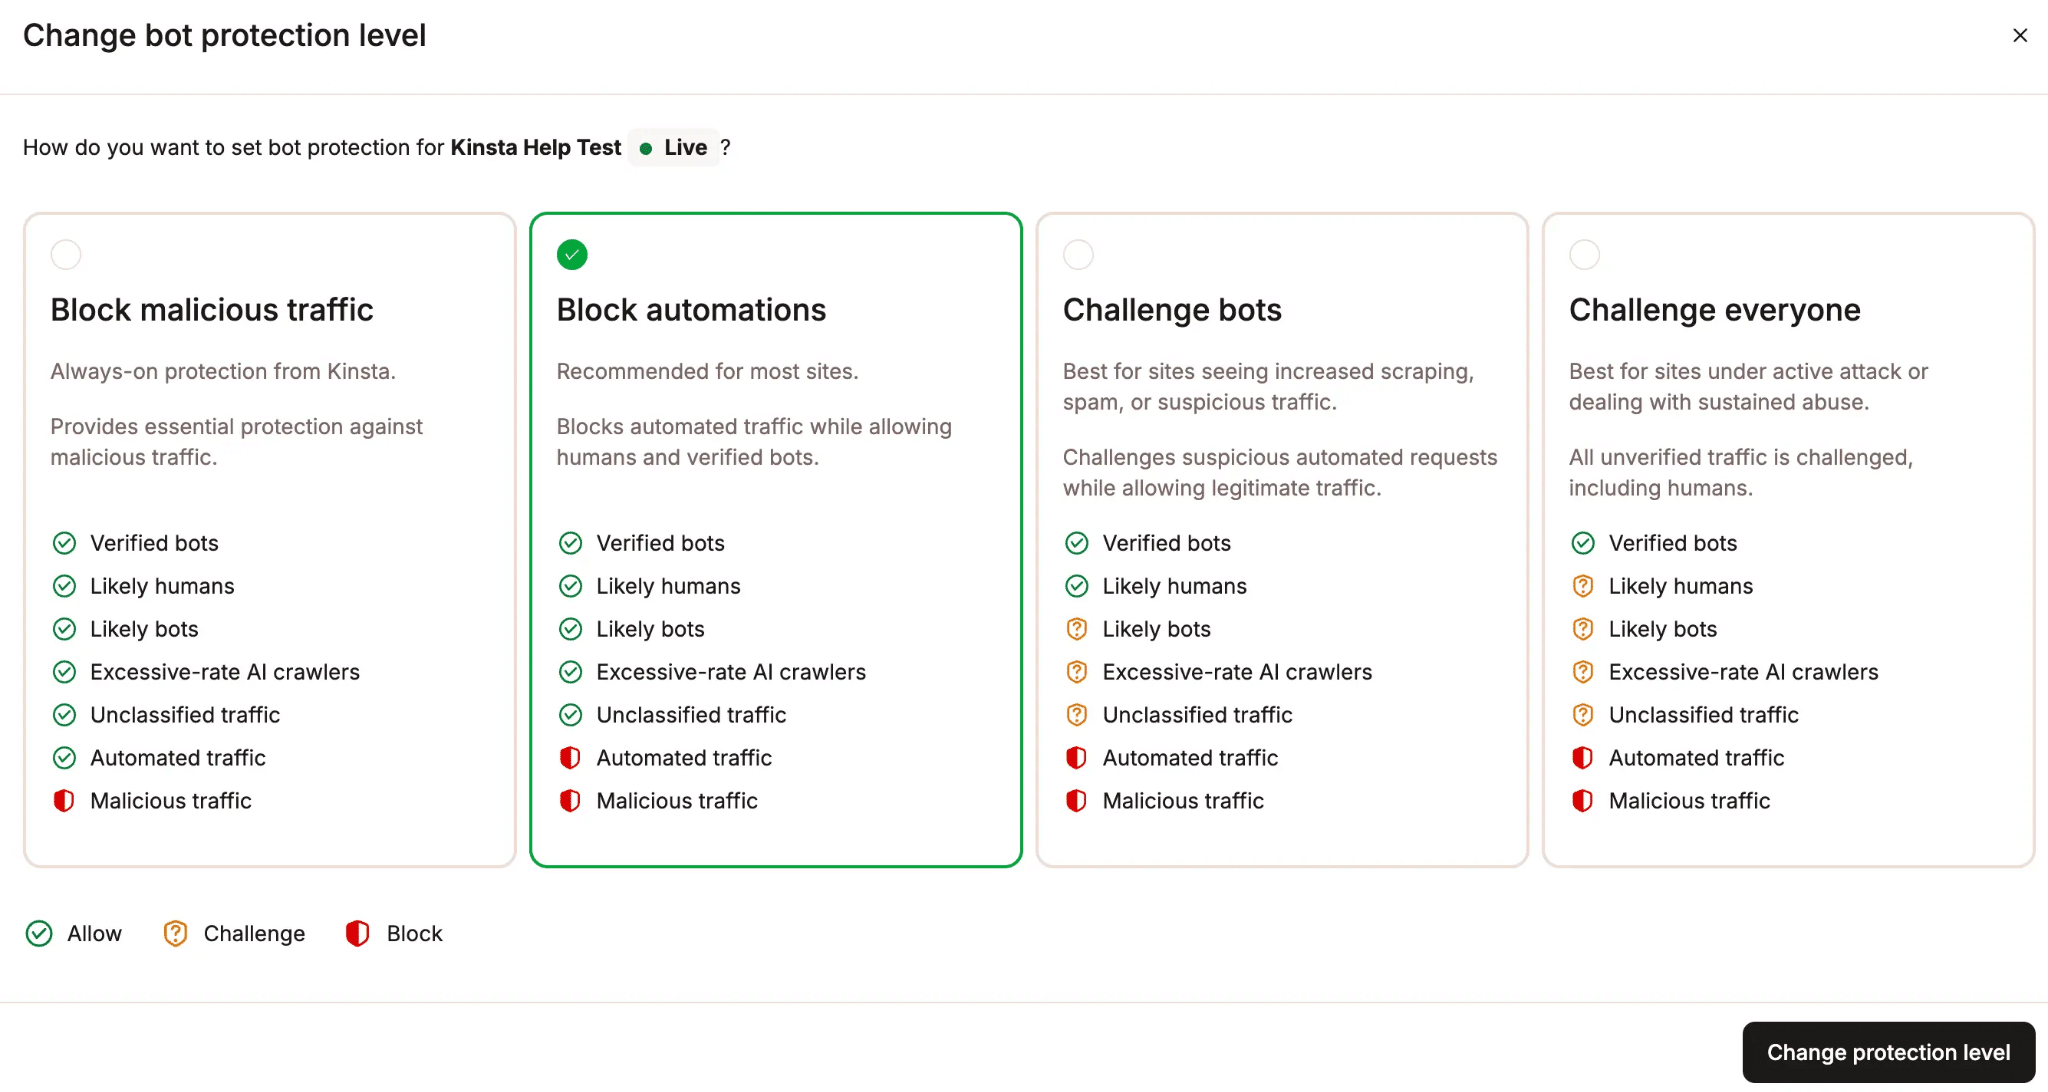
Un improvviso incidente di prestazioni potrebbe giustificare controlli più severi oggi. Una volta superato l’incidente, verifica cosa stava colpendo il sito e se quei controlli più severi abbiano ancora senso.
Errore 4: monitorare il volume delle richieste ignorando dove vanno a finire
I dati della nostra infrastruttura rendono questa differenza facile da notare. Una richiesta per un post del blog memorizzato nella cache e una per una pagina di ricerca WooCommerce non memorizzata nella cache contano entrambe come una singola richiesta, anche se la seconda può richiedere molto più lavoro al server.
Ecco un’illustrazione tratta dall’evento live “Tutta la verità sul traffico bot”:
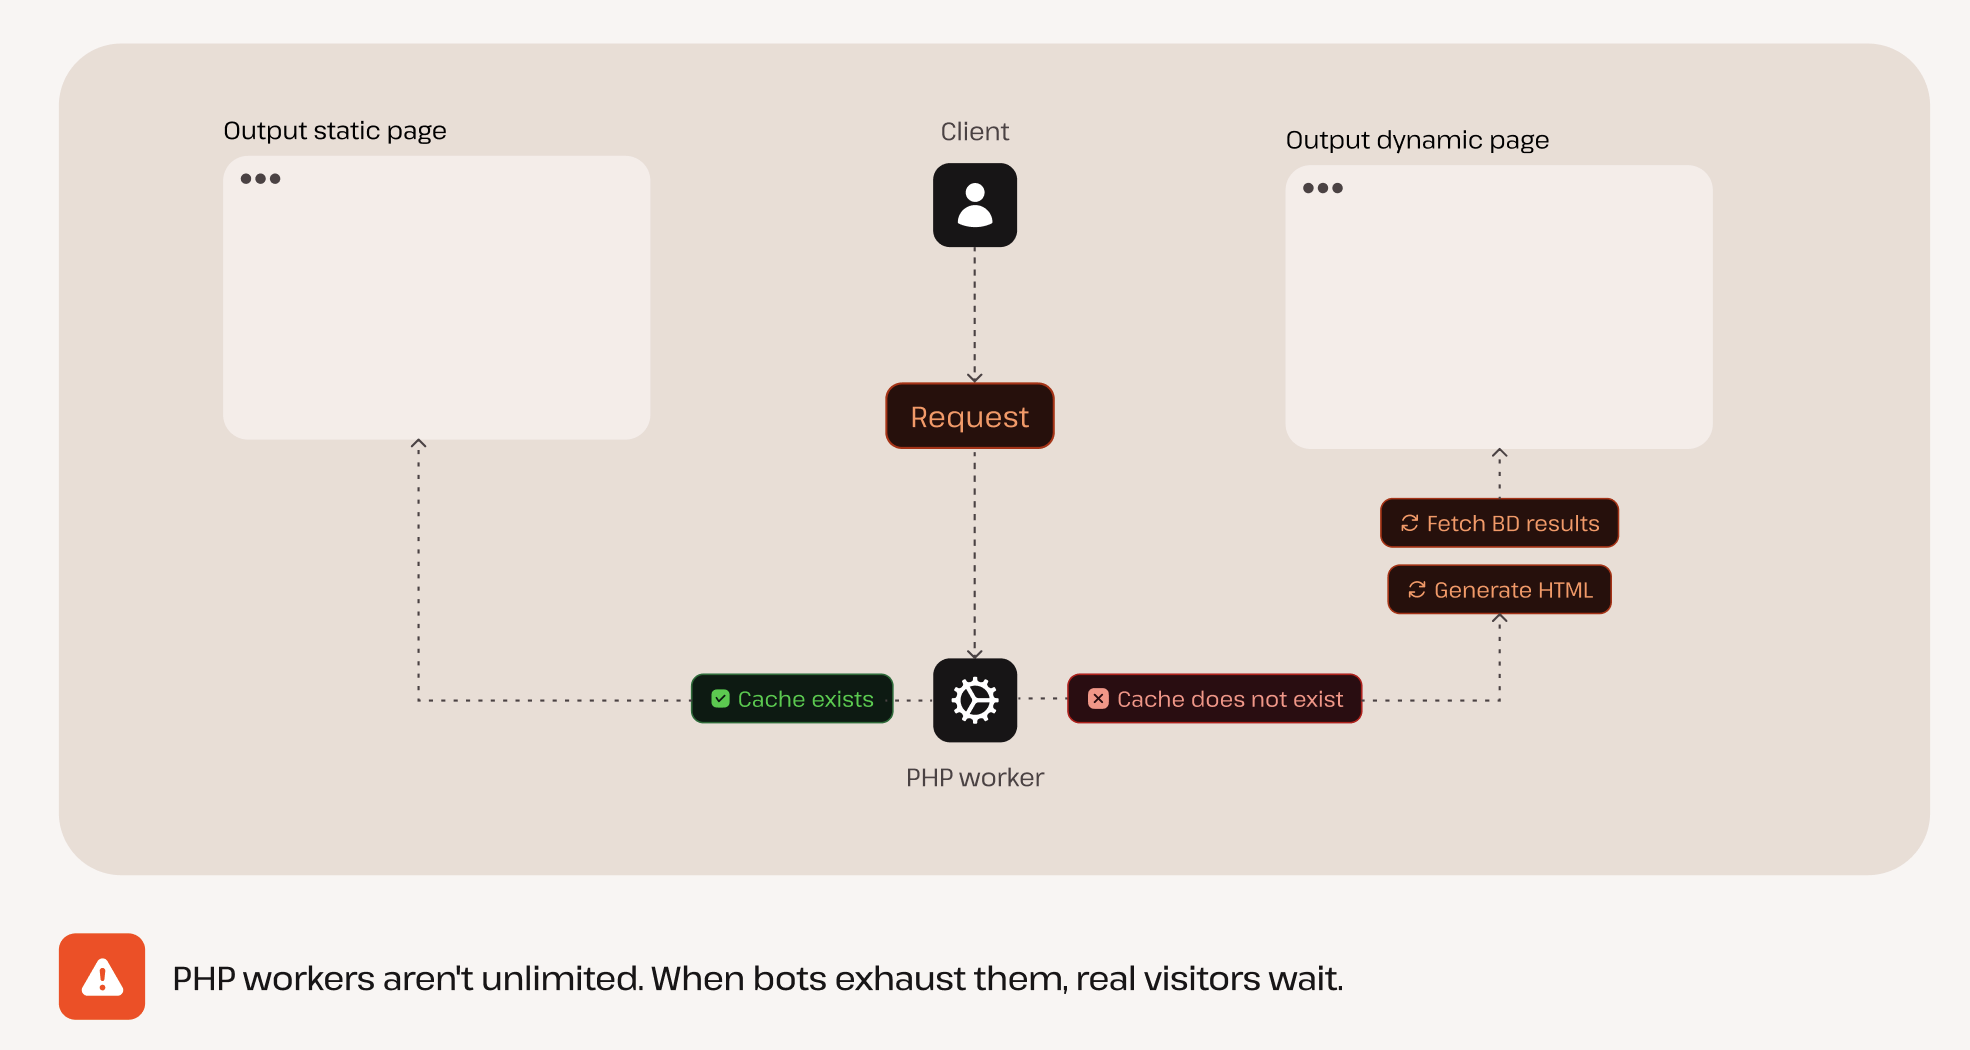
Quando è disponibile una pagina memorizzata nella cache, WordPress può gestire gran parte della richiesta senza rigenerare la pagina.
Una richiesta dinamica potrebbe richiedere un thread PHP (detto anche “worker”), query al database, la generazione della pagina e, a volte, la gestione della sessione prima che WordPress possa restituire un risultato. Le attività relative al carrello e al checkout possono aggiungere ulteriore carico di lavoro.
Ora ripeti quel processo migliaia di volte.
In base a tre misurazioni del nostro ultimo studio, tra il 76,9% e il 90,5% delle richieste dei crawler basati sull’IA riguardavano contenuti dinamici. Il traffico umano è rimasto tra il 18,3% e il 18,9%.
Questa differenza ti dice molto di più sul potenziale carico sull’infrastruttura rispetto al semplice conteggio delle richieste.
Pensa all’incidente relativo all’aggiunta al carrello che abbiamo riscontrato nella nostra ricerca sul traffico bot AI. Un crawler ha generato 3,75 milioni di richieste in 24 ore, circa una richiesta ogni 23 millisecondi. Ogni richiesta poteva costringere WordPress a lavorare per un “visitatore” che non avrebbe mai comprato nulla.
Ecco perché anche due siti con la stessa percentuale di traffico generato dall’AI possono comportarsi in modo molto diverso.
Un sito di contenuti in cui i crawler richiedono principalmente articoli memorizzati nella cache può gestire un volume elevato senza troppi problemi, mentre un negozio WooCommerce può risentirne molto prima se anche un numero minore di richieste colpisce ripetutamente la ricerca, i filtri, le azioni nel carrello, le pagine dell’account o altre pagine non memorizzate nella cache.
Una volta individuato un picco, non fermarti allo user agent.
In MyKinsta, puoi filtrare il traffico principale in base ai crawler AI e controllare i percorsi che richiedono più spesso.
Poi puoi confrontare questi dati con le informazioni sulla cache, la larghezza di banda del server e i dati sulle prestazioni per capire se quelle richieste stanno raggiungendo l’applicazione e creando carico di lavoro.
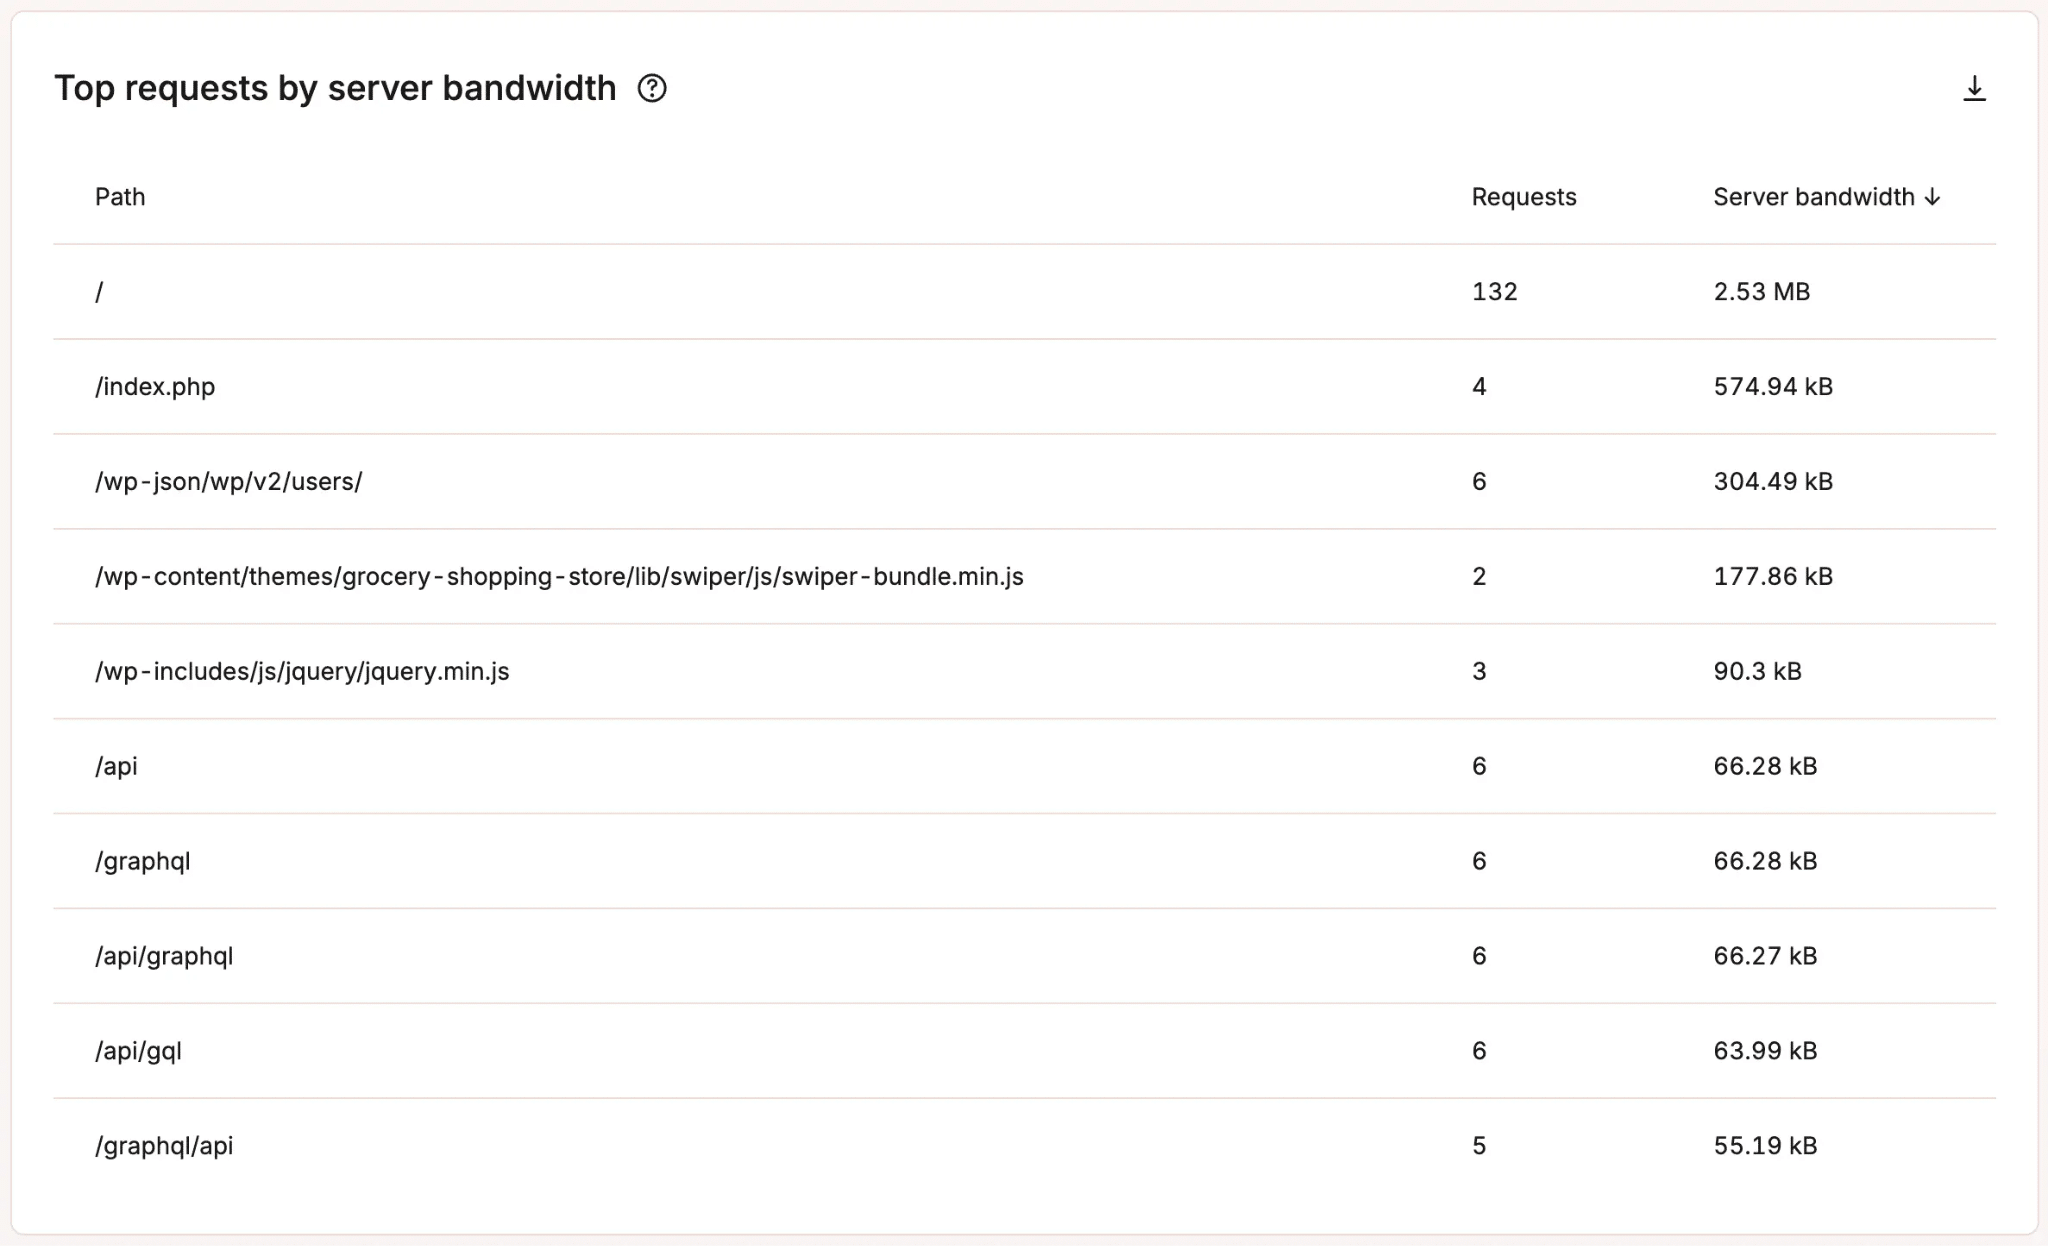
Vedere GPTBot o un altro crawler in cima a un report è utile. Se noti che migliaia delle sue richieste vanno a /blog/, questo ti dice una cosa. Se invece le vedi andare ai risultati di ricerca o a un URL WooCommerce parametrizzato, ti dice qualcos’altro.
Errore 5: bloccare il crawler e non disfarsi della “trappola di scansione”
A volte il bot non fa altro che mettere in luce un problema già presente nella tua struttura degli URL.
I siti WordPress possono generare un sacco di URL da parametri di query, pagine di ricerca, archivi filtrati, impaginazione, calendari, varianti di prodotto e azioni di e-commerce.
Una persona potrebbe rendersi conto che due URL leggermente diversi portano essenzialmente alla stessa pagina, mentre un crawler vede semplicemente più link da seguire.
Se ogni pagina genera un’altra serie di URL che sembrano nuovi, il crawler può continuare a seguirli. È così che ti ritrovi con schemi che sembrano molto più aggressivi di quanto chiunque avesse previsto.
L’abbiamo visto nella nostra precedente ricerca sull’infrastruttura. Un modello ricorrente è diventato così esteso che una singola regola progettata per individuarlo ha filtrato 550 milioni di richieste in 30 giorni.
Bloccare il crawler può fermare il carico immediato, ma non elimina il modello di URL che ha portato il crawler a trovare nuove pagine.
Quando un determinato percorso domina improvvisamente il traffico del crawler AI, controlla il percorso stesso:
- WordPress sta generando un gran numero di combinazioni di parametri?
- Un crawler può continuare a muoversi all’infinito tra gli URL del calendario o di impaginazione?
- Le pagine di ricerca e filtro espongono migliaia di varianti di URL?
- Gli URL di azione, come i link “aggiungi al carrello”, sono indicizzabili anche se non è necessario?
- Ogni URL generato deve per forza esistere ed essere individuabile?
Potresti comunque decidere di bloccare o contrastare il crawler, ma prima cerca di capire cosa lo ha spinto a tornare.
Questo è particolarmente importante per le agenzie. Se diversi siti dei clienti utilizzano lo stesso plugin, la stessa configurazione di WooCommerce, lo stesso tema o lo stesso schema di URL, un crawler aggressivo può far emergere lo stesso problema su più di un sito. Risolvere il problema può essere più utile che mantenere un elenco sempre più lungo di nomi di bot.
Errore 6: dare per scontato che il file robots.txt abbia bloccato il traffico
Una modifica al file robots.txt può essere la risposta giusta quando vuoi dire a un crawler affidabile di non accedere a una parte o all’intero sito, ma devi comunque controllare il traffico in seguito.robots.txt si basa sul fatto che il crawler rispetti l’istruzione e non impedisce fisicamente alla richiesta di raggiungere il tuo sito.
Abbiamo approfondito questa distinzione nella nostra guida ai crawler AI. robots.txt comunica le preferenze di scansione, mentre llms.txt fornisce un indice strutturato dei contenuti per gli strumenti che scelgono di leggerlo. L’applicazione delle regole avviene altrove.
Questo è importante quando scopri un problema di prestazioni, perché limitarti a modificare un file può farti pensare che il problema sia stato risolto.
Controlla i tuoi log o le analisi dei bot. Se le richieste del crawler diminuiscono dopo aver modificato il tuo file robots.txt, hai la prova che ha funzionato. Se il traffico continua, o se hai a che fare con un altro sistema automatizzato che non segue le istruzioni, ti serve un controllo di applicazione.
Lo stesso vale quando il problema è la frequenza delle richieste piuttosto che l’accesso in sé. Un crawler potrebbe essere autorizzato a leggere i tuoi contenuti, ma continuare a richiederli a una frequenza che il tuo sito non riesce a gestire comodamente.
Errore 7: copiare le regole del firewall di un altro sito senza verificare cosa potrebbero bloccare
L’esempio di PatronView è utile perché la risposta del sito si basava sui propri dati.
Il suo pubblico è prevalentemente nordamericano, quindi il proprietario blocca il traffico proveniente da altri continenti. Ha controllato i dati reali sui visitatori prima di bloccare gli utenti con versioni obsolete del browser. Inoltre, monitora quanti visitatori bloccati completano effettivamente la procedura di verifica. In un determinato periodo, solo lo 0,24% di oltre 100.000 verifiche è stato superato.
Questi numeri rendono più facile giustificare le regole per quel sito, ma applicare la stessa configurazione a un negozio di e-commerce internazionale potrebbe finire per bloccare clienti legittimi. Lo stesso rischio si presenta quando i team accumulano diversi strumenti di sicurezza perché ognuno sembra utile di per sé.
Un sito WordPress potrebbe avere una protezione anti-bot a livello di hosting, regole Cloudflare, un plugin di sicurezza, limitazioni di velocità, blocchi per paese e regole WAF personalizzate, tutte cose che prendono decisioni sulla stessa richiesta. Individuare un falso positivo diventa molto più difficile quando non sai quale livello abbia preso la decisione.
Ai clienti Kinsta sconsigliamo espressamente di combinare Protezione bot di Kinsta con ulteriori livelli personalizzati di protezione dai bot. Classificazioni contrastanti possono causare il blocco di visitatori legittimi o di integrazioni.
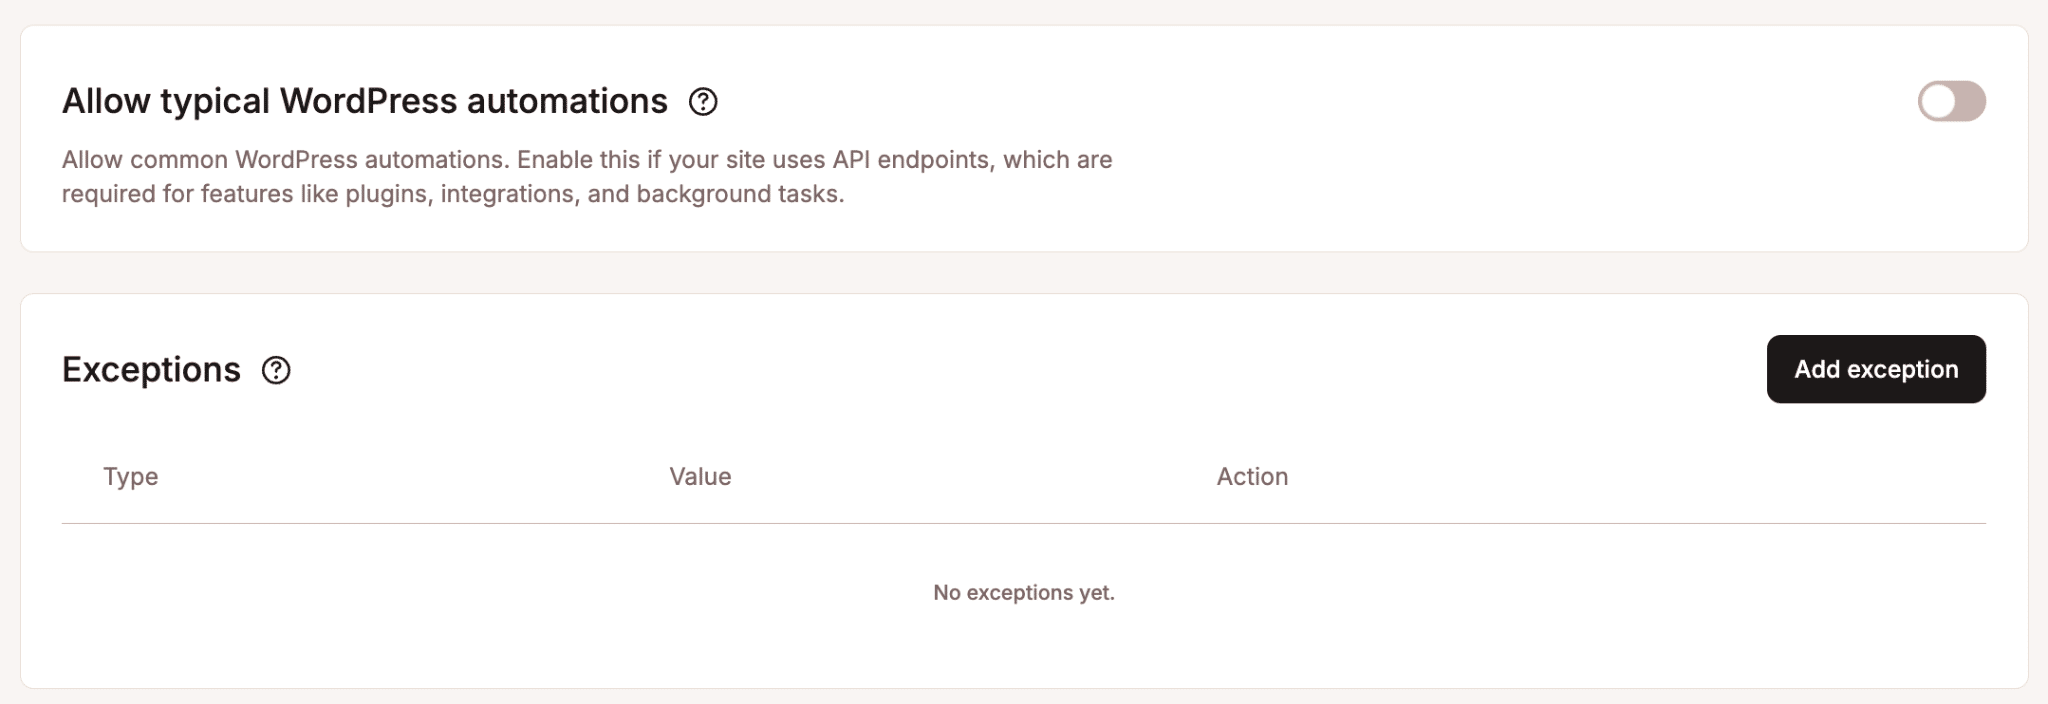
Livelli di protezione più elevati possono inoltre influire sulle automazioni legittime come API, strumenti di monitoraggio, webhook e integrazioni WordPress. MyKinsta include quindi l’opzione Consenti le automazioni tipiche di WordPress ed eccezioni di tipo “consenti sempre” per indirizzi IP, percorsi e user agent affidabili.
Se gestisci un’agenzia, un processo standard è più utile di un insieme di regole standard. Puoi applicare lo stesso processo a 20 siti dei tuoi clienti identificando il traffico, analizzandone i percorsi, verificandone le prestazioni, scegliendo un controllo, testandolo e monitorando il risultato.
Cosa fare quando scopri del traffico generato da bot AI
Inizia dall’analizzare cosa sta succedendo sul tuo sito. Se il traffico dei bot sta influenzando i visitatori reali, proteggi prima il sito, poi verifica quanto traffico stai ricevendo, quali percorsi raggiunge e quali sistemi ne sono responsabili.
Da lì, scegli la modifica più piccola che possa risolvere il problema. Potrebbe trattarsi di aggiornare un file robots.txt, bloccare o verificare un crawler, correggere un modello di URL indicizzabile, oppure non fare nulla se il traffico non sta causando danni.
I clienti Kinsta possono svolgere gran parte di questa analisi direttamente in MyKinsta. L’analisi del traffico dei bot distingue tra crawler AI, crawler AI con frequenza eccessiva, bot verificati, traffico automatizzato e altri tipi di richieste, mentre la sezione Traffico principale mostra i percorsi, gli user agent, i paesi e gli IP da cui provengono.
Puoi anche confrontare questa attività con il comportamento della cache, la larghezza di banda del server e le prestazioni PHP per capire se il traffico sta davvero mettendo sotto pressione il tuo sito prima di decidere cosa bloccare.