Bij AI-verkeer bestaat de gemiddelde website niet
Nieuwe infrastructuurdata van meer dan 5.000 WordPress sites laten zien hoe verschillend AI-verkeer per site uitpakt, en wat het verzoekvolume op zichzelf niet laat zien
Steekproef
5.000+ WordPress sites
Periode
30 dagen aan verzoeken
Bron
Kinsta infrastructuur
Samenvatting
AI-verkeer wordt vaak beschreven als een vast percentage binnen het algemene webverkeer. Onze data laten echter zien dat dat cijfer per website enorm kan verschillen. Op meer dan 5.000 WordPress sites was de AI-crawleractiviteit bijvoorbeeld laag of zelfs helemaal afwezig. En een veel kleinere groep zag activiteit die ver boven het totaal uitkwam.
Het verschil zat niet alleen in hoeveel verkeer er binnenkwam, maar ook in wat het van de site vroeg. AI-crawlers vroegen veel vaker dan menselijke bezoekers om dynamische content die niet te cachen is. Daardoor is verzoekgedrag net zo belangrijk als volume als je de impact op je infrastructuur beoordeelt.
AI verandert ook hoe mensen dingen ontdekken. In ons consumentenonderzoek gaf 44,7% van de respondenten aan altijd of meestal een bedrijfswebsite te bezoeken na een AI-aanbeveling. En 61,1% koppelt de kwaliteit van een bedrijfswebsite aan de kwaliteit van de producten of diensten.
Nu AI een grotere rol krijgt in hoe mensen zaken ontdekken, is een bezoek aan de site steeds meer een controle of de aanbeveling klopt.
Belangrijkste bevindingen
01. Bandbreedte
1,57%
van de bandbreedte op de mediane site ging naar AI-bots, tegenover 17,8% bij het 90e percentiel en 90,3% bij het 99e.
02. Volume
33-67
AI-botverzoeken kwamen er per dag binnen op de mediane site. Het gemiddelde lag 14–25 keer hoger.
03. Gedrag
77–91%
van de AI-botverzoeken ging naar dynamische of anderszins niet-cachebare content, tegenover ongeveer 18%–19% van de menselijke verzoeken.
04. Consumenten
44,7%
van de consumenten zegt altijd of meestal een bedrijfswebsite te bezoeken na een AI-aanbeveling.
05. Perceptie
61,1%
van de consumenten koppelt de kwaliteit van de website van een bedrijf aan de kwaliteit van de producten of diensten.
01. Waarom cijfers op netwerkschaal niet opgaan voor één afzonderlijke site.
Het gemiddelde geeft een verkeerd beeld
Dat bots meer dan de helft van het webverkeer voor hun rekening nemen, is geen nieuws meer. De wereldwijde data van Cloudflare komen bij verzoeken om webpagina’s uit op 57% bots en 43% mensen. Bij zulke cijfers vraag je je als site-eigenaar natuurlijk af hoeveel van je eigen verkeer nog van mensen komt.
Op de schaal waarop Cloudflare meet, klopt dat cijfer. Onze eigen data kwamen er dicht bij in de buurt. Over de WordPress sites in onze steekproef bestond een gemiddelde dag uit ongeveer 54% geautomatiseerd verkeer en 46% menselijk verkeer.
Een gemiddelde dag op het platform van Kinsta
Aandeel van alle verzoeken op een gemiddelde dag, over alle sites die Kinsta host
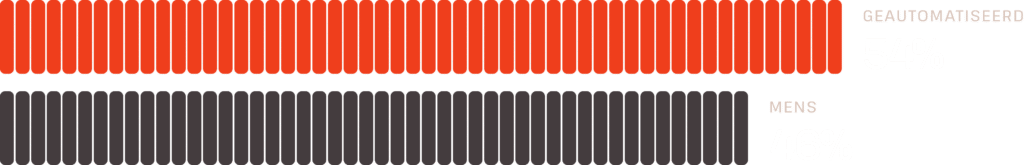
Op netwerkniveau kloppen die cijfers. Pas ze toe op één site en ze worden misleidend. Als bots wereldwijd meer dan de helft van alle verzoeken veroorzaken, ga je er al snel van uit dat jouw site ergens in de buurt van diezelfde verdeling zit.
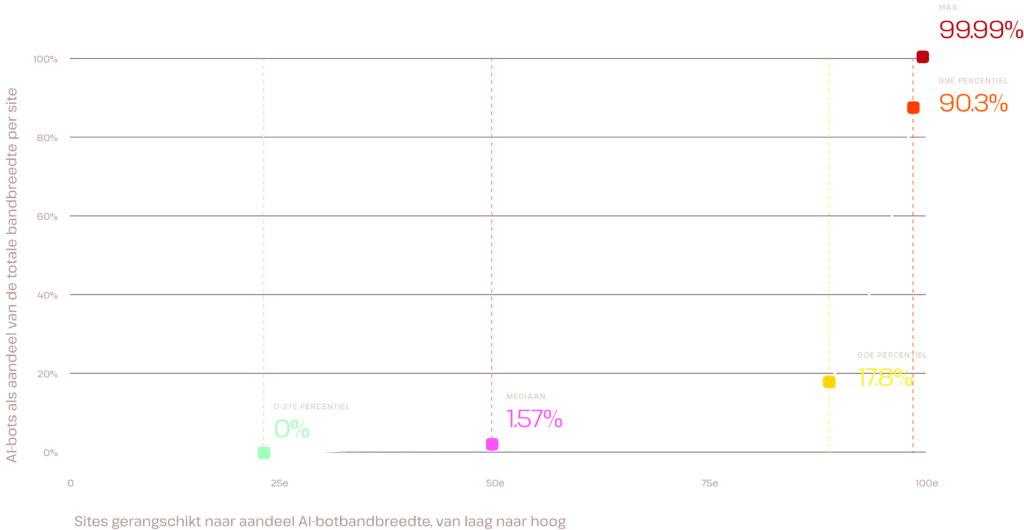
We maakten dezelfde berekening voor onze hele infrastructuur. Daarna zijn we gestopt met middelen over alle sites. Toen bleek dat de mediane site slechts 1,57% van zijn bandbreedte aan AI-bots besteedde. Meer dan 1.000 sites rapporteerden helemaal niets.
Die bevinding riep een nieuwe vraag op.
Een platformbreed percentage vertelt ons wat er over een heel netwerk gebeurt. Wat er op jouw site gebeurt, zegt het niet. En zelfs als je dat cijfer op siteniveau kent, blijft er nog een vraag open: wat vragen die verzoeken de applicatie precies te doen?
Op zoek naar dat antwoord sloeg dit rapport plotseling een andere richting in.
02. Het totaalcijfer klopte. De verdeling eronder was allesbehalve gelijkmatig.
Eén web, radicaal verschillend AI-verkeer
Het gemiddelde wordt moeilijker te verdedigen zodra je naar individuele sites kijkt.
Over alle sites in onze analyse waren AI-bots goed voor 6,13% van de totale bandbreedte. De mediane site zat op slechts 1,57%. Meer dan 1.000 van de ruim 5.000 gemeten sites registreerden helemaal niets. Aan de andere kant van de verdeling waren AI-bots goed voor 17,8% van de bandbreedte bij het 90e percentiel en 90,3% bij het 99e.
Zet je de sites op volgorde van weinig naar veel AI-verkeer, dan vormen ze samen een trap. Elke trede is zo breed als het aandeel sites dat erbinnen valt. De bovenkant is telkens een gemeten percentiel. De verticale as is logaritmisch, want op een lineaire as zou de helft van alle sites nauwelijks te zien zijn.
Aandeel van AI-bots in de totale bandbreedte van 5.168 WordPress sites, gerangschikt van laag naar hoog
6,13%
Platformbreed totaal — het ene getal waar een gemiddelde op uitkomt
1,57%
Mediane site — vier keer lager dan het totaal
57×
Zoveel keer meer bandbreedte ging bij de site op het 99e percentiel naar AI-bots dan bij de mediane site
Het aantal verzoeken liet hetzelfde scheve patroon zien. Bij vier metingen op siteniveau varieerde het gemiddelde van 667 tot 928 AI-botverzoeken per site per dag, terwijl de mediaan tussen 33 en 67 lag. Afhankelijk van de meting kreeg ongeveer 20% tot 27% van de sites helemaal geen AI-botverzoeken binnen.
Daarom zegt “AI-bots zijn goed voor 6% van het verkeer” een site-eigenaar bijna niets over zijn eigen site. Een site die vrijwel geen AI-verkeer krijgt en een site waar AI-crawlerverkeer het grootste deel van de activiteit uitmaakt, tellen allebei mee in datzelfde totaalpercentage. Infrastructuurbeslissingen beginnen dus altijd bij de site zelf.
Hetzelfde geldt voor de identiteiten achter het verkeer. De botsamenstelling veranderde tijdens de meetperiode. Op rustige dagen waren Meta en Amazon goed voor een groot deel van de AI-crawleractiviteit, terwijl andere crawlers op andere momenten aandeel wonnen. De mix die een specifieke site of een heel platform bereikt, moet je meten. Wat je niet moet doen? Dingen blind aannemen.
Eerste vraag
Hoeveel AI-crawlerverkeer bereikt deze site eigenlijk?
Tweede vraag
Wat gebeurt er als het daar aankomt?
03. Een verkeersrapport telt elk verzoek op dezelfde manier. Servers niet.
Wat AI-verkeer van de site vraagt
Dat bots goed zijn voor meer dan de helft van het webverkeer, is geen nieuws meer. Volgens de wereldwijde statistieken van Cloudflare ligt de verhouding bij verzoeken voor webpagina’s op dit moment op 57% bots en 43% mensen. Bij het zien van zulke cijfers vraagt elke website-eigenaar zich af hoeveel van het eigen verkeer nog van mensen komt. Een verkeersrapport telt elk verzoek op dezelfde manier, terwijl het ene verzoek de server veel meer werk kost dan het andere.
Een verzoek dat vanuit de cache kan worden beantwoord en een verzoek dat een nieuwe, dynamische reactie vereist, staan allebei als “één verzoek” in een verkeersrapport. Het volume vertelt je dus hoeveel AI-crawleractiviteit een site bereikt, maar niet wat er gebeurt als die verzoeken worden afgehandeld.
We hebben eerst getest of AI-crawlers per verzoek meer data verstuurden. Over vijf metingen genomen waren ze goed voor gemiddeld 6,33% van de verzoeken en 6,42% van de bandbreedte. Die twee cijfers lagen nooit meer dan ongeveer één procentpunt uit elkaar.
Het grootste verschil zat in de manier waarop die verzoeken werden afgehandeld. Gemiddeld over drie metingen werd 76,3% van de menselijke verzoeken uit de cache beantwoord, tegenover 10,4% van de AI-crawlerverzoeken. Bij gewone cache-misses lagen de cijfers veel dichter bij elkaar: ongeveer 3,8% voor mensen en 4,3% voor AI-crawlers.
Het dynamische verkeer verklaarde het grootste deel van dat verschil. Gemiddeld ging 84,1% van de AI-crawlerverzoeken naar dynamische content, tegenover 18,6% van de menselijke verzoeken. Dat patroon hield stand bij alle drie de metingen: het dynamische AI-crawlerverkeer varieerde van 76,9% tot 90,5%, terwijl menselijk verkeer tussen 18,3% en 18,9% bleef. Juist bij het zoeken naar dat antwoord nam ons rapport een onverwachte wending. Het cijfer klopt op de schaal waarop Cloudflare meet, en onze eigen data kwam er dicht bij in de buurt. Bij de WordPress sites in onze steekproef bestond een gemiddelde dag uit ongeveer 54% geautomatiseerd verkeer en 46% menselijk verkeer.
Wat de server per 100 verzoeken moest doen
Dezelfde soort werk, een tegenovergestelde samenstelling. Vergelijk de twee balken: bij menselijk verkeer is de verdeling bijna precies omgekeerd.
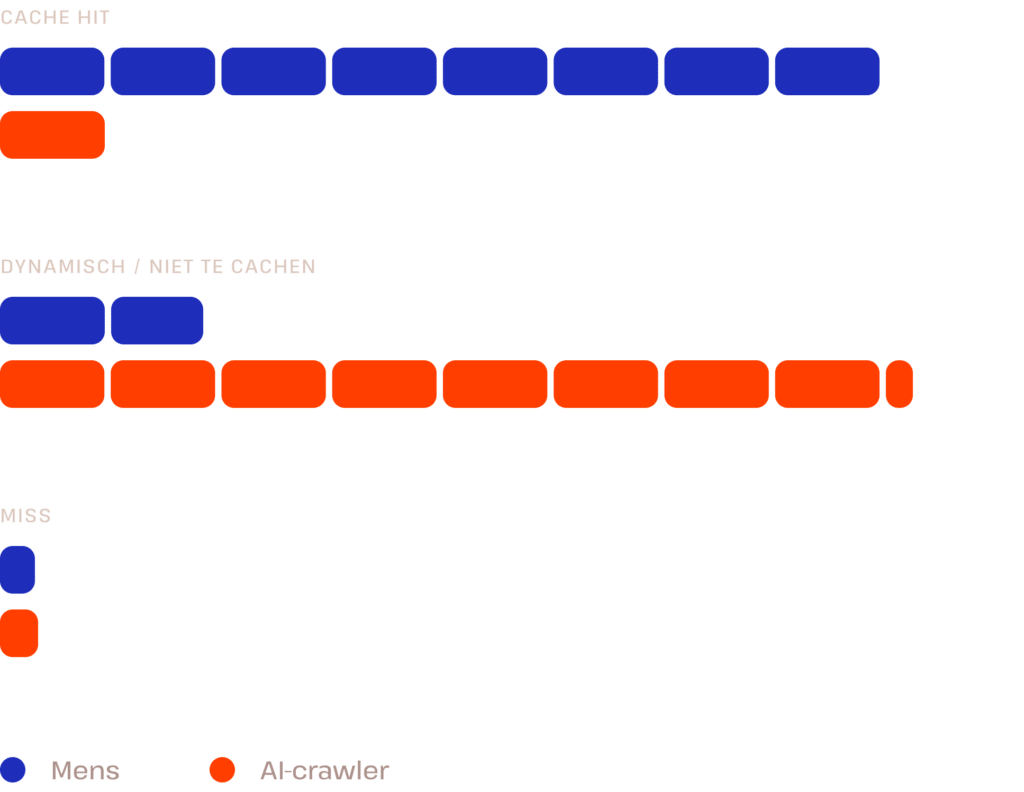
De waarden zijn gemiddelden van drie meetdagen.
“Het aantal verzoeken vertelt je alleen hoeveel verkeer er binnenkwam. Wat telt voor de infrastructuur, is waar die verzoeken naartoe gaan en wat de site moet doen om ze te beantwoorden.”
Daniel Pataki
CTO, Kinsta
Bij WordPress sites kan dynamische content bestaan uit zoekresultaten, gefilterde overzichten, variaties in query-strings, winkelacties en andere reacties die niet zomaar vanuit een bestaande cacheversie kunnen komen. In ons eerdere rapport over AI-botverkeer merkten we op dat één crawler in 24 uur 3,75 miljoen “toevoegen aan winkelwagen”-verzoeken genereerde. Een ander herhalend patroon leverde over een langere periode honderden miljoenen verzoeken op.
Dit patroon verklaart waarom verkeersvolume op zichzelf geen volledige maatstaf is voor AI-activiteit. Twee sites kunnen een vergelijkbaar aandeel AI-verkeer krijgen en toch heel verschillende eisen aan de applicatie stellen, afhankelijk van waar die verzoeken naartoe gaan.
Niet elk botverzoek is een crawler
“AI-verkeer” is een verzamelnaam voor een groot aantal verschillende gedragingen. Sommige systemen crawlen sites op grote schaal, andere halen pagina’s op voor een zoekopdracht of naar aanleiding van een gebruikersvraag. OpenAI, Anthropic en Perplexity gebruiken allemaal aparte identiteiten voor crawlers en voor door gebruikers geactiveerde verzoeken, in elk geval voor een deel van deze functies.
Dat onderscheid is belangrijk, want hetzelfde aantal verzoeken kan heel ander gedrag vertegenwoordigen. Een crawler die systematisch door een site loopt, is iets anders dan een agent die één pagina ophaalt voor iemand met een vraag. Serverlogs kunnen wel laten zien welk systeem het verzoek doet, maar niet altijd met welke bedoeling.
111,8M
AI-crawlerverzoeken van 30 dagen
8,3M
Verzoeken van AI-client-agents in dezelfde periode
Dat onderscheid zagen we terug in onze eigen data. Dat onderscheid zagen we terug in onze eigen data.Het assistentverkeer bleef het grootste deel van die periode relatief klein en steeg daarna kortstondig sterk. Verzoeken die aan Claude, Perplexity en Mistral te koppelen zijn, groeiden veel sneller dan ChatGPT-verkeer.
Voor beheerders is de take-away dat je AI-activiteit beter kunt zien per type en gedrag dan als één brede categorie “AI-bot”.
04. Serverlogs laten maar één kant van het traject zien.
Wat er gebeurt nadat AI iemand naar je site doorstuurt
Tot nu toe hebben we in dit rapport naar de website vanaf de serverkant gekeken. Maar serverlogs laten maar een deel zien van wat er gebeurt zodra AI in het traject zit.
AI-systemen zitten steeds vaker tussen mensen en de bronnen die ze vroeger misschien rechtstreeks bereikten via een zoekopdracht, een aanbeveling of een link. Soms leidt die omweg tot een bezoek aan de oorspronkelijke website. Soms ook niet.
Wat gebeurt er als iemand wél doorklikt?
44,7%
van de respondenten altijd of meestal een bedrijfswebsite te bezoeken na een AI-aanbeveling.
61,1%
van de respondenten dat ze de kwaliteit van een bedrijfswebsite koppelen aan de kwaliteit van de producten of diensten.
Dat cijfer betekent niet dat 44,7% van het websiteverkeer via AI binnenkomt. Het wijst ook niet in alle gevallen op een direct verwijzingspad. En het bewijst niet dat die bezoekers eerder converteren dan iemand die via zoek of een ander kanaal binnenkomt.
Wat het wél laat zien: de bedrijfswebsite doet er nog steeds toe. Mensen komen er nog steeds langs, zelfs nadat AI ze al heeft verteld wat ze er kunnen verwachten.
Deze twee bevindingen veranderen hoe we infrastructuurdata moeten lezen. AI-systemen kunnen een website bezoeken nog voordat iemand hem zelf ziet. Wie er uiteindelijk aankomt, heeft misschien al elders een aanbeveling, samenvatting of indruk opgedaan. Dat bezoek kan daarom een ander doel dienen dan de eerste ontdekkingsklik waar websites traditioneel omheen zijn gebouwd.
Misschien wil zo iemand controleren of het bedrijf echt bestaat, een bewering verifiëren, prijzen bekijken, productdetails bestuderen, alternatieven vergelijken of bepalen of de aanbeveling het vertrouwen waard is.
De website moet op dat moment gewoon presteren.
“AI verandert misschien hoe mensen bij een website uitkomen, maar aan het eind van een lange keten zit nog altijd een mens die om informatie vraagt.”
Daniel Pataki
CTO, Kinsta
Voor technische teams worden betrouwbaarheid en reactiesnelheid dus een nog belangrijker onderdeel van de bredere bedrijfservaring. En voor marketeers en merkeigenaren geldt: AI-ontdekking heeft de onderliggende infrastructuur niet uit het klanttraject gehaald.
Beide kanten komen samen in hetzelfde systeem.
AI-systemen vragen de content op.
Mensen beoordelen wat ze aantreffen.
Nu beide doelgroepen op dezelfde site uitkomen, is inzicht in je eigen verkeer de logische volgende stap.
05. Positie, patroon, profiel: drie vragen die je voor je eigen site moet kunnen beantwoorden.
Een AI-verkeersdiagnose op siteniveau
De bevindingen in dit rapport wijzen op een eenvoudige manier om AI-verkeer voor één site te beoordelen. Begin niet bij een sectorgemiddeld, maar kijk naar drie dingen: hoeveel AI-verkeer je krijgt, wat die verzoeken doen en wie of wat erachter zit.
“AI-verkeer vraagt niet op elke site om dezelfde reactie. De juiste beslissing begint met begrijpen wat er echt op je site binnenkomt en of het een probleem oplevert.”
Daniel Pataki
CTO, Kinsta
01. Positie
Hoeveel AI-verkeer krijg je eigenlijk binnen?
Begin met je eigen nulmeting over een zinvolle periode. Kijk naar AI-crawlerverzoeken en bandbreedte en vergelijk die met de verdeling in dit onderzoek, niet alleen met het platformbrede gemiddelde.
In onze bandbreedteanalyse lag de mediane site op 1,57%, het 90e percentiel op 17,8% en het 99e percentiel op 90,3%. Aan de kant van de verzoeken kreeg ongeveer 20% tot 27% van de sites op een gemeten dag helemaal geen AI-crawlerverzoeken binnen.
Het doel is niet om elke site een vast percentiel te geven. Het gaat erom of je eigen AI-verkeer relatief beperkt is, in het midden van de verdeling valt of juist naar de bovenkant neigt.
02. Patroon
Wat vragen die verzoeken van de site?
Kijk waar AI-crawlers naartoe gaan: de paden die ze opvragen, terugkerende URL-patronen, queryparameters, zoek- en filterpagina’s, winkelacties en andere dynamische routes.
Onze data laten zien waarom dat uitmaakt. Bij drie metingen ging 76,9% tot 90,5% van de AI-crawlerverzoeken naar dynamische content, tegenover ongeveer 18% tot 19% van de menselijke verzoeken.
Krijg je een matige hoeveelheid AI-verkeer dat vooral op gecachete pagina’s landt, dan geeft dat een heel ander beeld van je infrastructuur dan hetzelfde volume op dynamische routes.
03. Profiel
Wie of wat zit er achter die verzoeken?
Scheid tot slot het verkeer waar dat kan. Een crawler die breed over een site beweegt, is iets anders dan een door een gebruiker geactiveerde agent die één pagina ophaalt voor een specifieke taak. En agressieve automatisering vraagt misschien weer om een andere aanpak.
Een perfecte classificatie is niet het doel. De vraag die telt: verklaren de bron en het gedrag van het verkeer wat je ziet, en is er iets dat nader onderzoek verdient?
Positie, patroon en profiel vormen samen een beeld op siteniveau dat een sectorbreed percentage niet geeft. Een site met weinig AI-verkeer en normaal verzoekgedrag heeft waarschijnlijk geen extra aandacht nodig. Een site aan de bovenkant van de verdeling, waar crawlers steeds weer dynamische routes opvragen, verdient een nadere blik.
Conclusie
Waar het om gaat, is wat er op jouw site gebeurt
AI-verkeer pakt niet op elke site hetzelfde uit. Een platformbreed percentage kan beschrijven wat er over duizenden websites gebeurt en toch bijna niets zeggen over die van jou.
Diezelfde ongelijkheid geldt voor wat die verzoeken van de site vragen. AI-crawlers gebruikten in onze steekproef niet onevenredig veel bandbreedte, maar vroegen wel veel vaker dan menselijke bezoekers om dynamische content. Waar die verzoeken naartoe gaan en hoe de site ze moet beantwoorden, telt net zo zwaar als het aantal verzoeken.
Al die infrastructuurkosten zouden er niet toe doen als niemand langskwam. Maar mensen komen wel. Veel consumenten bezoeken de site van een bedrijf nog steeds na een AI-aanbeveling, en wat ze daar aantreffen bepaalt wat ze van dat bedrijf vinden. De website staat steeds vaker aan beide kanten van dat traject: hij levert informatie waar AI-systemen bij kunnen en een ervaring die mensen zelf kunnen beoordelen.
Voor site-eigenaren en -beheerders zijn sectorgemiddelden nuttige context, maar de beslissingen die ertoe doen, beginnen bij je eigen verkeer. Hoeveel AI-activiteit bereikt je site, wat doen die verzoeken en wie of wat zit erachter? Dat zijn de vragen die een brede verandering op het web omzetten in iets dat je echt kunt meten en beheren.
de actie
Begin bij je eigen site
Algemene gemiddelden kunnen de omvang van AI-verkeer laten zien. Wat er op een specifieke website gebeurt, vertellen ze je niet. Meet hoeveel AI-verkeer je site bereikt, bekijk waar die verzoeken naartoe gaan en achterhaal waar mogelijk waar ze vandaan komen. Bepaal daarna of je uitkomsten vragen om monitoren, optimaliseren of ingrijpen.
Positie
Hoeveel komt er bij je binnen?
Patroon
Wat doen die verzoeken?
Profiel
Wie of wat zit erachter?
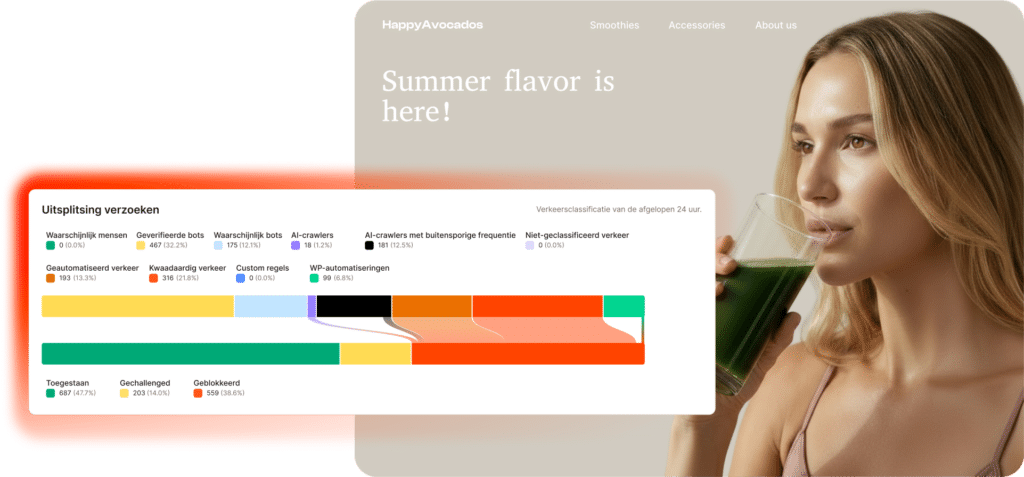
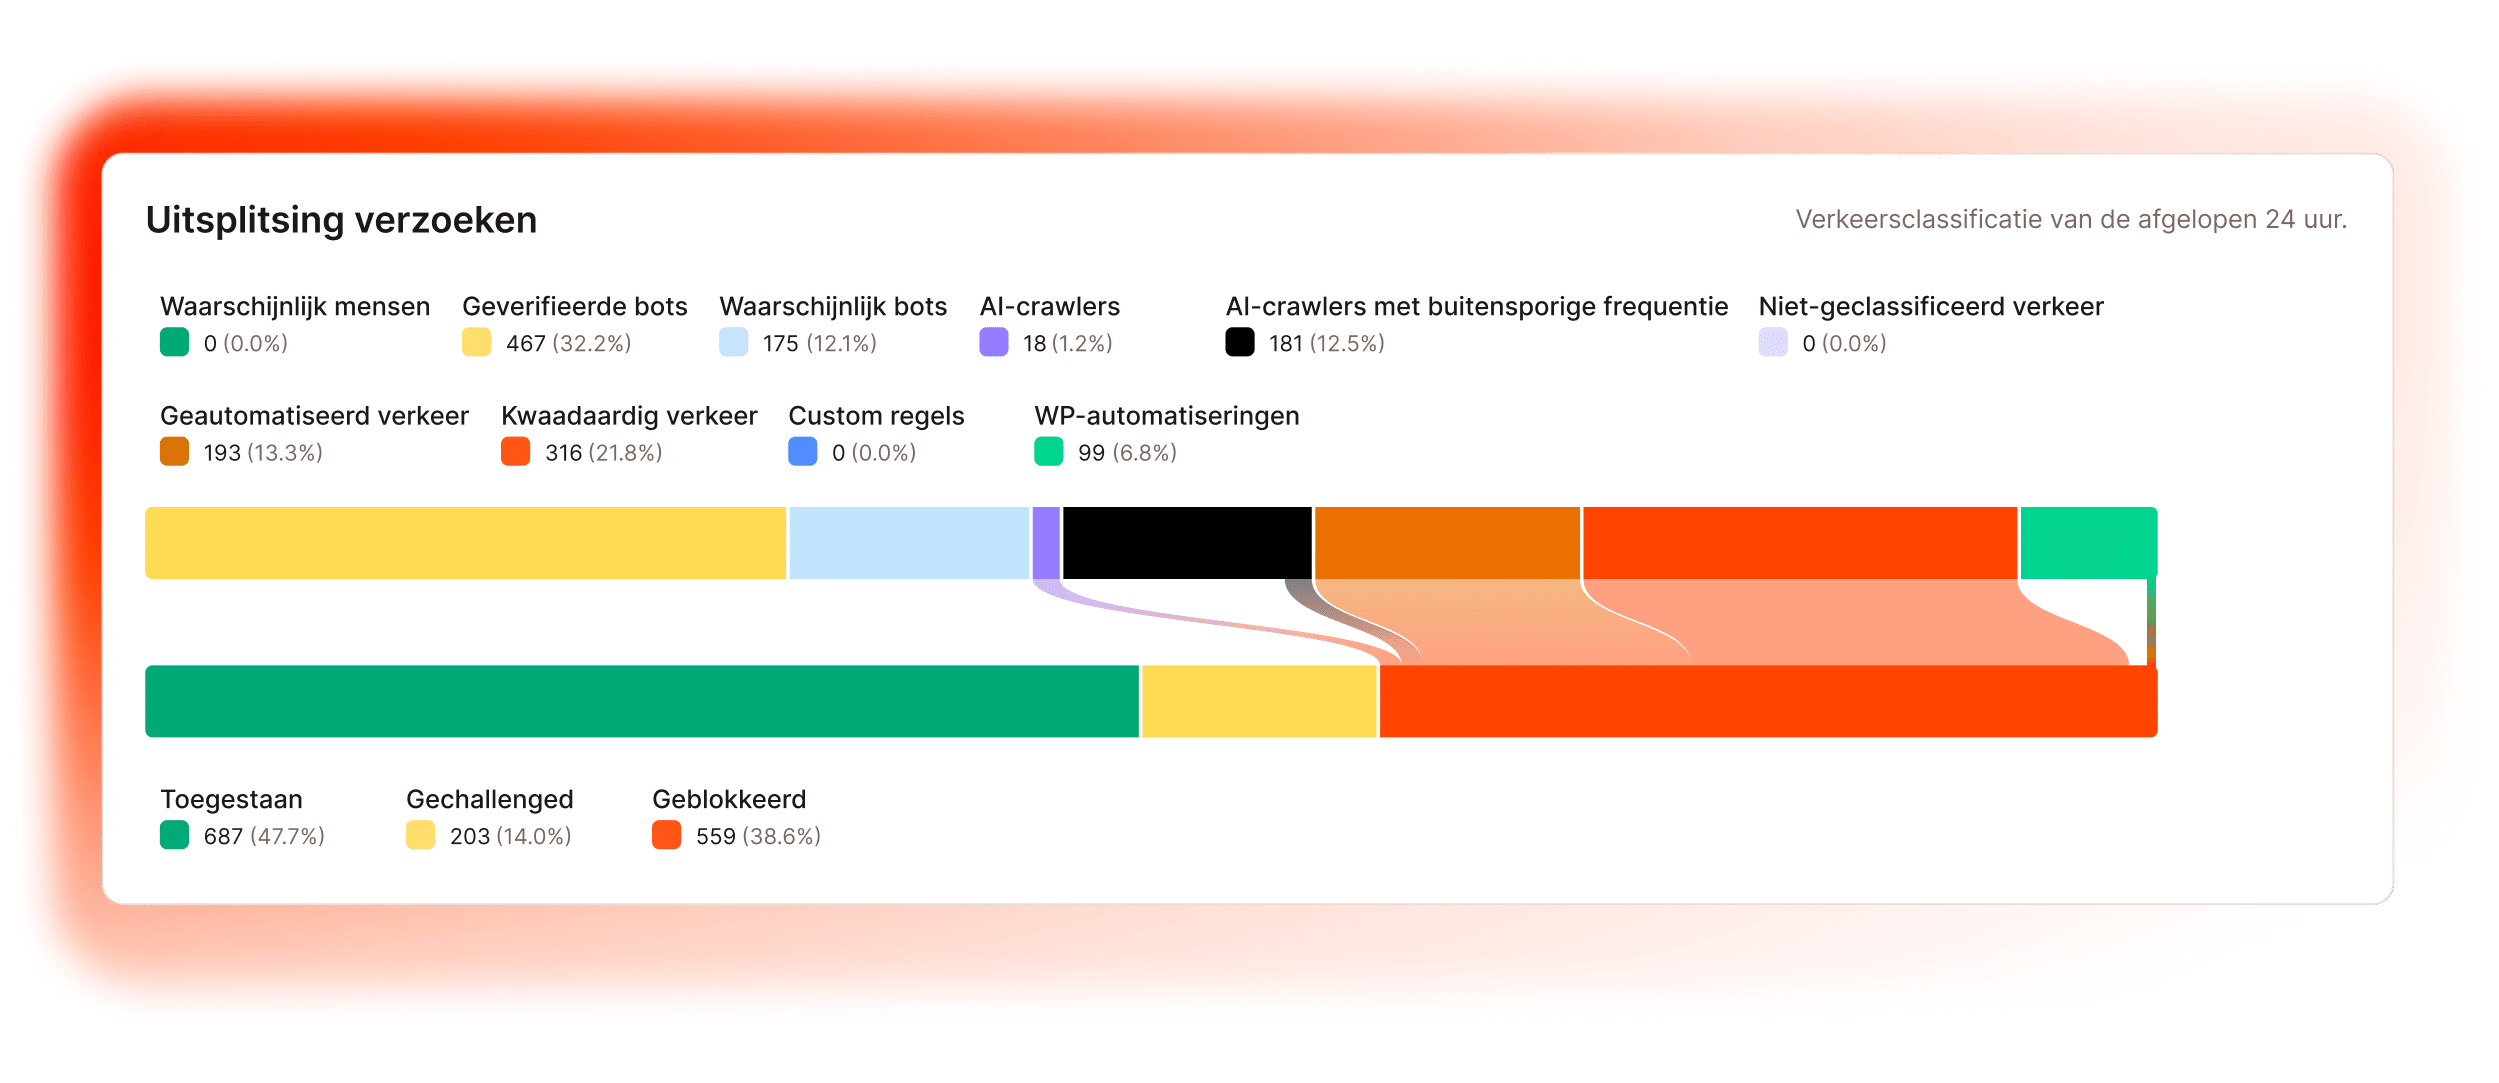
Bekijk hoe het botverkeer op je site eruitziet
Dit rapport is opgesteld door Kinsta.
Kinsta is een platform dat managed WordPress-hosting levert aan 230.000 klanten wereldwijd. Onze infrastructuur geeft ons een uniek inzicht in hoe websites worden bezocht en hoe elk verzoek wordt afgehandeld, en hoe de groei van geautomatiseerd verkeer dat verandert.