Als bevorzugte Quelle bei Google hinzufügen
Wenn du feststellst, dass ein großer Teil des Traffics auf deiner Website von Bots stammt, scheint es naheliegend, diese zu blockieren. In manchen Fällen erfordern die Zahlen tatsächlich eine sofortige Reaktion.
PatronView hat kürzlich dokumentiert, dass an einem einzigen Tag 3,6 Millionen Anfragen auf seiner Website eingingen, wobei der Traffic von mehr als 360.000 IP-Adressen stammte. Der Website-Betreiber hat schließlich eine Reihe recht aggressiver Cloudflare-Regeln eingerichtet, um den Traffic in den Griff zu bekommen.
Auch auf unserer eigenen Infrastruktur haben wir schon Extremfälle erlebt. In unserem Bericht zu KI- und Bot-Traffic generierte ein Crawler innerhalb von 24 Stunden 3,75 Millionen Anfragen an „In den Warenkorb“-URLs. Ein anderes sich wiederholendes Schleifenmuster verursachte Hunderte Millionen von Anfragen, bevor wir eine Regel einführten, um es abzufangen.
Diese Fälle sind echt, aber sie gelten nicht für jede Website.
In unserer jüngsten Analyse von mehr als 5.000 WordPress-Seiten machten KI-Bots bei der mittleren Website nur 1,57 % der Bandbreite aus, verglichen mit 17,8 % im 90. Perzentil und 90,3 % im 99. Perzentil, während mehr als 1.000 Websites überhaupt keine Bandbreitenbelastung durch KI-Bots verzeichneten.
Diese Streuung ist der Grund, warum das Aufspüren von KI-Bot-Traffic und die Diagnose eines KI-Bot-Problems zwei verschiedene Dinge sind.
Die Entscheidungen, die du als Nächstes triffst, können sich auf die Website-Performance, Integrationen, die Sichtbarkeit in Suchmaschinen und darauf auswirken, ob KI-Tools deine Inhalte anzeigen können. Bevor du irgendetwas änderst, musst du wissen, was die Bots tatsächlich tun.
Hier sind einige Fehler, die Website-Betreiber unserer Erfahrung nach machen, wenn sie diesen Schritt überspringen.
Fehler 1: Den Prozentsatz als Diagnose betrachten
Wenn KI-Crawler 20 % der Anfragen deiner Website ausmachen, sagt diese Zahl allein noch nichts darüber aus, ob ein Problem vorliegt.
Ein großer Anteil an Anfragen zu zwischengespeicherten Artikeln belastet die Anwendung möglicherweise nur relativ wenig, während eine geringere Anzahl, die wiederholt auf Suchergebnisse, gefilterte Produktseiten oder Warenkorb-URLs zugreift, weitaus mehr Arbeit verursachen kann.
Das ist ein Grund, warum netzwerkweite Bot-Statistiken mit Vorsicht zu betrachten sind, wenn man sie auf eine einzelne Website anwendet.
Unsere neuesten Untersuchungen ergaben, dass die durchschnittliche Anzahl der AI-Bot-Anfragen pro Website bei vier Messungen zwischen 667 und 928 pro Tag lag, verglichen mit einem Median von nur 33 bis 67 Anfragen, während etwa 20 % bis 27 % der Websites an einem Messtag keine AI-Bot-Anfragen erhielten.
Mit anderen Worten: Eine kleine Gruppe stark gecrawlter Websites treibt den Durchschnitt nach oben.
Wenn du also liest, dass Bots mehr als die Hälfte des Web-Traffics ausmachen, oder wenn ein anderer Website-Betreiber von 99 % Bot-Traffic berichtet, dann nutze diese Zahl nicht, um zu entscheiden, was deine eigene Website braucht.
Beginne mit deinem eigenen Traffic.
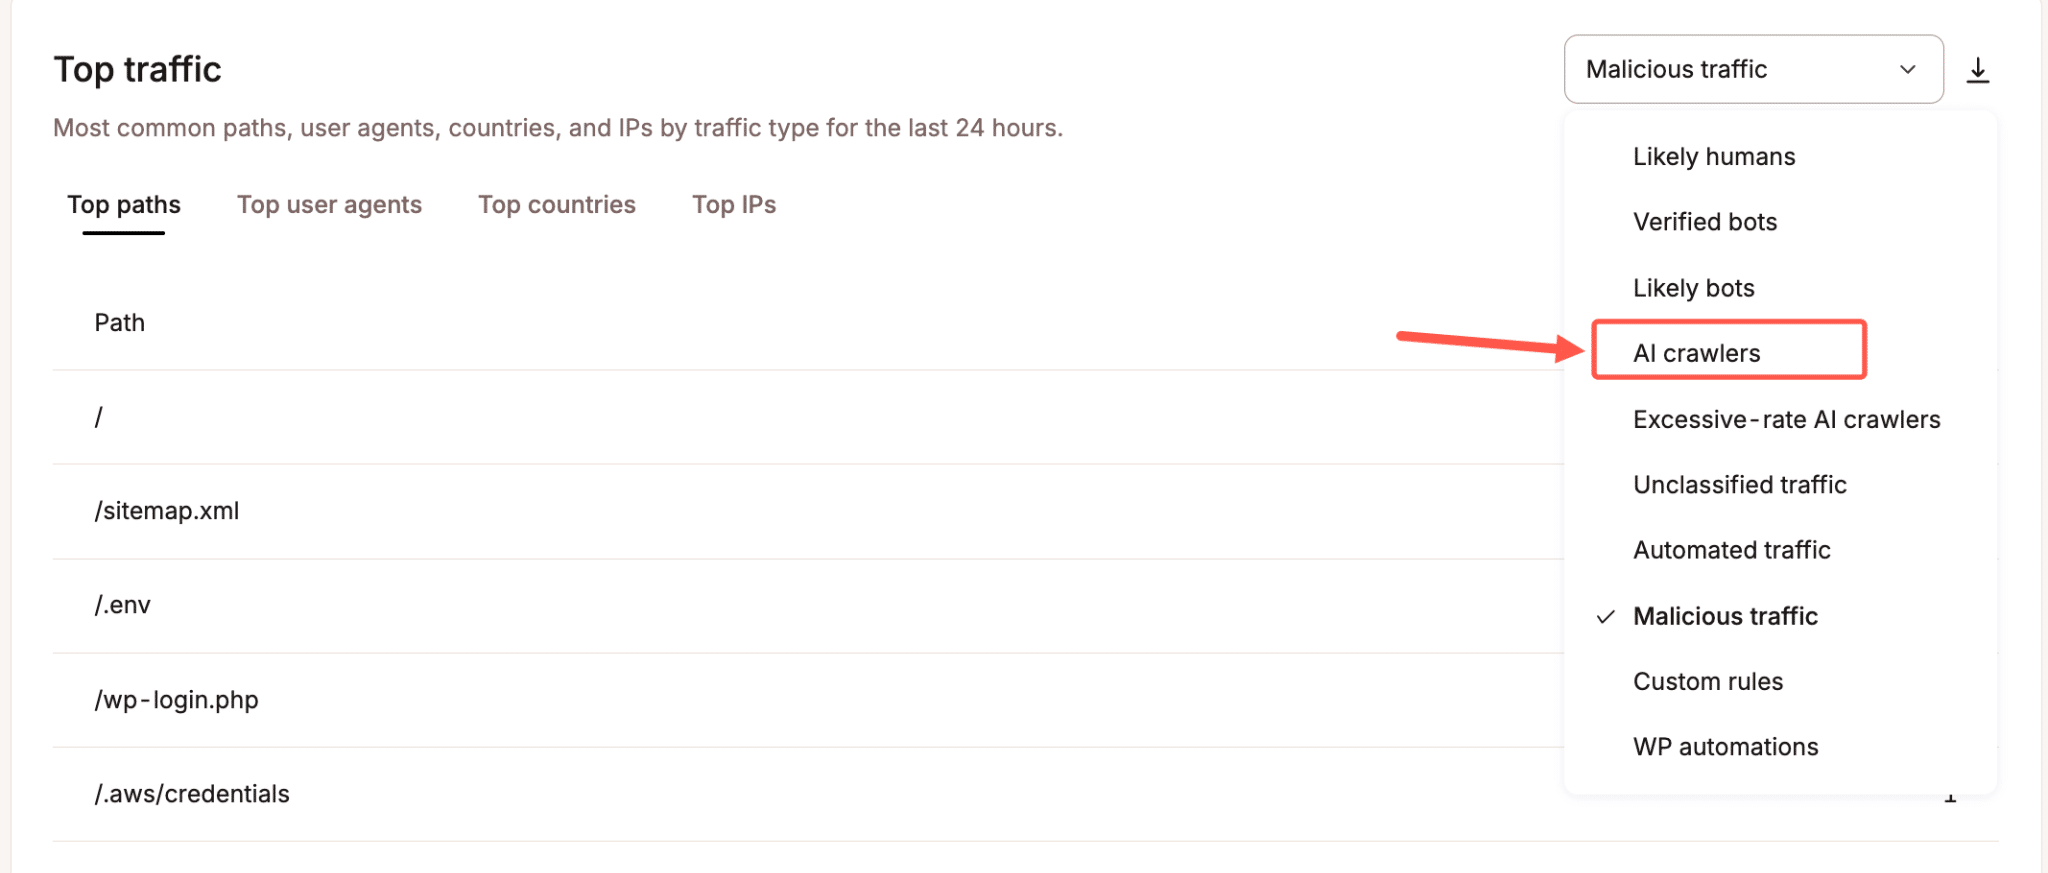
Für Kinsta-Kunden zeigt der Bereich „Bot-Schutz “ in MyKinsta, wie Anfragen klassifiziert werden, darunter „wahrscheinlich Menschen“, „verifizierte Bots“, „wahrscheinlich Bots“, „KI-Crawler“, „KI-Crawler mit übermäßiger Rate“, „automatisierter Traffic“ und „böswilliger Traffic“.
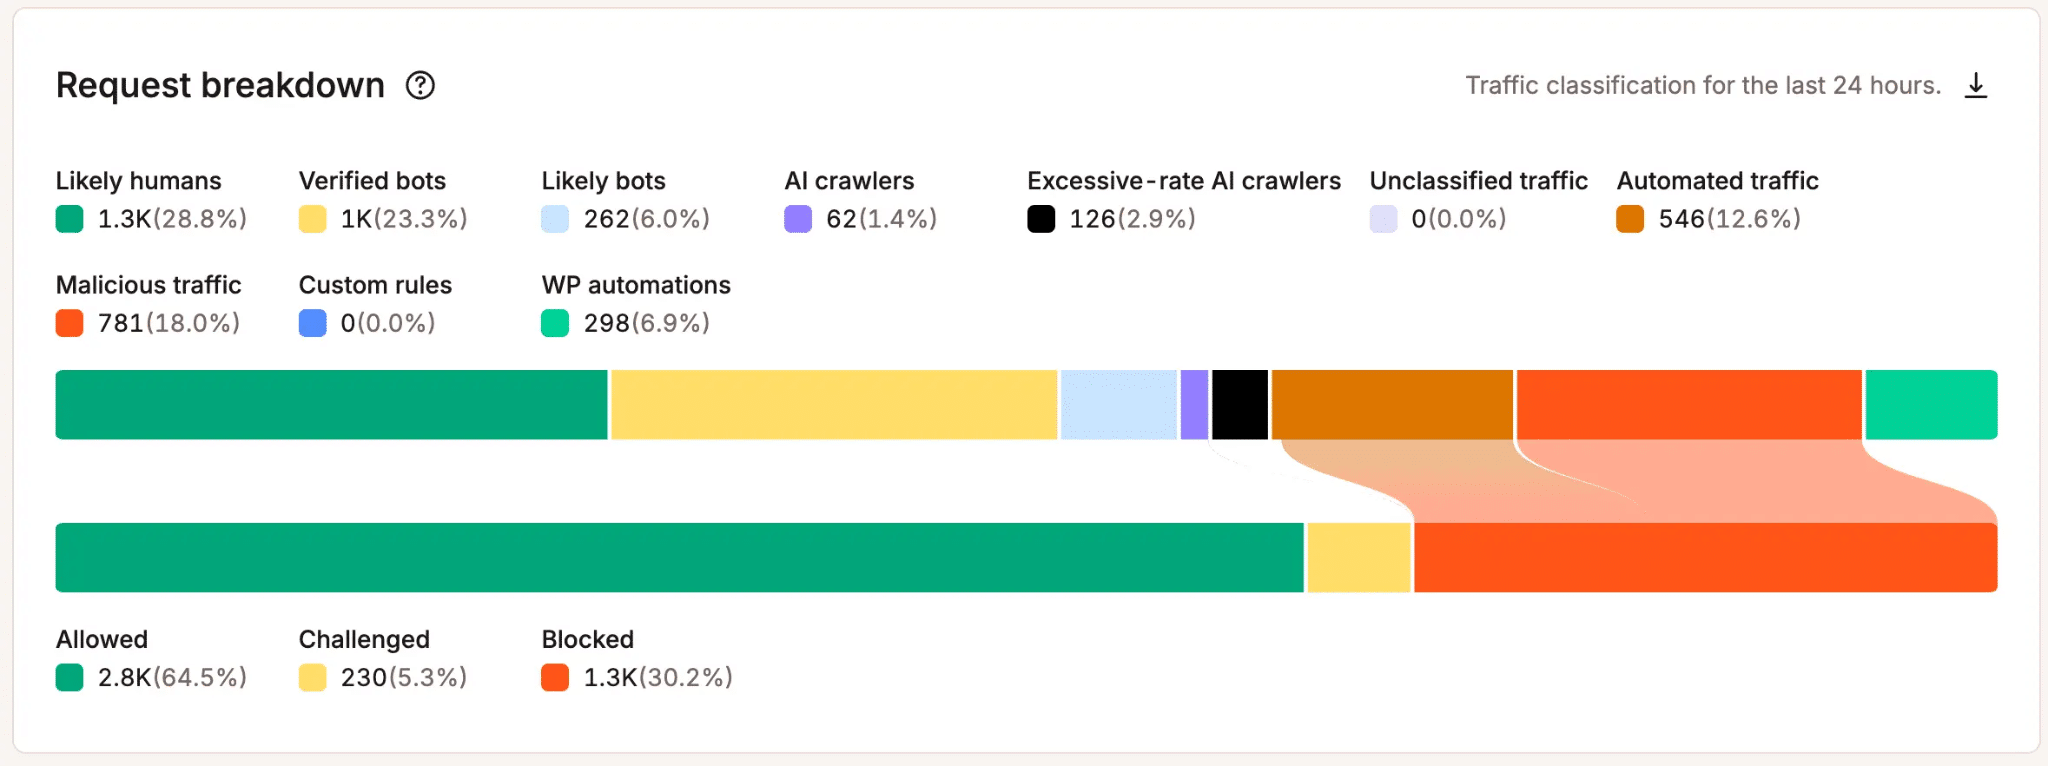
Über „Top-Traffic“ kannst du dann die Pfade, User-Agents, Länder und IP-Adressen hinter einem bestimmten Traffic-Typ einsehen.
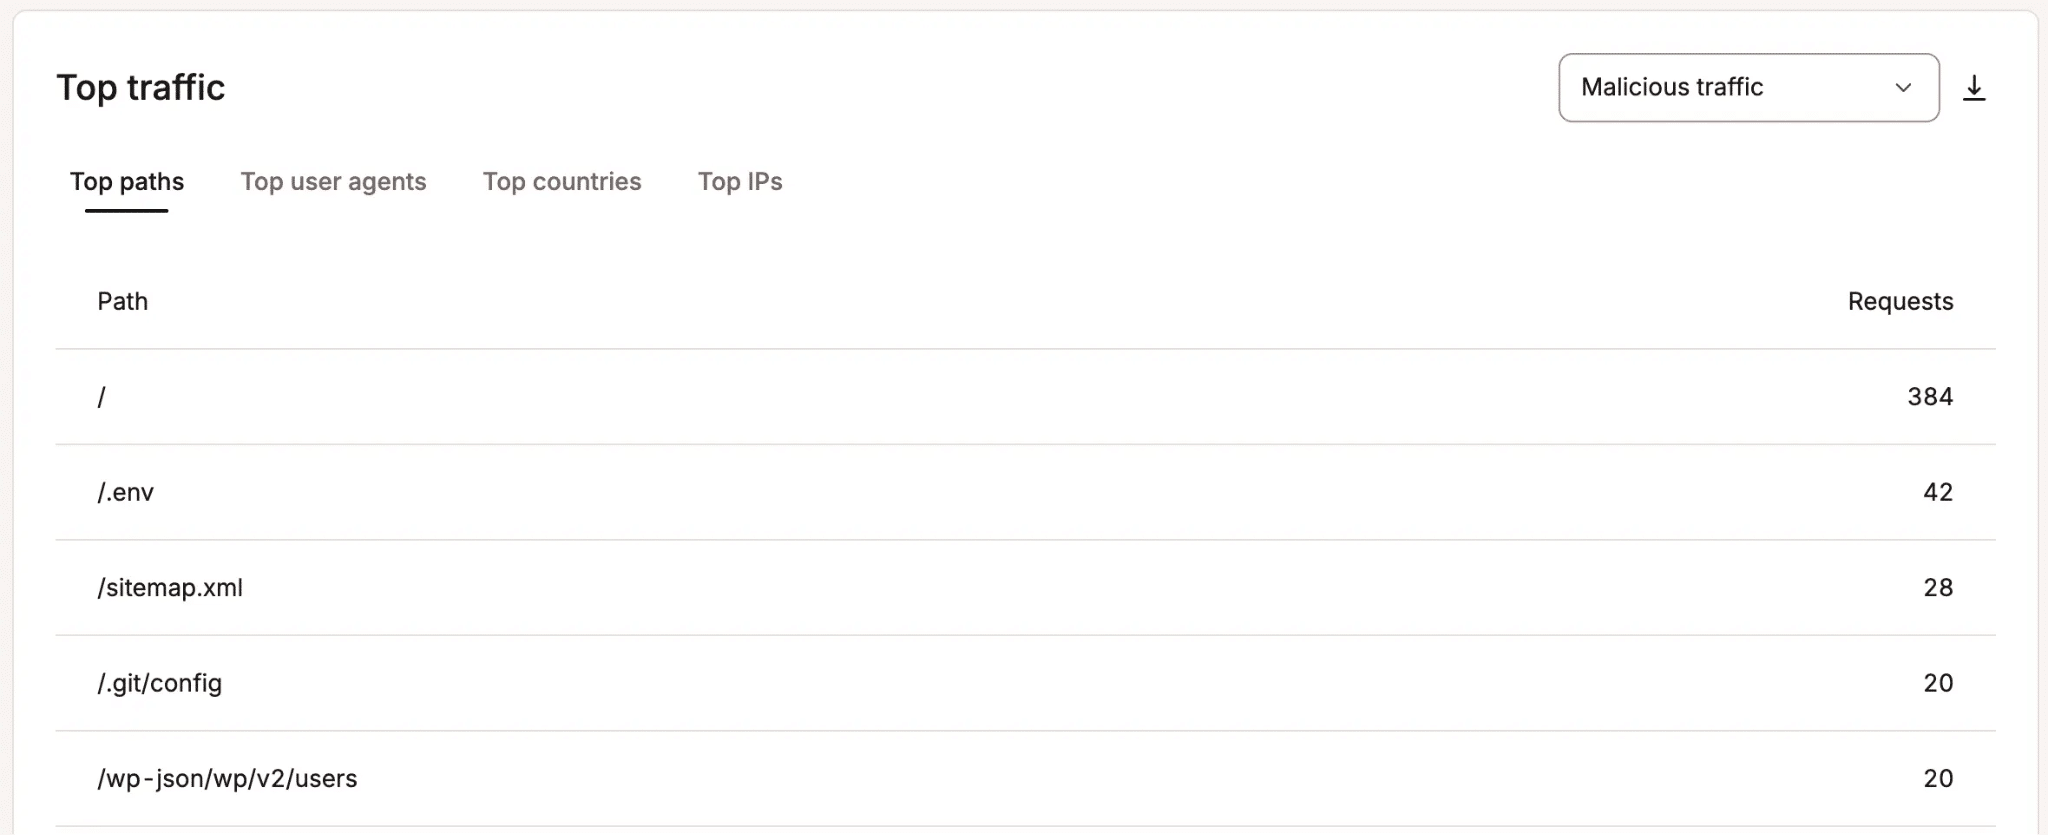
Bevor du Maßnahmen ergreifst, solltest du einige grundlegende Fragen beantworten können:
- Wie viel KI-Traffic erreicht die Website tatsächlich?
- Welche Seiten oder Endpunkte werden angefragt?
- Welche Crawler, Agenten oder andere automatisierte Systeme sind dafür verantwortlich?
- Beeinflusst dieser Traffic die Leistung, die Bandbreite, die PHP-Threads oder das Erlebnis echter Besucher?
Unser aktueller Bericht betrachtet dies unter dem Gesichtspunkt der Position, des Musters und des Profils des Datenverkehrs. Eine Website, die nur sehr wenig KI-Datenverkehr mit normalem Anfrageverhalten erhält, erfordert möglicherweise keine Maßnahmen, während eine Website mit anhaltendem Crawler-Datenverkehr auf teure dynamische URLs eine viel genauere Untersuchung verdient.
Fehler 2: Jeden Bot blockieren, nur weil der Traffic automatisiert ist
Der Begriff „KI-Bot“ umfasst mittlerweile verschiedene Arten von Datenverkehr. Manche Crawler sammeln öffentliche Inhalte für das Modelltraining oder die KI-Suche, während andere Seiten als Antwort auf eine Nutzeranfrage abrufen.
Diese Unterschiede spielen eine Rolle, wenn du entscheidest, was du zulassen willst. OpenAI nutzt beispielsweise den GPTBot für Inhalte, die zur Verbesserung seiner Modelle verwendet werden können, während der OAI-SearchBot dazu beiträgt, Websites in der ChatGPT-Suche auffindbar zu machen. Das Blockieren des OAI-SearchBots kann daher beeinflussen, ob deine Inhalte in den ChatGPT-Suchergebnissen erscheinen.
Anthropic macht eine ähnliche Unterscheidung. ClaudeBot sammelt Webinhalte, die zum Modelltraining beitragen können, Claude-SearchBot wird für die Suche verwendet und Claude-User kann eine Website abrufen, wenn jemand, der Claude nutzt, danach fragt.
Perplexity berichtet, dass PerplexityBot für den Suchindex verwendet wird und Perplexity-User für Anfragen, die als Antwort auf die Frage eines Nutzers gestellt werden.
Google bietet Publishern eine separate „Google-Extended“-Einstellung, mit der sie steuern können, wie gecrawlte Inhalte mit Gemini verwendet werden dürfen. Google betont ausdrücklich, dass eine Änderung dieser Einstellung keinen Einfluss auf die Aufnahme oder das Ranking in der Google-Suche hat.
Wenn du all diese Systeme in einen einzigen „KI“-Topf wirfst, verschenkst du Informationen, die du nutzen könntest.
Wenn du lieber keine Ressourcen deiner Website für das Modelltraining aufwenden möchtest, kannst du die Crawler für das Training einschränken, während du Such- und Abrufsysteme weiterhin zugänglich lässt. Wenn dein Problem darin besteht, dass ein KI-Agent wiederholt auf einen dynamischen Endpunkt zugreift, löst eine Änderung deiner Richtlinie für Trainings-Crawler das Problem möglicherweise nicht.
Hier geht es auch um eine geschäftliche Frage. Unsere Verbraucherumfrage ergab, dass 44,7 % der Befragten angaben, sie besuchten die Website eines Unternehmens immer oder meistens, nachdem sie eine KI-Empfehlung erhalten hatten. Das bedeutet nicht, dass der Zugriff von KI-Crawlern automatisch Referral-Traffic erzeugt, aber es bedeutet, dass es sich lohnt, die Entdeckung durch KI zu berücksichtigen, bevor du eine pauschale Entscheidung über die Sichtbarkeit triffst.
Bei Kinsta ermöglicht die Einstellung „KI-Crawler blockieren“ Kunden, KI-Crawler – einschließlich verifizierter – zu blockieren, ohne dabei traditionelle Suchmaschinen-Crawler wie Googlebot und Bing zu blockieren.
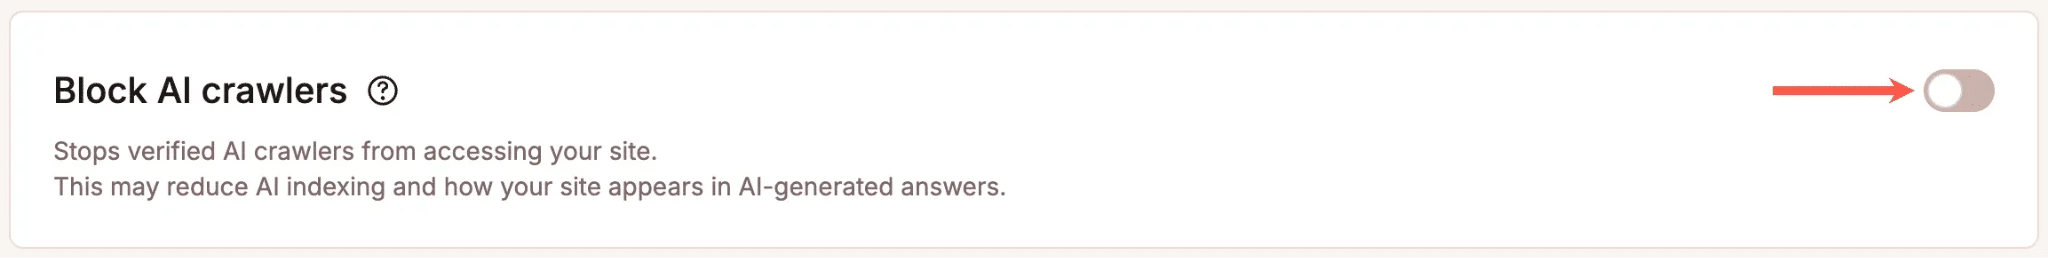
Wir weisen Kunden außerdem darauf hin, dass das Blockieren von KI-Crawlern die Sichtbarkeit in KI-gestützten Suchergebnissen, Zusammenfassungen oder Empfehlungen verringern kann.
Fehler 3: Jeden Anstieg bei KI-Crawlern als Sicherheitsnotfall behandeln
Bots können durch Brute-Force-Versuche, DDoS-Angriffe, Angriffe auf Anmeldedaten und andere missbräuchliche Automatisierungen Sicherheitsprobleme verursachen, aber ein verifizierter KI-Crawler, der zu viele legitime Anfragen sendet, ist ein ganz anderes Problem.
Während unseres Live-Events zum Thema Bot-Traffic erklärte Daniel Pataki, CTO von Kinsta, warum er sich Sorgen darüber macht, wie Website-Betreiber reagieren, wenn diese beiden Dinge miteinander vermischt werden:
„Ich fürchte in diesem Fall eine Überreaktion mehr als eine Unterreaktion, denn es handelt sich nicht um ein Sicherheitsproblem.“
Er sprach dabei über das allgemeinere Problem mit KI-Crawlern, bei dem ein Großteil des störenden Traffics, den wir beobachten, von legitimen Systemen stammt, die ineffizient crawlen, und nicht von einem Angreifer, der versucht, die Website zu kompromittieren.
Die Reaktion ändert sich, wenn die Website bereits beeinträchtigt ist. Wenn Bots Serverressourcen binden, Seiten verlangsamen oder echte Kunden daran hindern, die Website zu nutzen, hat die Stabilisierung der Website oberste Priorität. Daniel empfahl, den Bot-Traffic vorübergehend zu blockieren, wenn er ein akutes Problem verursacht, und erst dann Nachforschungen anzustellen, sobald die Website wieder unter Kontrolle ist.
Der Fehler besteht darin, diese Notfallmaßnahme zu einer dauerhaften Richtlinie zu machen, ohne herauszufinden, was eigentlich passiert ist.
Der Bot-Schutz von Kinsta bietet dir mehrere Kontrollstufen, vom Basisschutz gegen böswilligen Datenverkehr bis hin zum Blockieren von Automatisierungen oder zum Überprüfen verdächtiger Bots, wenn strengere Schutzmaßnahmen erforderlich sind. Auch KI-Crawler mit übermäßiger Zugriffsrate können auf den entsprechenden Schutzstufen abgefragt werden.
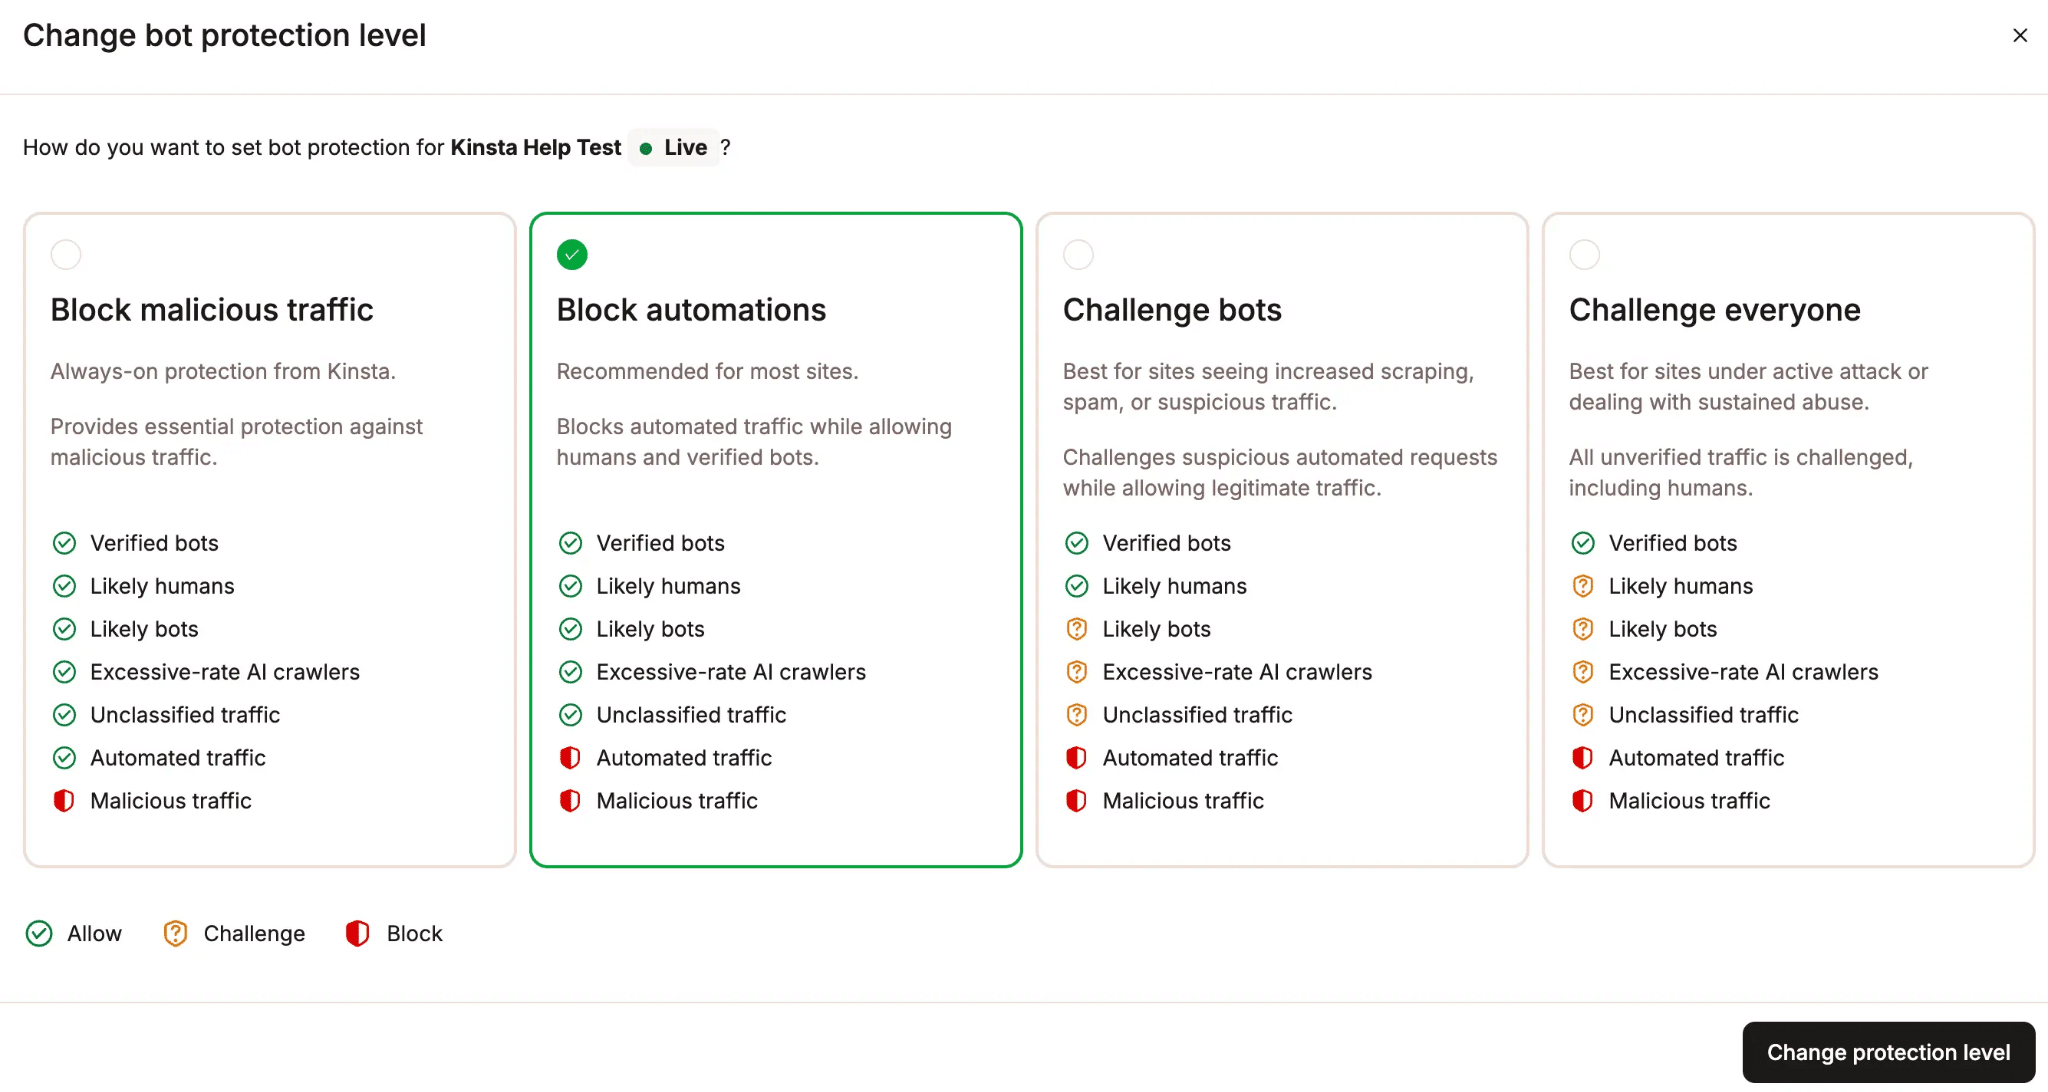
Ein plötzlicher Leistungsausfall kann heute strengere Kontrollen rechtfertigen. Sobald der Vorfall vorbei ist, überprüfe, was die Website belastet hat und ob diese strengeren Kontrollen noch sinnvoll sind.
Fehler 4: Das Anfragevolumen im Blick behalten, ohne zu beachten, wohin die Anfragen gehen
Unsere Infrastrukturdaten machen diesen Unterschied deutlich. Eine Anfrage für einen zwischengespeicherten Blogbeitrag und eine für eine nicht zwischengespeicherte WooCommerce-Suchseite zählen beide als eine einzige Anfrage, auch wenn die zweite weitaus mehr Serverleistung erfordern kann.
Hier ist eine Illustration aus dem Live-Event „Bot Traffic Reality Check“:
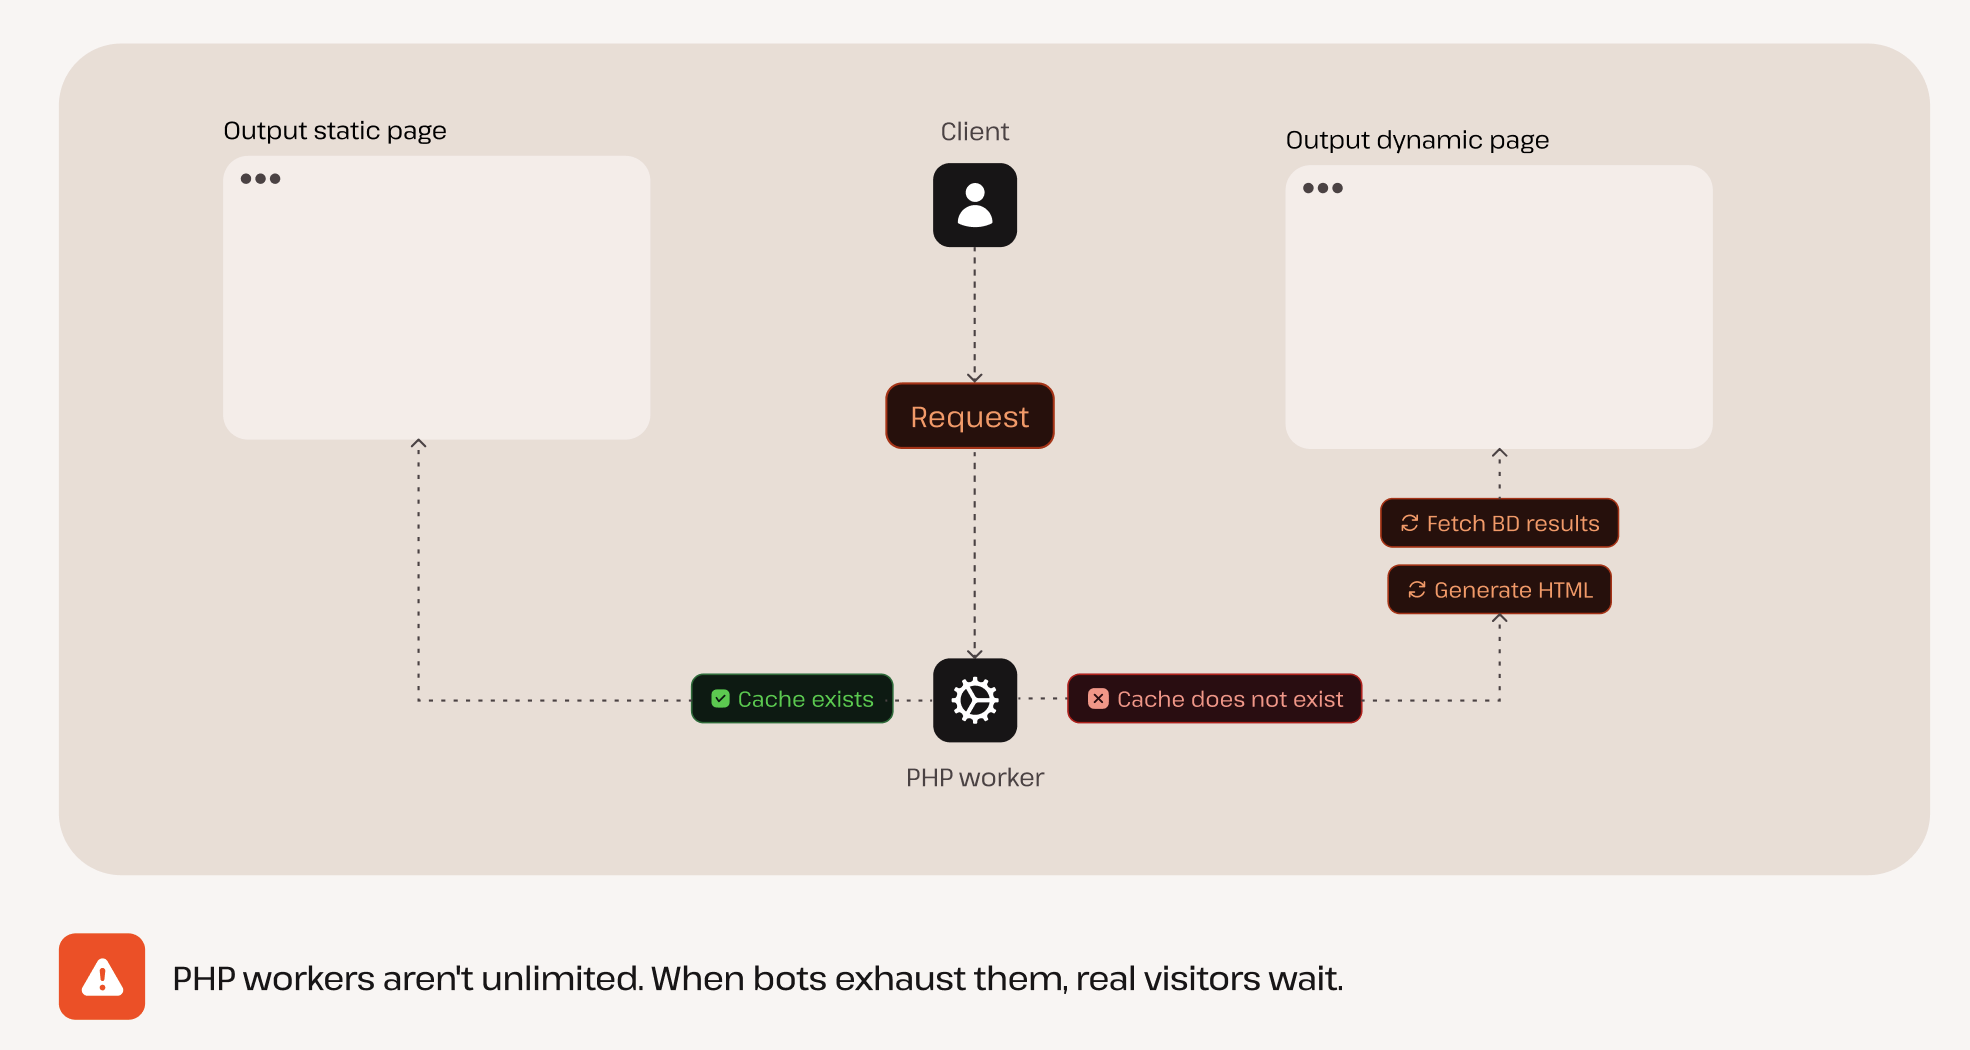
Wenn eine zwischengespeicherte Seite verfügbar ist, kann WordPress einen Großteil der Anfrage bearbeiten, ohne die Seite neu zu generieren.
Eine dynamische Anfrage erfordert möglicherweise einen PHP-Thread (auch als „Worker“ bezeichnet), Datenbankabfragen, die Seitengenerierung und manchmal auch die Verwaltung von Sessions, bevor WordPress überhaupt etwas zurückgeben kann. Aktivitäten im Warenkorb und an der Kasse können zusätzlichen Aufwand verursachen.
Wiederhole diesen Vorgang nun tausende Male.
Bei drei Messungen in unserer aktuellen Studie betrafen zwischen 76,9 % und 90,5 % der Anfragen von KI-Crawlern dynamische Inhalte. Der menschliche Traffic lag zwischen 18,3 % und 18,9 %.
Dieser Unterschied sagt viel mehr über die potenzielle Belastung der Infrastruktur aus als die reine Anzahl der Anfragen.
Denk mal an den Vorfall mit dem „In den Warenkorb“-Vorgang, den wir bei unserer Untersuchung zum KI-Bot-Traffic entdeckt haben. Ein Crawler generierte innerhalb von 24 Stunden 3,75 Millionen Anfragen – das entspricht etwa einer Anfrage alle 23 Millisekunden. Jede dieser Anfragen konnte WordPress dazu bringen, Arbeit für einen „Besucher“ zu verrichten, der niemals etwas kaufen würde.
Das ist auch der Grund, warum sich zwei Seiten mit demselben Prozentsatz an KI-Traffic sehr unterschiedlich verhalten können.
Eine Content-Website, auf der Crawler hauptsächlich zwischengespeicherte Artikel abrufen, kann ein großes Volumen ohne große Probleme bewältigen, während ein WooCommerce-Shop die Auswirkungen viel früher spürt, wenn schon eine geringere Anzahl von Anfragen wiederholt Suchfunktionen, Filter, Warenkorb-Aktionen, Kontoseiten oder andere nicht zwischengespeicherte Routen belastet.
Sobald du einen Spitzenwert entdeckst, schau über den User-Agent hinaus.
In MyKinsta kannst du den Top-Traffic nach KI-Crawlern filtern und die Pfade überprüfen, die sie am häufigsten abfragen.
Vergleiche das dann mit Cache-Informationen, Serverbandbreite und Leistungsdaten, um zu sehen, ob diese Anfragen die Anwendung erreichen und Arbeitsaufwand verursachen.
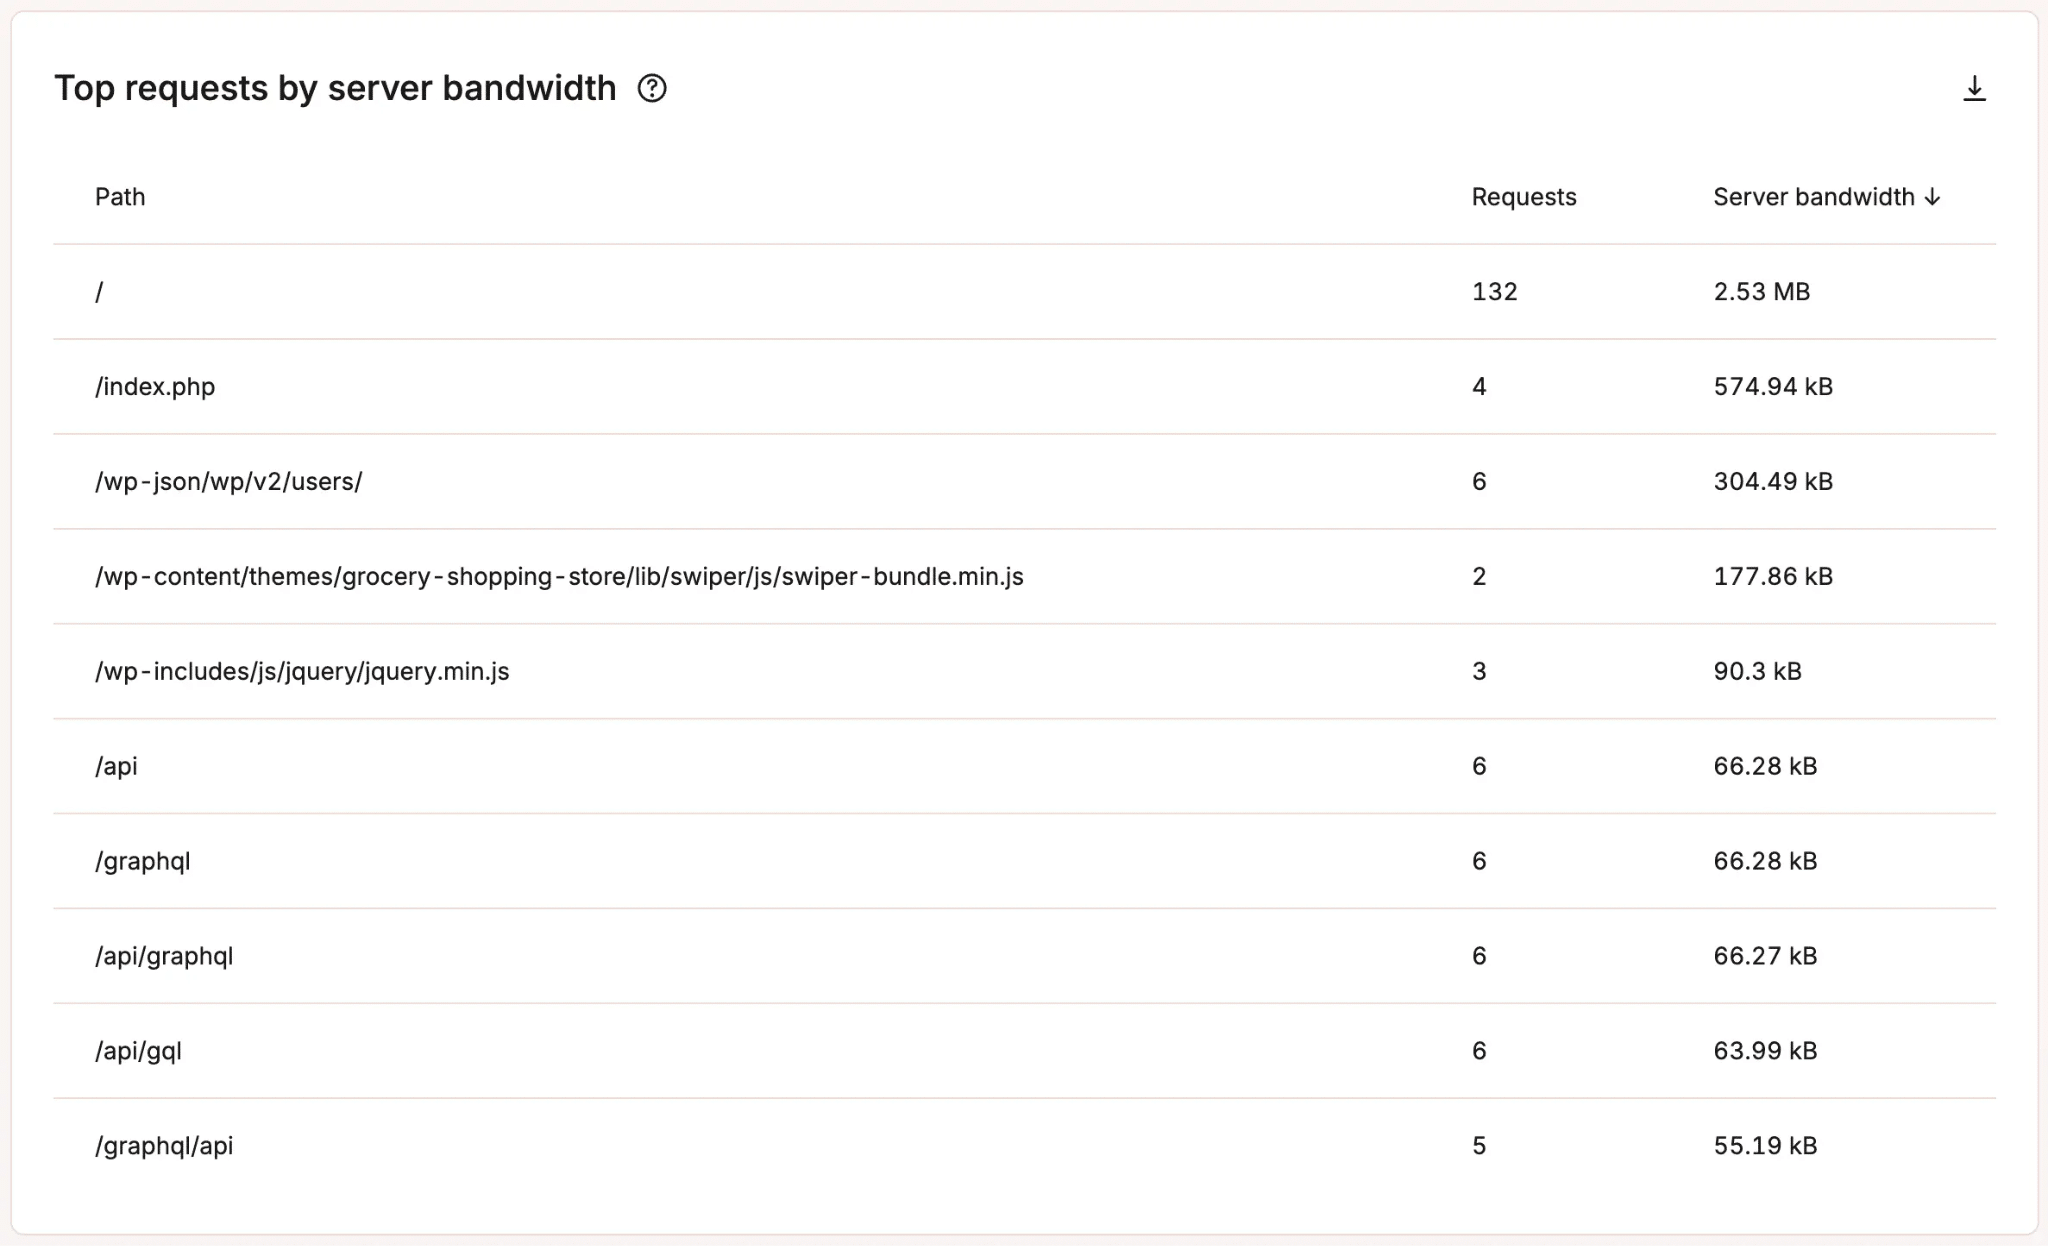
Es ist hilfreich, wenn „GPTBot“ oder ein anderer Crawler ganz oben in einem Bericht steht. Wenn du siehst, dass Tausende seiner Anfragen an /blog/ gehen, sagt dir das das eine. Wenn sie zu Suchergebnissen oder einer parametrisierten WooCommerce-URL führen, sagt dir das etwas anderes.
Fehler 5: Den Crawler blockieren und die Crawl-Falle zurücklassen
Manchmal ist der Bot nur das, was ein Problem aufdeckt, das bereits in deiner URL-Struktur steckt.
WordPress-Seiten können eine Menge URLs generieren – durch Abfrageparameter, Suchseiten, gefilterte Archive, Paginierung, Kalender, Produktvarianten und E-Commerce-Aktionen.
Ein Mensch erkennt vielleicht, dass zwei leicht unterschiedliche URLs im Grunde zur selben Seite führen, während ein Crawler einfach nur weitere Links sieht, denen er folgen kann.
Wenn jede Seite einen weiteren Satz von URLs erzeugt, die neu erscheinen, kann der Crawler ihnen immer weiter folgen. So entstehen Muster, die viel aggressiver wirken, als es irgendjemand beabsichtigt hat.
Das haben wir in unserer früheren Infrastruktur-Untersuchung festgestellt. Ein sich wiederholendes Muster wurde so umfangreich, dass eine einzige Regel, die darauf ausgelegt war, es abzufangen, innerhalb von 30 Tagen 550 Millionen Anfragen filterte.
Das Blockieren des Crawlers mag die unmittelbare Last stoppen, beseitigt aber nicht das URL-Muster, das den Crawler dazu veranlasst hat, neue Seiten zu finden.
Wenn ein bestimmter Pfad plötzlich den Traffic von KI-Crawlern dominiert, überprüfe den Pfad selbst:
- Erzeugt WordPress eine große Anzahl von Parameterkombinationen?
- Kann sich ein Crawler unbegrenzt durch Kalender- oder Paginierungs-URLs bewegen?
- Zeigen Such- und Filter-Seiten Tausende von URL-Varianten an?
- Sind Aktions-URLs wie „In den Warenkorb“-Links crawlbar, obwohl sie es nicht sein müssen?
- Muss jede generierte URL wirklich existieren und auffindbar sein?
Vielleicht entscheidest du dich trotzdem, den Crawler zu blockieren oder herauszufordern, aber verstehe erst einmal, warum er immer wieder zurückgekommen ist.
Das ist besonders wichtig für Agenturen. Wenn mehrere Kunden-Websites dasselbe Plugin, dieselbe WooCommerce-Konfiguration, dasselbe Theme oder dasselbe URL-Muster verwenden, kann ein aggressiver Crawler dasselbe Problem auf mehr als einer Website aufdecken. Das Verhalten zu beheben kann sinnvoller sein, als eine ständig wachsende Liste von Bot-Namen zu pflegen.
Fehler 6: Annehmen, dass robots.txt den Traffic gestoppt hat
Eine Änderung in der `robots.txt`-Datei kann die richtige Maßnahme sein, wenn du einem seriösen Crawler mitteilen willst, dass er nicht auf Teile oder die gesamte Website zugreifen soll – aber du musst den Traffic danach trotzdem noch überprüfen.
robots.txt setzt darauf, dass der Crawler die Anweisung befolgt, und verhindert nicht physisch, dass die Anfrage deine Website erreicht.
Wir haben diesen Unterschied in unserem Leitfaden zu KI-Crawlern ausführlich behandelt. robots.txt teilt Crawling-Präferenzen mit, während llms.txt einen strukturierten Inhaltsindex für Tools bereitstellt, die diesen lesen möchten. Die Durchsetzung erfolgt an anderer Stelle.
Das ist wichtig, wenn du ein Leistungsproblem entdeckt hast, denn allein durch das Bearbeiten einer Datei könnte der Eindruck entstehen, das Problem sei bereits behoben.
Überprüfe deine Logs oder Bot-Analysen. Wenn die Anfragen des Crawlers nach deiner Änderung an robots.txt zurückgehen, hast du den Beweis, dass es funktioniert hat. Wenn der Traffic anhält oder du es mit einem anderen automatisierten System zu tun hast, das die Anweisung nicht befolgt, brauchst du eine Durchsetzungsmaßnahme.
Das Gleiche gilt, wenn dein Problem eher in der Anfragefrequenz als im Zugriff selbst liegt. Ein Crawler darf zwar deine Inhalte lesen, fordert sie aber möglicherweise in einer Frequenz an, die deine Website nicht problemlos bewältigen kann.
Fehler 7: Die Firewall-Regeln einer anderen Website kopieren, ohne zu prüfen, was dadurch blockiert würde
Das Beispiel von PatronView ist nützlich, weil die Reaktion der Seite auf ihren eigenen Daten basierte.
Da sich ihr Publikum überwiegend in Nordamerika befindet, blockiert der Betreiber Datenverkehr aus anderen Kontinenten. Er hat seine tatsächlichen Besucherdaten überprüft, bevor er Nutzer mit veralteten Browserversionen herausgefordert hat. Außerdem überwacht er, wie viele der herausgeforderten Besucher die Herausforderung tatsächlich bestehen. In einem Zeitraum wurden nur 0,24 % von mehr als 100.000 Herausforderungen gelöst.
Diese Zahlen machen die Regeln für diese Website leichter zu rechtfertigen, aber die Anwendung derselben Konfiguration auf einen internationalen E-Commerce-Shop könnte dazu führen, dass legitime Kunden herausgefordert werden. Das gleiche Risiko entsteht, wenn Teams mehrere Sicherheitstools übereinander stapeln, weil jedes für sich genommen nützlich erscheint.
Eine WordPress-Seite könnte über Bot-Schutz auf Hosting-Ebene, Cloudflare-Regeln, ein Sicherheits-Plugin, Ratenbegrenzung, Ländersperren und benutzerdefinierte WAF-Regeln verfügen, die alle Entscheidungen über dieselbe Anfrage treffen. Das Debuggen eines Fehlalarms wird viel schwieriger, wenn du nicht weißt, welche Ebene die Entscheidung getroffen hat.
Kinsta-Kunden raten wir ausdrücklich davon ab, den Kinsta-Bot-Schutz mit zusätzlichen benutzerdefinierten Bot-Schutzebenen zu kombinieren. Widersprüchliche Klassifizierungen können dazu führen, dass legitime Besucher oder Integrationen blockiert werden.
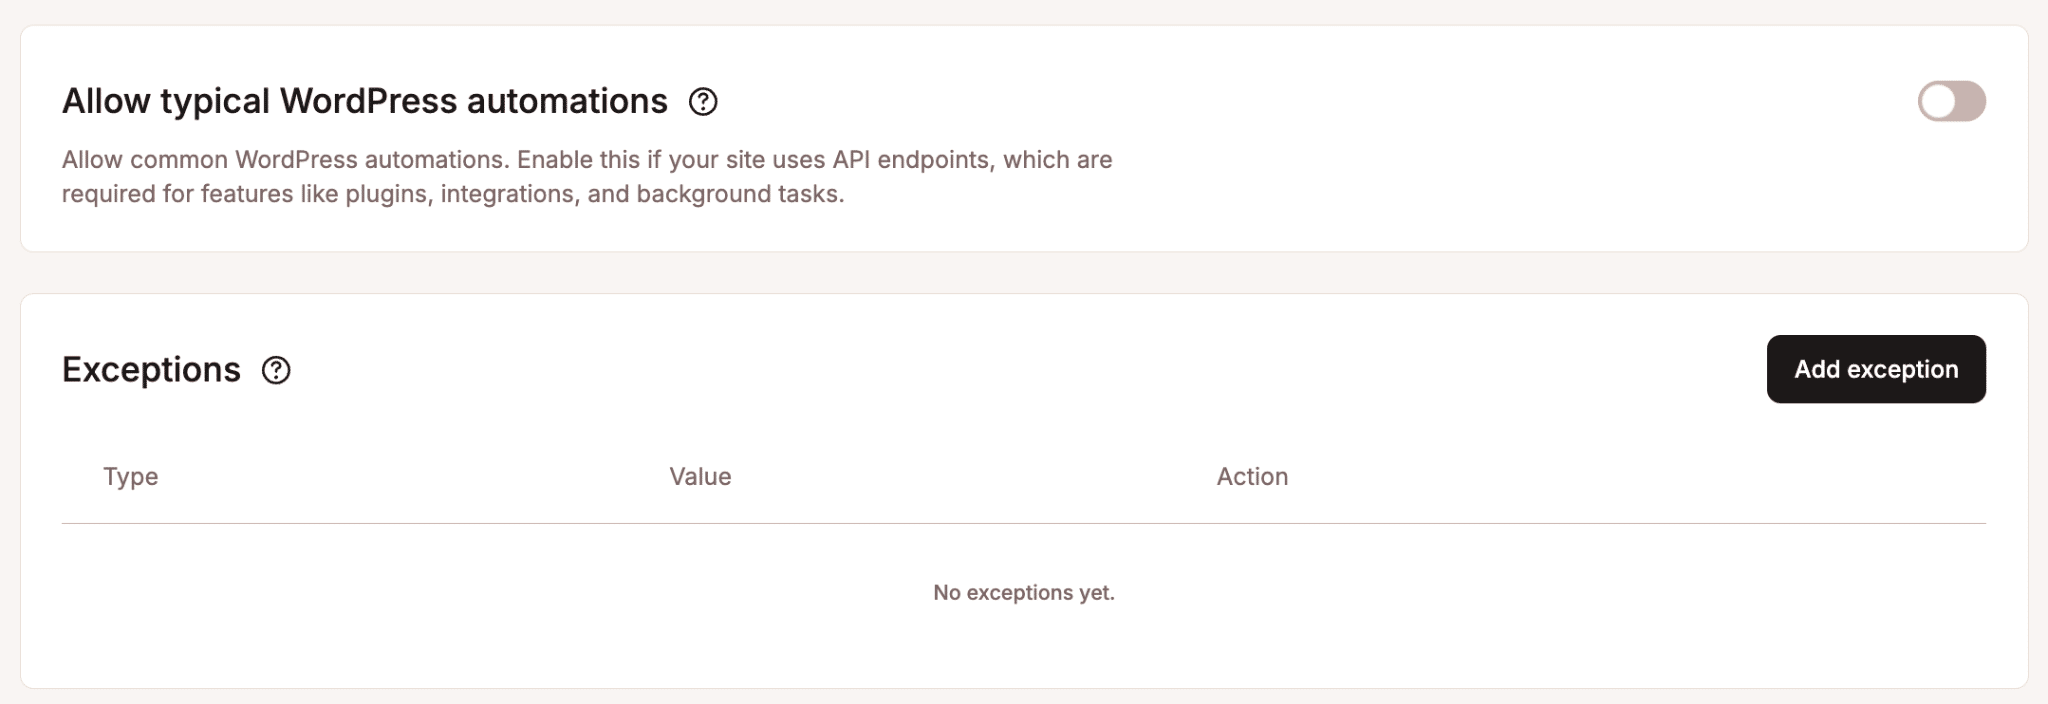
Höhere Schutzstufen können auch legitime Automatisierungen wie APIs, Überwachungstools, Webhooks und WordPress-Integrationen beeinträchtigen. MyKinsta enthält daher die Option „Typische WordPress-Automatisierungen zulassen“ sowie Ausnahmen, die vertrauenswürdige IP-Adressen, Pfade und User-Agents stets zulassen.
Wenn du eine Agentur betreibst, ist ein Standardprozess nützlicher als ein Standardregelsatz. Du kannst denselben Prozess auf 20 Kunden-Websites anwenden, indem du den Traffic identifizierst, seine Pfade überprüfst, die Leistung kontrollierst, eine Kontrollmaßnahme auswählst, diese testest und das Ergebnis überwachst.
Was tun, wenn du AI-Bot-Traffic entdeckst
Schau dir zunächst an, was auf deiner Website passiert. Wenn Bot-Traffic echte Besucher beeinträchtigt, schütze zuerst die Website und überprüfe dann, wie viel Traffic du erhältst, welche Pfade er erreicht und welche Systeme dafür verantwortlich sind.
Wähle dann die kleinste Änderung, die das Problem löst. Das kann bedeuten, die „robots.txt“ zu aktualisieren, einen Crawler zu blockieren oder zu überprüfen, ein crawlbares URL-Muster zu korrigieren – oder gar nichts zu tun, wenn der Datenverkehr keinen Schaden anrichtet.
Kinsta-Kunden können einen Großteil dieser Untersuchungen direkt in MyKinsta durchführen. Die Bot-Traffic-Analyse unterscheidet zwischen KI-Crawlern, KI-Crawlern mit übermäßiger Zugriffsrate, verifizierten Bots, automatisiertem Traffic und anderen Anfragetypen, während „Top-Traffic“ die Pfade, User-Agents, Länder und IP-Adressen dahinter anzeigt.
Du kannst diese Aktivitäten auch mit dem Cache-Verhalten, der Serverbandbreite und der PHP-Leistung vergleichen, um festzustellen, ob der Traffic deine Website tatsächlich belastet, bevor du entscheidest, was du blockieren möchtest.
Joel ist Frontend-Entwickler und arbeitet bei Kinsta als Technical Editor. Er ist ein leidenschaftlicher Lehrer mit einer Vorliebe für Open Source und hat über 200 technische Artikel geschrieben, die sich hauptsächlich um JavaScript und seine Frameworks drehen.