Añádelo como fuente preferida en Google
La automatización cada vez se encarga de más tareas de WordPress que antes necesitaban que alguien estuviera delante del teclado.
Ahora, los despliegues, las actualizaciones, las respuestas de seguridad y los cambios en la infraestructura se pueden llevar a cabo sin que nadie tenga que estar pendiente de cada paso. Sin embargo, lo que aún no está claro es saber cuáles de esos pasos siguen necesitando que un humano supervise el proceso.
Hay cuatro categorías de operaciones en WordPress en las que debes centrarte, pero gracias a las funciones y a la infraestructura de Kinsta, tu servidor ya está diseñado en torno a ellas.
Un agente que no sabe cuándo parar supone un riesgo para la automatización
Al ser una máquina, un agente de IA siempre intentará cumplir tus deseos. Por ejemplo, puede llevar a cabo todo un flujo de trabajo que incluya implementar una actualización de WooCommerce en el entorno de producción, ejecutar pruebas de regresión visual y superarlas, vaciar la caché y actualizar los registros indicando que todo ha salido bien. Sin embargo, es posible que un cliente se ponga en contacto más tarde porque el proceso de pago no funciona bien.
A primera vista, parece un problema de la IA. Si una prueba de regresión comprueba el diseño de la página pero no revisa la integración de la pasarela de pago que hay detrás, esto provocará errores. En este caso, el agente de IA hace exactamente aquello para lo que fue creado, así que no sabrá qué más hay que revisar. En realidad, se trata de un problema humano.
Sin embargo, esto no es un argumento contra la automatización. Aun así, un flujo de trabajo necesita puntos de pausa deliberados para llevar a cabo las comprobaciones necesarias. Aunque la mayoría de los flujos de trabajo de WordPress no necesitan momentos en los que un agente de IA pueda explicar lo que sabe y esperar a que se tome una decisión, algunos sí los necesitan. Esto es especialmente cierto en el caso de los flujos de trabajo más complejos, pero no siempre resulta obvio.
El análisis de Zylos Research sobre los patrones de traspaso de tareas de los agentes a las personas señala que los despliegues de IA en entornos de producción suelen situarse en torno a un porcentaje de decisiones automatizadas del 70-80 %, y que el resto es revisado por una persona.
En cuanto a las operaciones de WordPress, puedes seguir planificando con antelación utilizando estas divisiones de varias formas:
- Los despliegues se dividen claramente entre una transferencia rutinaria de archivos y una migración de la base de datos que afecta a los pedidos en curso.
- Las actualizaciones se dividen entre parches de plugins de bajo riesgo y todo lo que afecte a una pasarela de pago o a un sistema de membresía.
- La publicación de contenidos se divide entre las entradas programadas y todo aquello que contenga información sobre precios, aspectos legales o cuestiones críticas para la seguridad.
- Los incidentes de seguridad pueden dividirse entre la contención automática y la decisión subjetiva sobre qué los ha provocado.
- Cambios en la infraestructura y la facturación que se dividen entre una alerta de uso y la decisión de ampliar, reducir o transferir un sitio.
La división no consiste simplemente en gestionar una categoría residual de tareas no automatizadas. Todo lo que se salga de un patrón que un agente de IA ya haya visto (como cambios irreversibles o transacciones en tiempo real) es donde los errores salen más caros.
Un mal proceso de escalado cuesta más de lo que se ahorra con la automatización
El estudio NANDA del MIT reveló que el 95 % de los proyectos piloto de IA generativa en empresas no muestran ningún resultado cuantificable en cuanto a beneficios o pérdidas. Hay un patrón habitual que lo corrobora:
- Un equipo se encargará primero de automatizar la mayor parte del flujo de trabajo, que es la más sencilla.
- A continuación, tratan lo que queda como algo secundario.
- Por último, asumen el coste cuando esa pequeña parte resulta ser muy arriesgada.
Una pipeline de creación de contenidos que de vez en cuando necesita una revisión manual es flexible, por ejemplo, cuando un borrador se queda ahí una hora más. Sin embargo, una pipeline de despliegue que de vez en cuando estropea un pedido en producción no es tan flexible, porque hay ciertos tipos de errores que no se compensan entre sí:
- Una migración fallida de la base de datos en mitad del proceso de pago puede hacer que se pierdan los pedidos realizados entre la copia de seguridad y el fallo, no solo retrasarlos.
- Las pasarelas de pago que no funcionan bien siguen desviando tráfico y provocando pérdidas de ventas mientras no te des cuenta.
- Una respuesta de seguridad mal gestionada puede convertir un incidente ya controlado en una interrupción del servicio más prolongada de lo que habría causado el ataque original.
Los informes más recientes revelan que el 85 % de los responsables de la Experiencia del Cliente (CX) afirman que basta con un solo problema sin resolver para perder a un cliente. Aunque un flujo de trabajo que automatiza todo sin dudar y que rara vez deriva los casos a un nivel superior puede parecer una solución eficiente y óptima, al final acabará dejando al cliente con un problema sin resolver, ya que no hay nadie en el proceso que pueda detectarlo.
5 operaciones de WordPress en las que es mejor que decida una persona
Lo mejor es automatizar lo que se pueda revertir y, luego, derivar el resto a un nivel superior. Un cambio que se pueda revertir (o que, al menos, no suponga un gran coste si sale mal) y que siga un patrón que el flujo de trabajo ya haya gestionado antes se puede automatizar sin problemas.
Los cambios irreversibles o costosos, así como aquellos que se salen de un patrón reconocido, deberían remitirse a un nivel superior. A continuación te explico cómo se distribuyen estas clasificaciones entre las cinco categorías que conforman la mayor parte del trabajo diario de una operación de WordPress.
1. Despliegues: automatizar el proceso de implementación y acelerar la migración
Una tarea como subir un archivo a un sitio de contenido no tiene graves consecuencias si algo sale mal. Solo tienes que restaurar la copia de seguridad y volver a subir el archivo, lo que lleva unos minutos. Sin embargo, una migración de la base de datos en mitad del proceso de pago en una tienda de WooCommerce en funcionamiento es un error de otro tipo. Los pedidos realizados entre la copia de seguridad y el fallo no aparecerán en la copia restaurada, así que revertir el cambio no solucionará el problema.
La función de envío selectivo de Kinsta te permite actuar ante este tipo de incidentes. En lugar de enviar todo el entorno, puedes elegir enviar solo los archivos, la base de datos o ambos a la vez. Kinsta realiza una copia de seguridad automática del entorno de destino antes de que se ejecute nada.
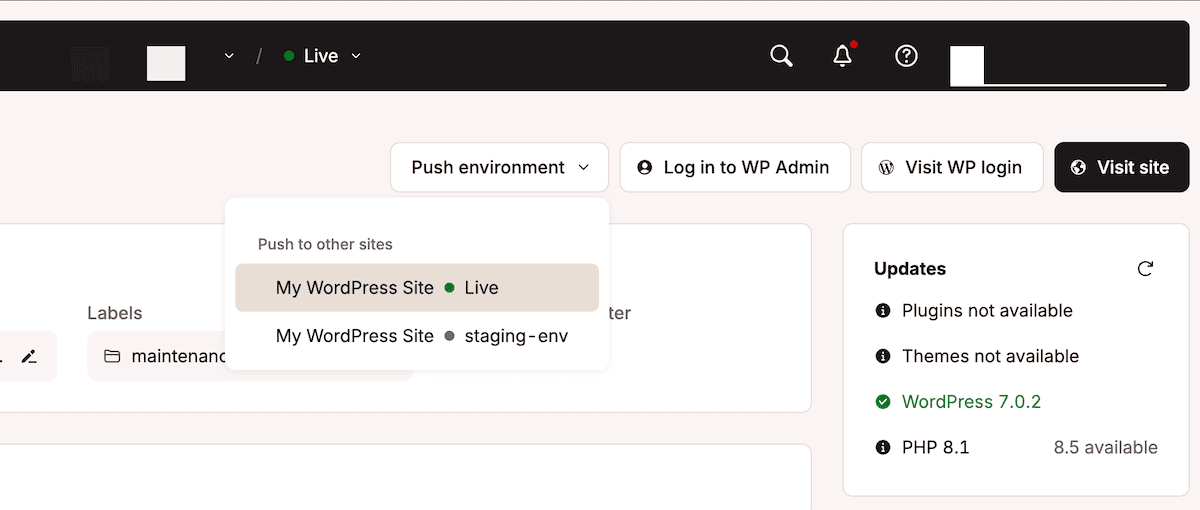
Si usas esto, puedes proporcionar a la capa de automatización la información necesaria para que trate una sincronización rutinaria de archivos de forma diferente a una migración que requiera una revisión adicional.
Para los despliegues basados en la API de Kinsta, el orden correcto es:
POST/sites/environments/{env_id}/manual-backupsse crea una copia de seguridad con una marca de tiempo registrada antes de que nada toque el entorno de producción.PUT/sites/{site_id}/environmentsenvía el entorno staging al de producción.POST/sites/cdn/clear-cachelimpia la caché de la CDN después.
Cada paso devuelve un operation_id que el script comprueba antes de seguir adelante. Si algún paso falla, el flujo de trabajo se detiene en lugar de seguir adelante tras el fallo y entrar en un estado que nadie había previsto. La secuencia completa de endpoints está documentada aquí, junto con ejemplos de cómo las agencias la integran en sus pipelines de CI/CD.
Sod, cliente de Kinsta, sabe perfectamente lo que pasa cuando no se tiene en cuenta esta distinción en un flujo de trabajo. Esta agencia de Melbourne gestiona más de 400 sitios de WordPress y, en cuanto dejó de tratar todos los sitios de la misma manera, el equipo notó mayores beneficios:
La API de Kinsta nos ha permitido desarrollar herramientas internas que automatizan procesos cruciales, como el aprovisionamiento de sitios, y realizan operaciones en lote en todos nuestros sitios web, lo que nos ahorra mucho tiempo y esfuerzo.
– Pete Brundle, jefe de desarrollo en Sod
2. Actualizaciones: automatizar la aplicación de parches y escalar la pasarela de pago
Muchos errores en los sitios son problemas sin mayor importancia, como la actualización de un plugin en un sitio corporativo, como en un sitio en el que lo peor que puede pasar es que se rompa el diseño, algo que notarás y arreglarás. Lo que sí puede darte problemas es la funcionalidad interna, como en una tienda con una pasarela de pago o un sistema de membresía. Aunque la página de pago pueda parecer totalmente normal, la transacción que hay detrás podría dejar de funcionar sin que te des cuenta.
Aquí es donde entran en juego las Actualizaciones Automáticas de Kinsta. Esta herramienta te permite configurar un calendario y un intervalo de tiempo para que se activen las actualizaciones de los plugins y los temas. Automatiza la captura y comparación de capturas de pantalla del sitio web antes y después de cada actualización para detectar cualquier cambio visible. Si hay alguna diferencia, restaura automáticamente la copia de seguridad anterior a la actualización.
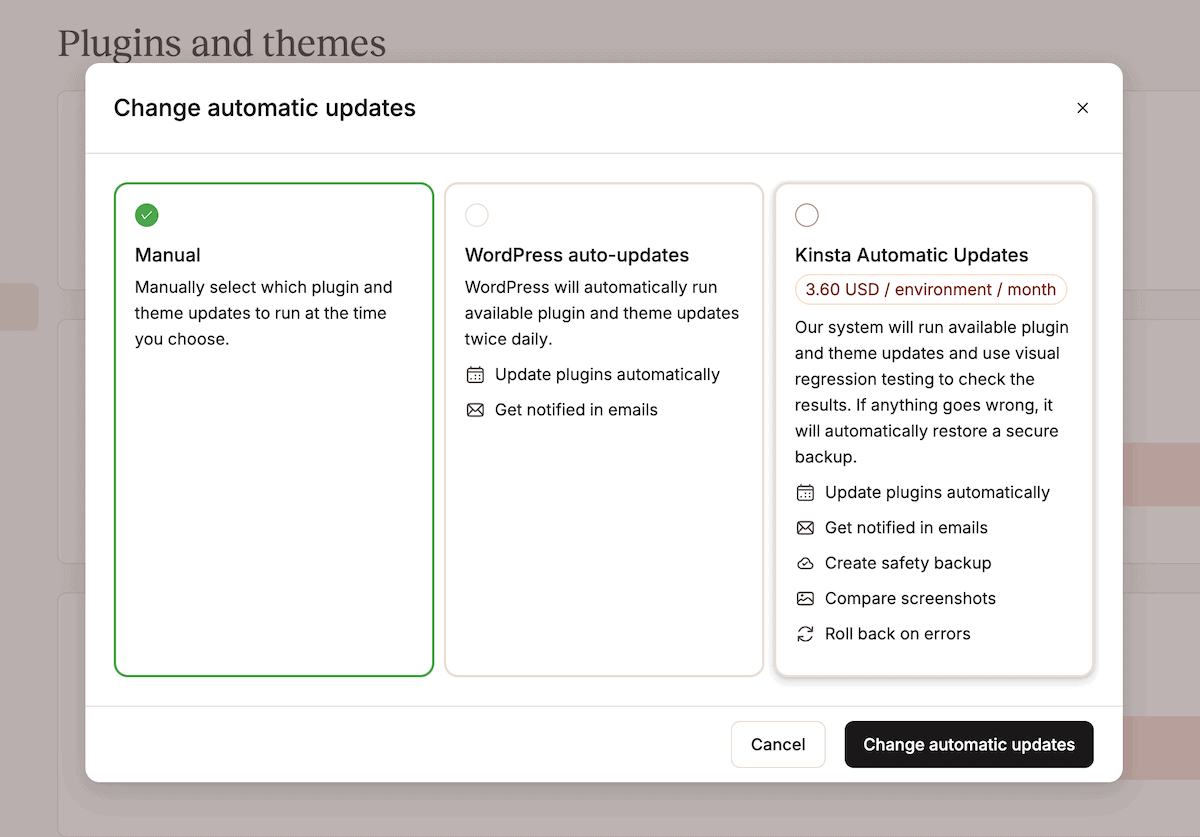
Sin embargo, la diferencia entre lo que una prueba visual puede o no puede detectar es precisamente la razón por la que WP Umbrella creó su propia capa de monitorización utilizando la infraestructura de Kinsta, en lugar de limitarse a confiar únicamente en las actualizaciones.
Abrimos un ticket y, en cuestión de horas, el problema se solucionó. Créeme, después de haber contactado con varios proveedores de alojamiento, no suele ser tan fácil.
– Aurelio Volle, cofundador de WP Umbrella
Ahora WP Umbrella tiene datos claros sobre la gran diferencia que supone una respuesta rápida y humana cuando, de vez en cuando, se te pasa algo por alto.
3. Publicación de contenidos: automatizar la programación y mejorar la calidad de los contenidos
Una pipeline de publicación puede encargarse de la programación, los metadatos de SEO, preparación de la caché (cache warming) tras la publicación y la distribución en redes sociales sin necesidad de intervención humana. Lo que suele dar problemas es el contenido que, si es incorrecto, tiene consecuencias en el mundo real.
Una entrada de blog en la que se explica cómo instalar un plugin no tiene grandes consecuencias si contiene un error. Pero un artículo en el que se indican precios, se dan recomendaciones médicas, se explican requisitos legales o se habla del lanzamiento de un producto con una fecha concreta es otra cosa. Si un borrador creado con ayuda de la IA publica un precio incorrecto o unas recomendaciones de seguridad desactualizadas, el daño es inmediato y concreto.
El factor decisivo no es «¿lo ha escrito una IA?», sino «¿este contenido puede acarrear consecuencias si es incorrecto?». Los cambios de precios, los temas YMYL (salud, finanzas, asuntos legales), los lanzamientos de productos con fecha límite y los avisos de seguridad deben pasar por una revisión humana antes de su publicación, independientemente de cómo se haya creado el contenido.
Automatizar el pipeline es eficiente, pero automatizar la decisión sobre qué se incluye en él es lo que hace que un problema concreto y evitable se publique a gran escala.
4. Seguridad: automatizar la contención y escalar la respuesta
La rapidez es fundamental cuando tu sitio y tu servidor están sufriendo un ataque. Una vez que hayas contenido ese ataque, el siguiente paso acertado es evaluar la situación. Ambas situaciones requieren acciones y procesos diferentes.
Por ejemplo, bloquear una IP maliciosa confirmada es siempre la misma acción correcta, por lo que es seguro dejarlo en manos de un agente de IA. Sin embargo, decidir si un pico de tráfico se debe a que un competidor está recopilando tus precios, a una integración defectuosa, a un rastreador de IA o a cualquier otra cosa que merezca la pena dejar pasar requiere un contexto del que un sistema automatizado carece.
La Protección contra Bots de Kinsta clasifica el tráfico entrante en tiempo real y frena a los actores maliciosos mediante cuatro niveles de protección preestablecidos que puedes aplicar por sitio o en lote. Un botón específico bloquea solo a los rastreadores de IA, mientras que los bots verificados (como Googlebot) siempre pasan sin problemas. Esto significa que tu visibilidad en los buscadores nunca se ve afectada por una decisión sobre el tráfico de IA.
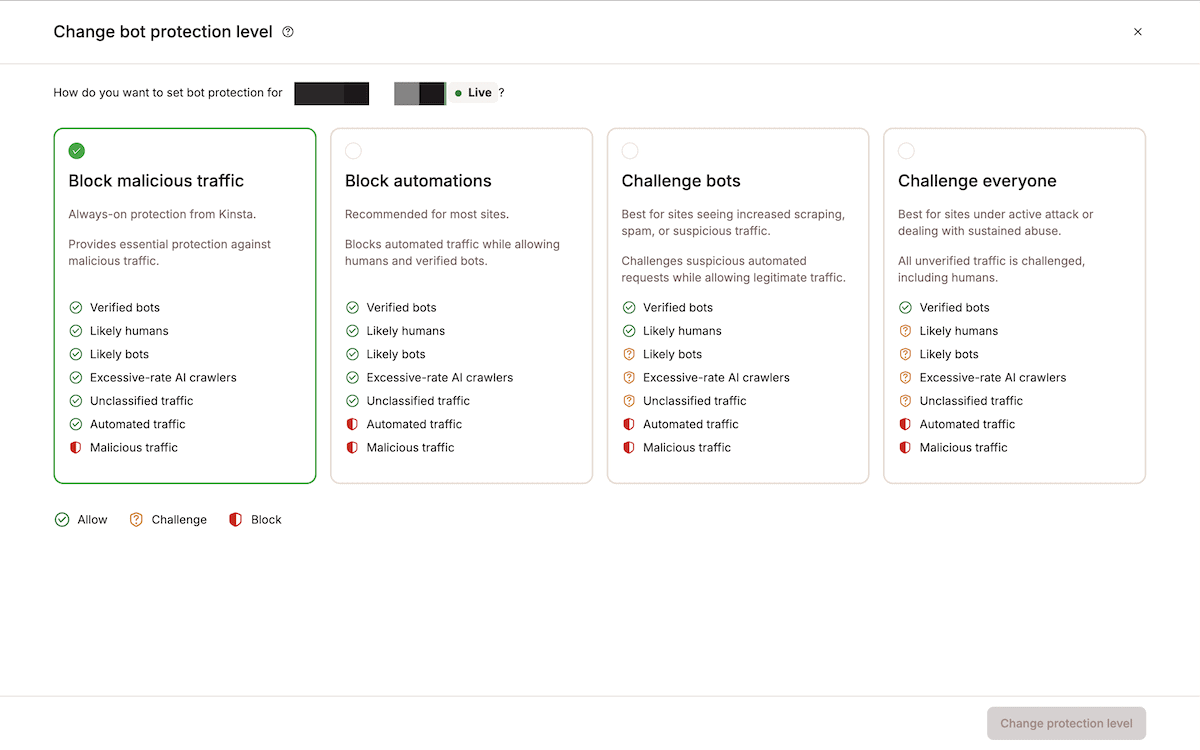
Sin embargo, lo que la herramienta no hace es decidir si un patrón inusual merece un análisis más detallado, y por eso aquí se necesita la intervención humana.
Para Adapting Social, conseguir una contención adecuada significa que el equipo ya no tiene que dedicar tanto tiempo a apagar incendios:
Necesitábamos una solución de alojamiento que estuviera a la altura de nuestro compromiso con la excelencia y nos diera la confianza necesaria para ofrecer servicios de alojamiento a nuestros clientes. Una que fuera fiable, funcionara bien y mantuviera las páginas web de nuestros clientes seguras y protegidas. Fue entonces cuando descubrimos Kinsta.
– Christopher Iafelice, director de operaciones de Adapting Social
5. Infraestructura y facturación: automatizar la alerta y escalar la decisión
Los cambios en la infraestructura y la facturación son los que menos ambigüedad tienen de las cinco categorías, lo que significa que es fácil equivocarse. Es bastante seguro automatizar la detección de un problema. Sin embargo, tomar medidas al respecto casi nunca es seguro, porque tareas como la transferencia de un sitio web o un cambio en los DNS (y muchas otras que afectan al tráfico en tiempo real) no son reversibles como lo es, por ejemplo, vaciar la caché.
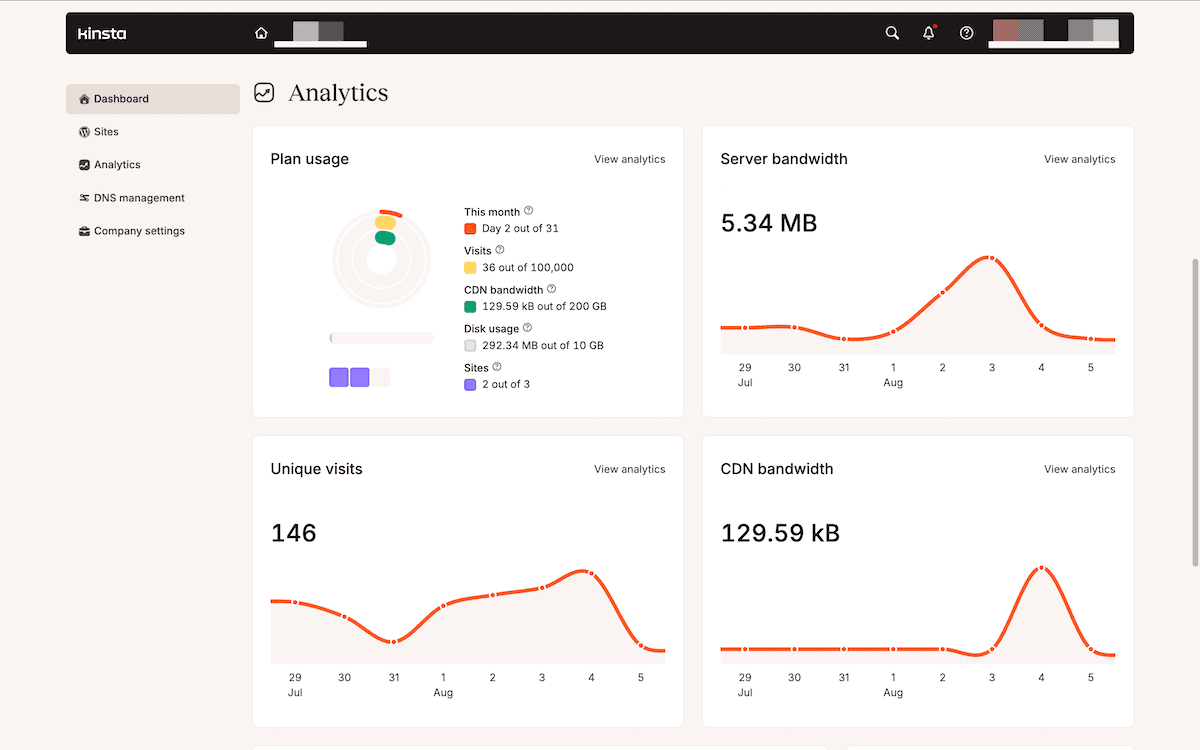
La estructura de los planes de Kinsta te permite aprovechar estos aspectos en lugar de luchar contra ellos:
- Se pueden enviar automáticamente notificaciones de uso al alcanzar el 80 % y el 100 % de tu límite de visitas, almacenamiento o ancho de banda, mucho antes de que se aplique cualquier recargo por exceso de consumo.
- La decisión de ampliar el plan, añadir un add-on de espacio en disco o asumir un exceso ocasional depende del presupuesto y del contexto, por lo que estas decisiones las tomas tú.
- Los cambios de plan, la incorporación de usuarios a nivel de empresa o las actualizaciones de facturación están restringidos en MyKinsta al propietario o al administrador de la empresa, independientemente de quién más tenga acceso a la cuenta.
Ese último punto es el mismo principio de «automatizar y escalar» aplicado a las personas en lugar de a los flujos de trabajo: quien sea el responsable de la cuenta es quien toma la decisión financiera, no quien esté conectado en ese momento cuando se supere un umbral. Para una agencia que gestiona cientos de entornos de clientes, esta estructura es la que evita que un pico inesperado se convierta en discusiones con los clientes.
Intenta dar contexto a tus clientes en lugar de enviarles una alerta
Si tu procedimiento de escalado solo explica lo que hay que tener en cuenta, la persona que lo recibe tiene que reconstruir lo que ha pasado antes de poder tomar una decisión. Esto supone un gran retraso y puede afectar a la rapidez de cualquier posible proceso de escalado.
Un proceso de transferencia bien diseñado incluye tres elementos, en lugar de dejar ese trabajo en manos de quien lo reciba:
- Qué estaba haciendo el flujo de trabajo cuando se detuvo, para que nadie tenga que adivinar en qué consistía la tarea en general.
- El motivo concreto de la pausa, en un lenguaje sencillo en lugar de estar oculto en un archivo de registro.
- Si ahora se requiere la decisión de una persona, lo cual debe presentarse como una opción única y clara, no como un problema abierto.
En resumen, quien se haga cargo de un despliegue pausado debería poder ver, todo en un mismo sitio, la actualización pendiente, el entorno al que va dirigida y el resultado de las pruebas de regresión que lo detuvo. Además, el flujo de trabajo debería reanudarse justo desde ese punto una vez que alguien lo apruebe, en lugar de empezar de cero.
En el caso de un despliegue basado en la API de Kinsta, esto significa que la copia de seguridad ya estará hecha y que el envío a staging estará listo. Así, la persona encargada de tomar decisiones solo tiene que ocuparse de una única tarea, en lugar de tener que revisar todo el pipeline.
Los propios registros de actividad y las pantallas de Actividad del usuario de Kinsta reflejan este mismo instinto a menor escala. Cada entrada muestra quién realizó una acción, cuándo y si tuvo éxito.
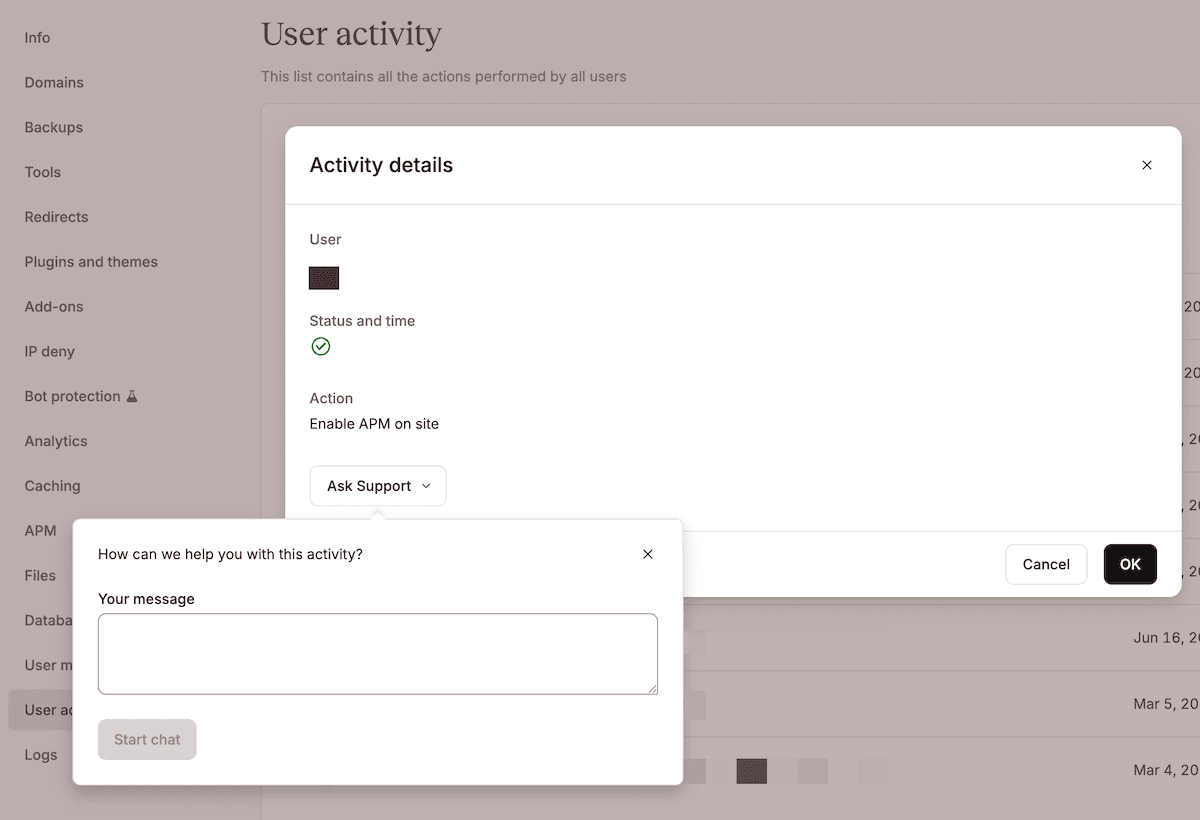
Al abrir los detalles completos de una entrada, puedes plantear directamente una duda sobre una acción al equipo de soporte de Kinsta, en lugar de empezar con una descripción incompleta del problema que otra persona tiene que reconstruir.
La automatización se encarga de lo predecible, mientras que el criterio se encarga del resto
En lugar de preocuparte por si un paso se puede automatizar dentro de tu flujo de trabajo de WordPress (porque casi cualquier paso se puede automatizar), deberías centrarte en lo que pasa cuando tu flujo de trabajo se encuentra con algo que se sale de los parámetros esperados.
Para hacerlo bien, lo fundamental es automatizar lo que se puede revertir, de modo que se pueda ejecutar la mayor parte del flujo de trabajo. A partir de ahí, puedes definir por escrito los umbrales de escalado e incluir toda la información necesaria en cada transferencia. Así, quienquiera que se haga cargo podrá actuar de inmediato, en lugar de tener que empezar desde cero.
Explora la API de Kinsta para empezar a crear flujos de trabajo con un punto de traspaso definido, o descubre cómo el alojamiento para agencias de Kinsta ayuda a los equipos a gestionar docenas de sitios web de clientes a la vez.