Ajouter comme source préférée sur Google
Lorsque vous constatez qu’une grande partie du trafic de votre site provient de robots, leur blocage peut sembler être la suite logique. Dans certains cas, les chiffres justifient effectivement une réaction immédiate.
PatronView a récemment recensé 3,6 millions de requêtes sur son site en une seule journée, le trafic provenant de plus de 360.000 adresses IP. Le propriétaire du site a finalement mis en place un ensemble de règles Cloudflare assez strictes pour maitriser ce trafic.
Nous avons également constaté des cas extrêmes sur notre propre infrastructure. Dans notre rapport sur le trafic généré par l’IA et les robots, un robot d’indexation a généré 3,75 millions de requêtes vers des URL d’ajout au panier en 24 heures. Une autre boucle répétitive a généré des centaines de millions de requêtes avant que nous ne mettions en place une règle pour la bloquer.
Ces cas sont réels, mais ils ne reflètent pas la situation de tous les sites web.
Dans notre dernière analyse portant sur plus de 5000 sites WordPress, les robots IA ne représentaient que 1,57 % de la bande passante sur le site médian, contre 17,8 % au 90e centile et 90,3 % au 99e centile, tandis que plus de 1000 sites n’enregistraient aucune consommation de bande passante liée aux robots IA.
C’est cette disparité qui explique pourquoi détecter le trafic des robots IA et diagnostiquer un problème lié à ces robots sont deux choses différentes.
Les décisions que vous prendrez ensuite peuvent avoir une incidence sur les performances de votre site, ses intégrations, sa visibilité dans les moteurs de recherche, ainsi que sur la capacité des outils d’IA à mettre en avant votre contenu. Avant de modifier quoi que ce soit, vous devez savoir ce que font réellement ces robots.
Voici quelques erreurs que nous constatons chez les propriétaires de sites lorsqu’ils négligent cette étape.
Erreur n° 1 : considérer le pourcentage comme un diagnostic
Si les robots d’IA représentent 20 % des requêtes de votre site, ce chiffre à lui seul ne vous indique pas s’il y a un problème.
Une part importante de requêtes vers des articles mis en cache peut exercer une pression relativement faible sur l’application, tandis qu’un nombre plus restreint de requêtes ciblant de manière répétée les résultats de recherche, les pages de produits filtrées ou les URL de panier peut générer une charge de travail bien plus importante.
C’est l’une des raisons pour lesquelles les statistiques relatives aux robots à l’échelle du réseau doivent être interprétées avec prudence lorsqu’elles s’appliquent à un site individuel.
Nos dernières recherches ont révélé que le nombre moyen de requêtes de robots IA par site variait entre 667 et 928 par jour sur quatre mesures, contre une médiane de seulement 33 à 67 requêtes, tandis qu’environ 20 % à 27 % des sites ne recevaient aucune requête de robot IA au cours d’une journée mesurée.
En d’autres termes, un petit groupe de sites fortement explorés fait grimper la moyenne.
Ainsi, si vous lisez que les robots représentent plus de la moitié du trafic web, ou si vous voyez un autre propriétaire de site indiquer que 99 % de son trafic provient de robots, ne vous basez pas sur ce chiffre pour déterminer les besoins de votre propre site.
Commencez par analyser votre propre trafic.
Pour les clients de Kinsta, la section « Protection contre les robots » de MyKinsta indique comment les requêtes sont classées, notamment : les utilisateurs probablement humains, les robots vérifiés, les robots probables, les robots d’exploration IA, les robots d’exploration IA à fréquence excessive, le trafic automatisé et le trafic malveillant.
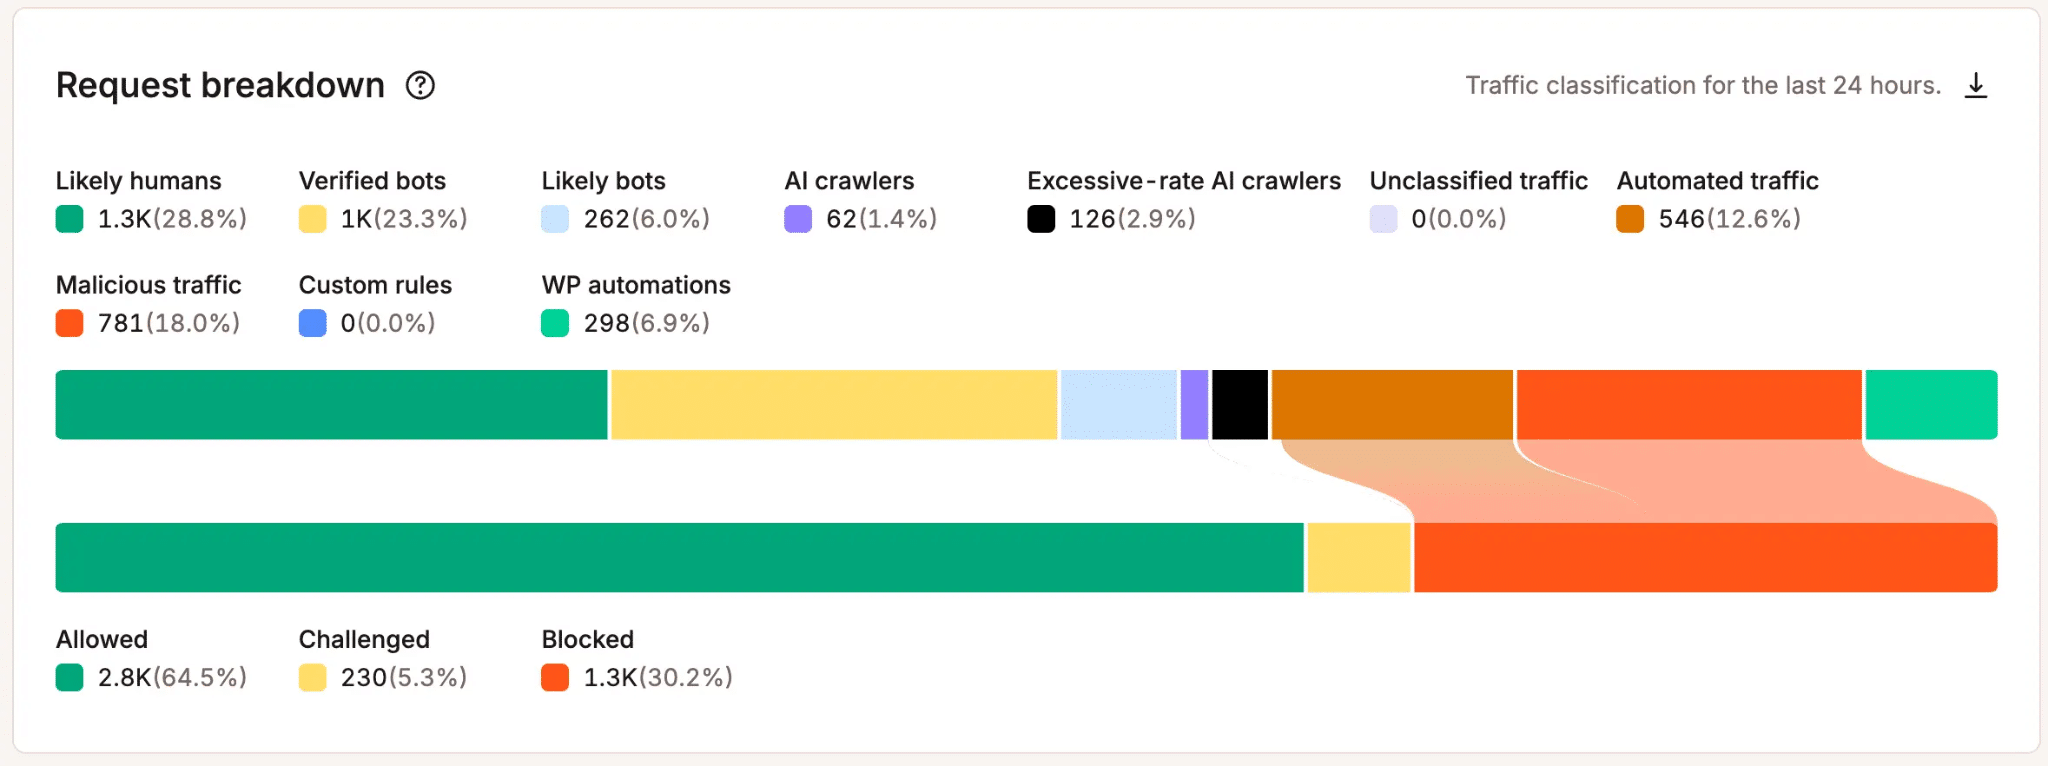
Vous pouvez ensuite utiliser la rubrique « Top traffic » pour consulter les chemins d’accès, les agents utilisateurs, les pays et les adresses IP associés à un type de trafic spécifique.
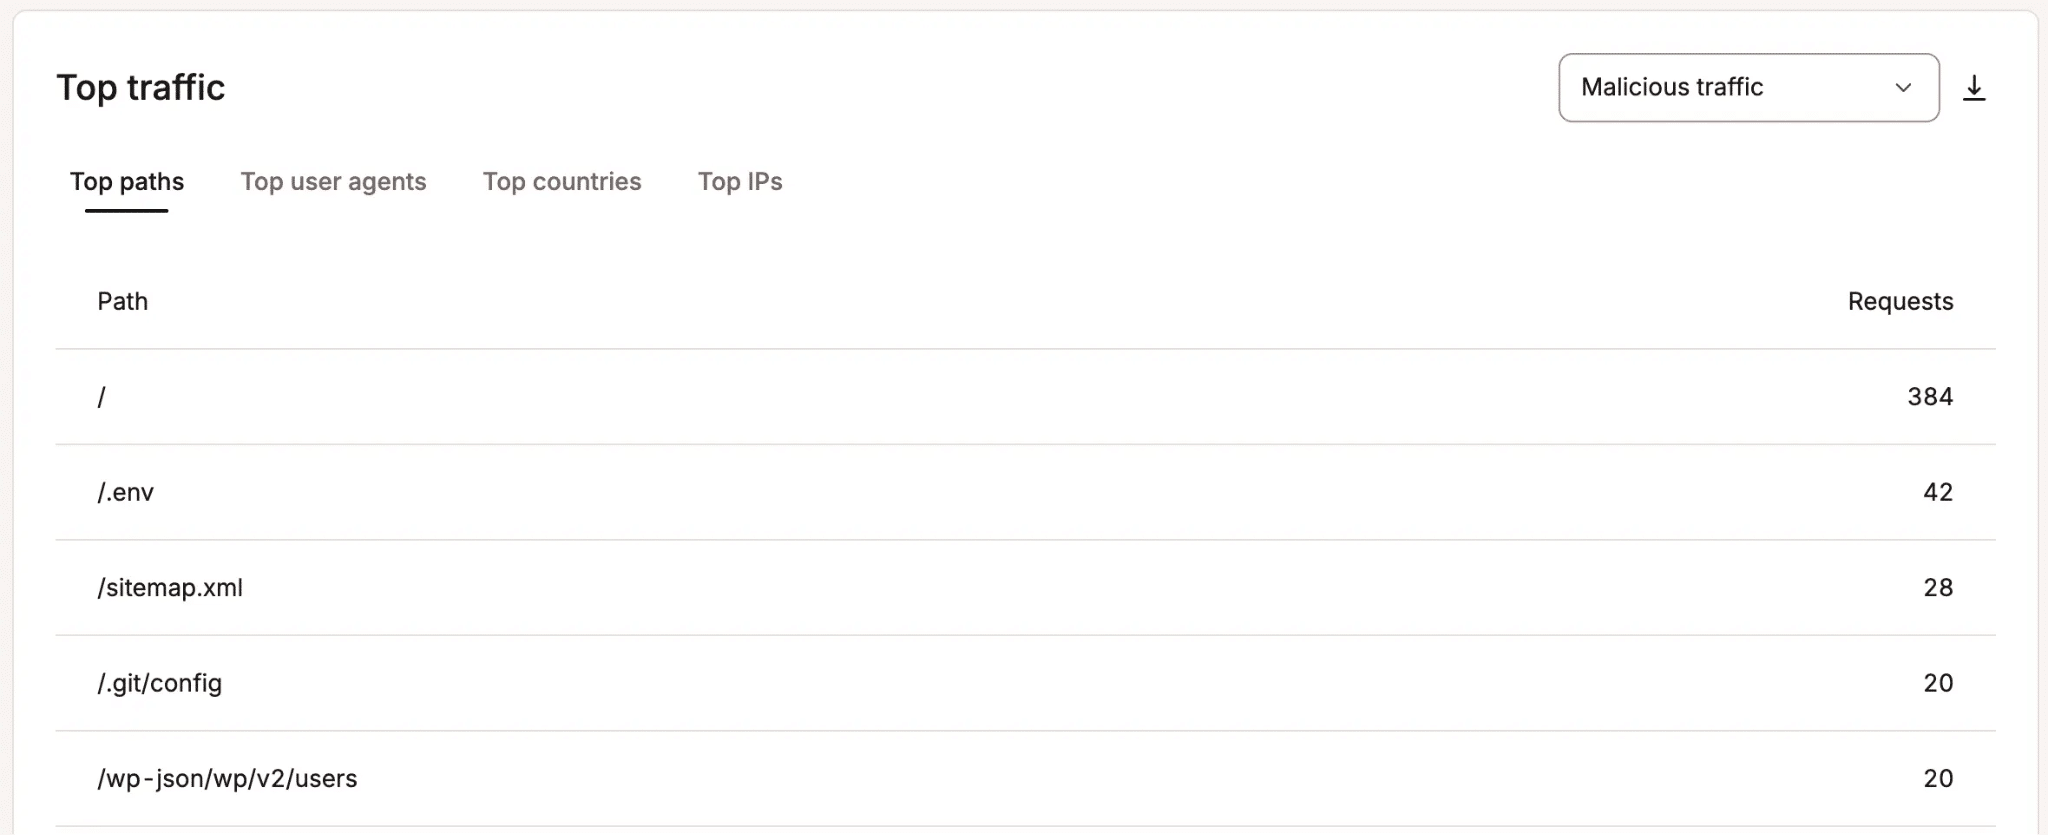
Avant de prendre des mesures, vous devriez être en mesure de répondre à quelques questions fondamentales :
- Quelle est la part réelle du trafic généré par l’IA qui atteint le site ?
- Quelles pages ou quels points de terminaison ce trafic sollicite-t-il ?
- Quels robots d’indexation, agents ou autres systèmes automatisés en sont responsables ?
- Ce trafic affecte-t-il les performances, la bande passante, les threads PHP ou l’expérience des visiteurs réels ?
Notre dernier rapport aborde cette question en examinant la provenance, les schémas et le profil du trafic. Un site recevant très peu de trafic issu de l’IA et présentant un comportement de requêtes ordinaire ne nécessite peut-être aucune intervention, tandis qu’un site confronté à un trafic de robots d’indexation soutenu vers des URL dynamiques couteuses mérite une analyse beaucoup plus approfondie.
Erreur n° 2 : bloquer tous les robots sous prétexte que le trafic est automatisé
Le terme « robot IA » recouvre désormais plusieurs types de trafic différents. Certains robots d’indexation collectent du contenu public pour l’entrainement de modèles ou la recherche IA, tandis que d’autres récupèrent des pages en réponse à la requête d’un utilisateur.
Ces différences sont importantes lorsque vous décidez ce que vous autorisez. OpenAI, par exemple, utilise GPTBot pour le contenu susceptible d’être utilisé afin d’améliorer ses modèles, tandis qu’OAI-SearchBot contribue à rendre les sites web consultables dans la recherche ChatGPT. Bloquer OAI-SearchBot peut donc avoir une incidence sur l’apparition de votre contenu dans les résultats de recherche ChatGPT.
Anthropic opère une distinction similaire. ClaudeBot collecte du contenu Web susceptible de contribuer à l’entrainement des modèles, Claude-SearchBot est utilisé pour la recherche, et Claude-User peut récupérer un site lorsqu’un utilisateur de Claude en fait la demande.
Perplexity indique que PerplexityBot est utilisé pour son index de recherche et que Perplexity-User sert à répondre aux requêtes formulées par les utilisateurs.
Google propose aux éditeurs un paramètre distinct « Google-Extended » (Autorisation de l’IA) permettant de contrôler la manière dont le contenu exploré peut être utilisé avec Gemini. Google précise explicitement que la modification de ce paramètre n’a aucune incidence sur l’inclusion ou le classement dans la recherche Google.
Regrouper tous ces systèmes sous une seule catégorie « IA » revient à écarter des informations qui pourraient vous être utiles.
Si vous préférez ne pas consacrer les ressources de votre site à l’entrainement des modèles, vous pouvez choisir de restreindre l’accès aux robots d’entrainement tout en laissant les systèmes de recherche et de récupération accessibles. Si votre problème réside dans le fait qu’un agent IA accède de manière répétée à un point de terminaison dynamique, la modification de votre politique relative aux robots d’apprentissage ne suffira peut-être pas à le résoudre.
Une question commerciale se pose également ici. Notre étude de consommation a révélé que 44,7 % des personnes interrogées ont déclaré se rendre toujours ou la plupart du temps sur le site web d’une entreprise après avoir reçu une recommandation issue de l’IA. Cela ne signifie pas que l’accès des robots d’IA génère automatiquement du trafic de référence, mais cela signifie que la découverte par l’IA mérite d’être prise en compte avant de prendre une décision générale concernant la visibilité.
Chez Kinsta, le contrôle « Bloquer les robots d’IA » permet aux clients de bloquer les robots d’IA, y compris ceux qui sont vérifiés, sans bloquer les robots des moteurs de recherche traditionnels tels que Googlebot et Bing.
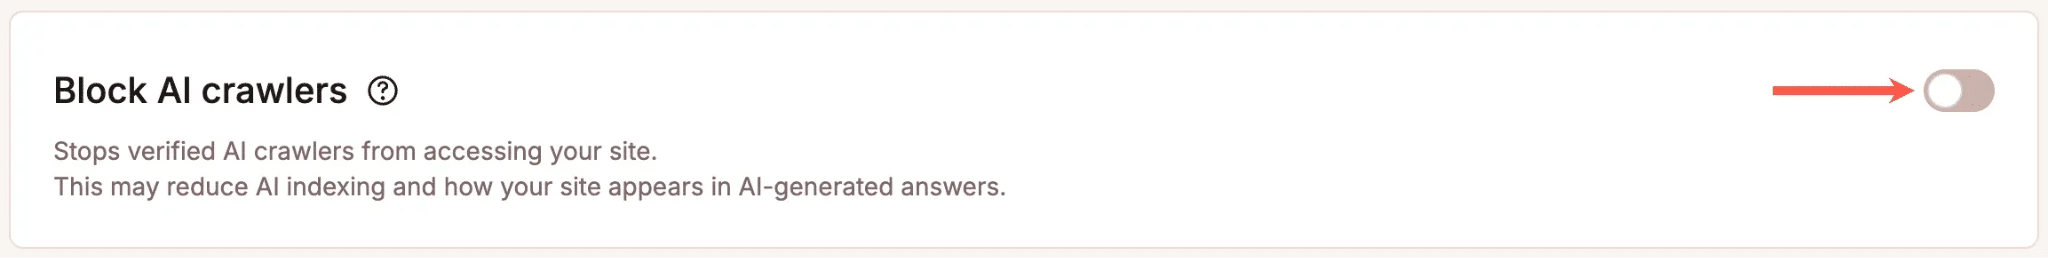
Nous avertissons également nos clients que le blocage des robots d’indexation IA peut réduire la visibilité dans les résultats de recherche, les résumés ou les recommandations générés par l’IA.
Erreur n° 3 : considérer chaque pic d’activité des robots d’indexation IA comme une urgence de sécurité
Les robots peuvent créer des problèmes de sécurité par le biais de tentatives par force brute, d’attaques DDoS, d’attaques par usurpation d’identifiants et d’autres automatisations abusives, mais un robot d’exploration IA vérifié envoyant un trop grand nombre de requêtes légitimes constitue un problème d’un autre ordre.
Lors de notre évènement en direct consacré au trafic des robots, Daniel Pataki, directeur technique de Kinsta, a expliqué pourquoi il s’inquiète de la manière dont les propriétaires de sites réagissent lorsque ces deux aspects sont confondus :
« Je crains davantage une réaction excessive dans ce cas qu’une réaction insuffisante, car il ne s’agit pas d’un problème de sécurité. »
Il faisait référence au problème plus général des robots d’indexation basés sur l’IA, où une grande partie du trafic gênant que nous observons provient de systèmes légitimes effectuant une indexation inefficace, plutôt que d’un attaquant cherchant à compromettre le site.
La réponse change lorsque le site est déjà en difficulté. Si les robots mobilisent les ressources du serveur, ralentissent les pages ou empêchent les véritables clients d’utiliser le site, la stabilisation du site est prioritaire. Daniel a recommandé de bloquer temporairement le trafic des robots lorsqu’il cause un problème concret, puis d’enquêter une fois que le site est sous contrôle.
L’erreur consiste à transformer cette mesure d’urgence en une politique permanente sans chercher à comprendre ce qui s’est passé.
La protection contre les robots de Kinsta vous offre plusieurs niveaux de contrôle, allant d’une protection de base contre le trafic malveillant au blocage des automatisations ou à la mise à l’épreuve des robots suspects lorsque une protection plus stricte est nécessaire. Les robots d’exploration basés sur l’IA présentant un taux de requêtes excessif peuvent également être soumis à des contrôles aux niveaux de protection appropriés.
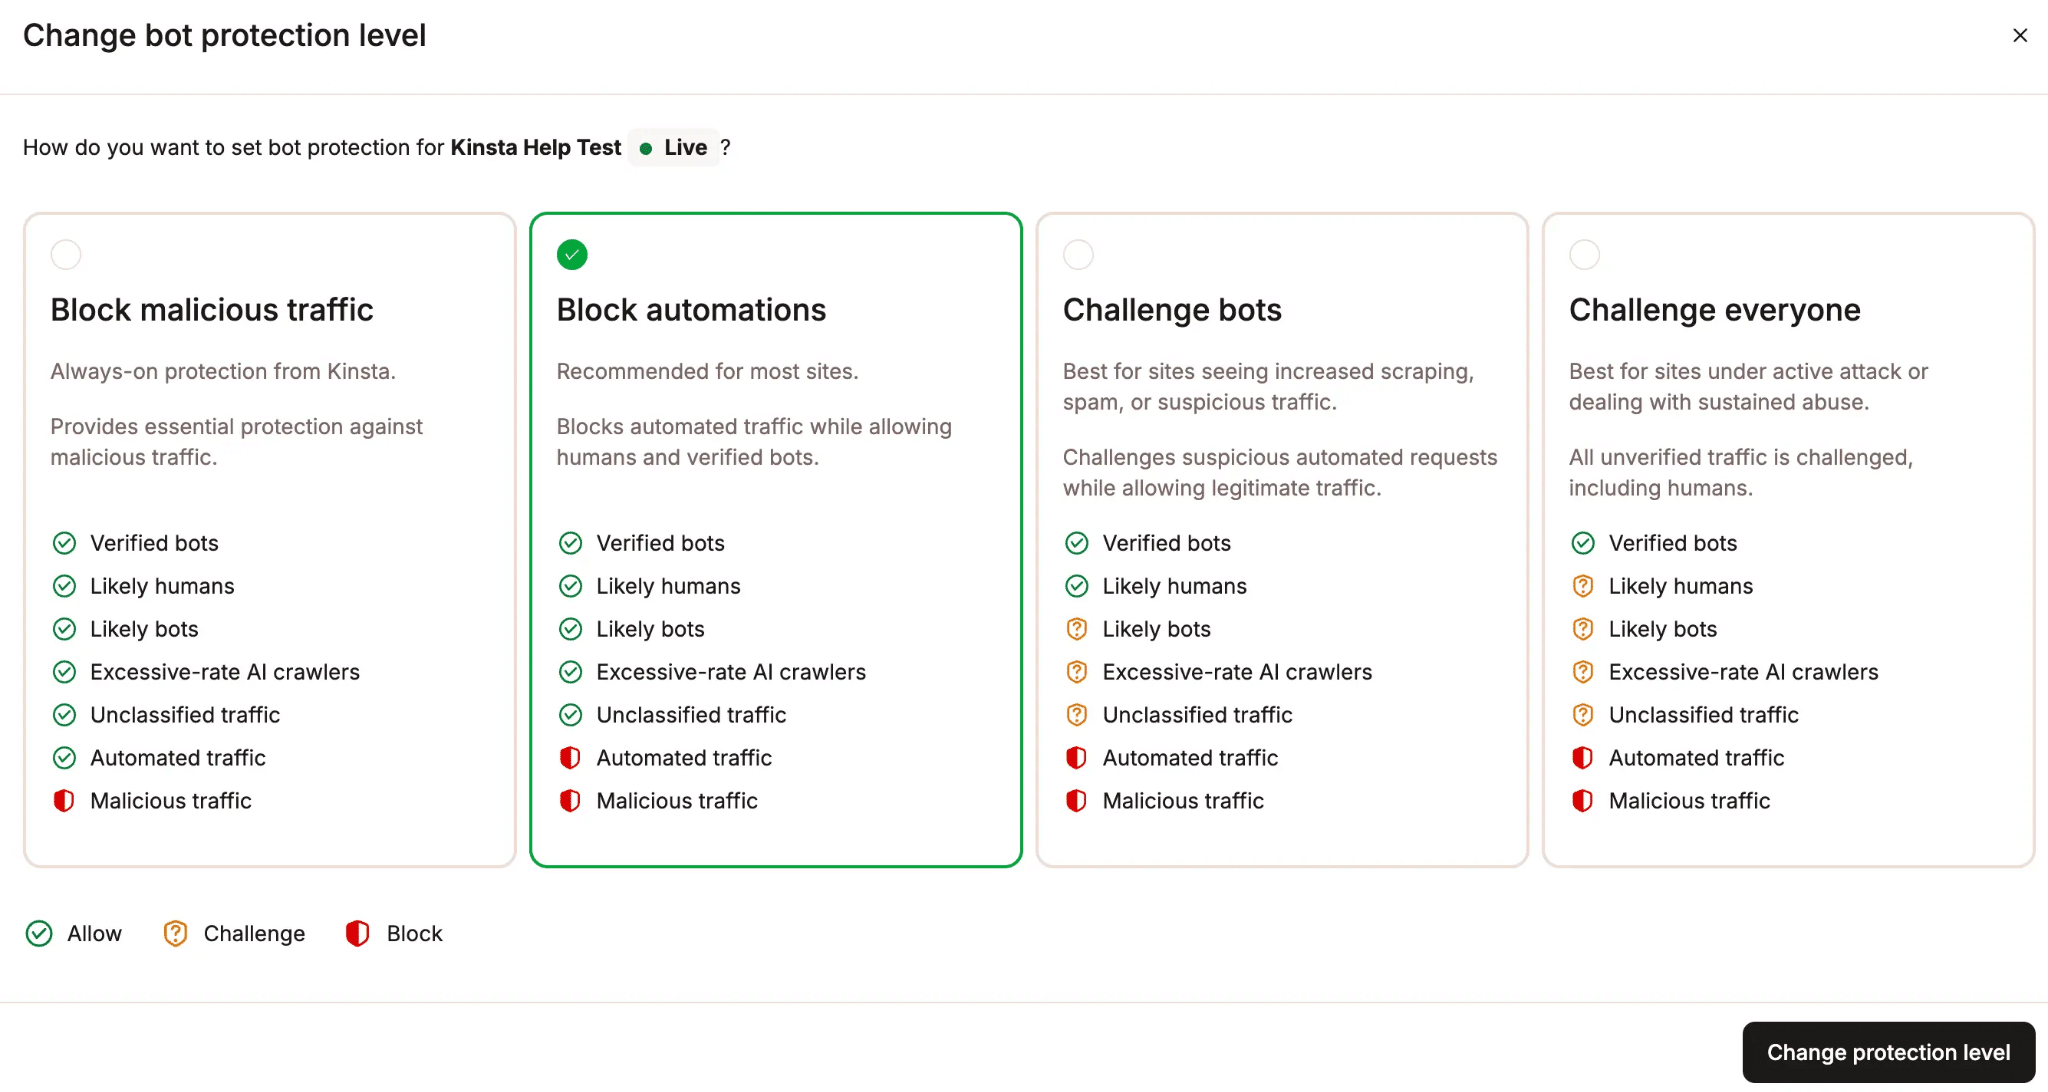
Un incident soudain affectant les performances peut justifier aujourd’hui des contrôles plus stricts. Une fois l’incident résolu, vérifiez ce qui affectait le site et si ces contrôles plus stricts restent justifiés.
Erreur n° 4 : surveiller le volume de requêtes sans tenir compte de leur destination
Nos données d’infrastructure permettent de mettre facilement en évidence cette différence. Une requête pour un article de blog mis en cache et une autre pour une page de recherche WooCommerce non mise en cache comptent toutes deux comme une seule requête, même si la seconde peut nécessiter bien plus de ressources serveur.
Voici une illustration tirée de l’événement en direct « Reality Check » consacré au trafic des robots :
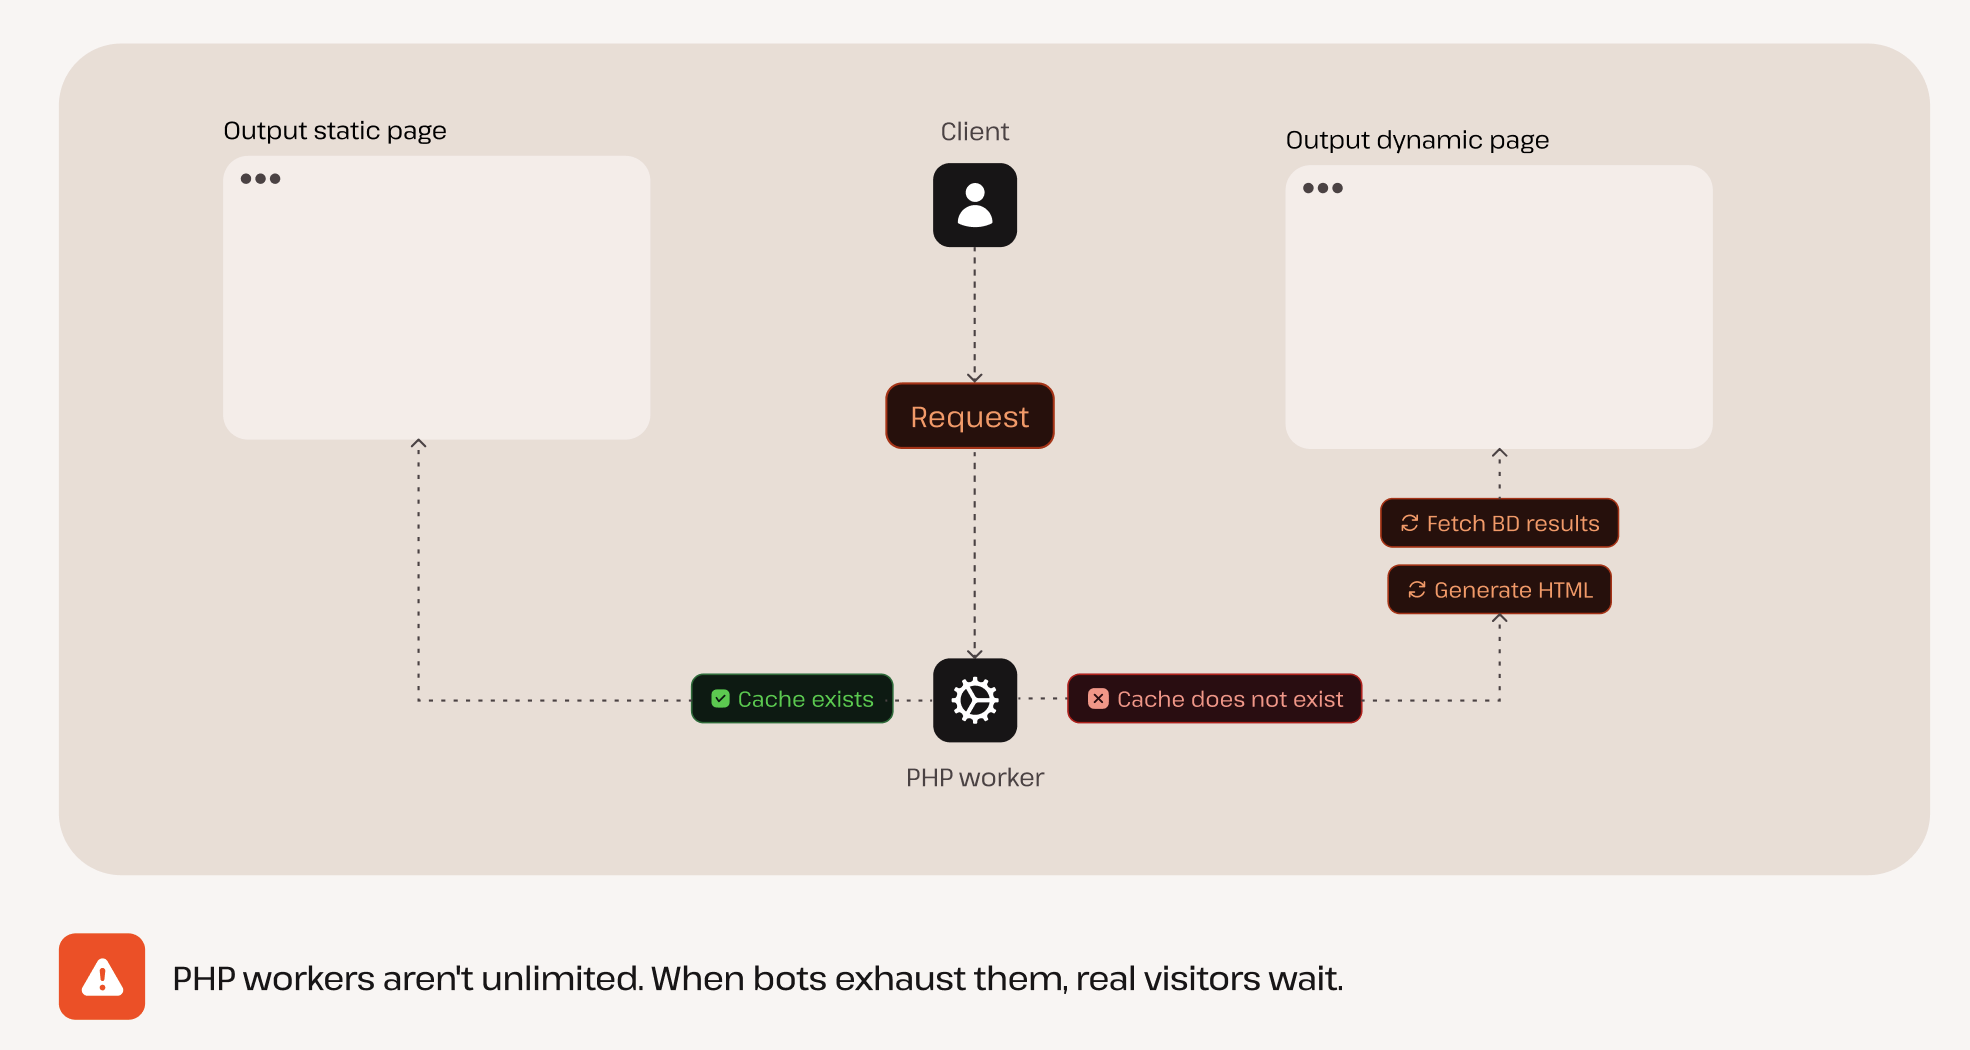
Lorsqu’une page mise en cache est disponible, WordPress peut traiter une grande partie de la requête sans avoir à régénérer la page.
Une requête dynamique peut nécessiter un thread PHP (également appelé « worker »), des requêtes de base de données, la génération de la page et, parfois, la gestion de la session avant que WordPress ne puisse renvoyer une réponse. Les activités liées au panier et à la commande peuvent alourdir encore davantage la charge de travail.
Répétez maintenant ce processus des milliers de fois.
Sur les trois mesures de notre dernière étude, entre 76,9 % et 90,5 % des requêtes des robots d’indexation basés sur l’IA concernaient du contenu dynamique. Le trafic humain est resté compris entre 18,3 % et 18,9 %.
Cette différence en dit bien plus long sur la pression potentielle exercée sur l’infrastructure qu’un simple décompte brut des requêtes.
Prenons l’exemple de l’incident lié à l’ajout au panier que nous avons constaté lors de notre étude sur le trafic des robots IA. Un robot d’indexation a généré 3,75 millions de requêtes en 24 heures, soit environ une requête toutes les 23 millisecondes. Chaque requête pouvait obliger WordPress à effectuer un travail pour un « visiteur » qui n’allait jamais rien acheter.
C’est également la raison pour laquelle deux sites présentant le même pourcentage de trafic généré par l’IA peuvent se comporter de manière très différente.
Un site de contenu où les robots d’indexation demandent principalement des articles mis en cache peut gérer un volume important sans trop de difficultés, tandis qu’une boutique WooCommerce peut ressentir l’impact bien plus rapidement si un nombre même plus restreint de requêtes cible de manière répétée la recherche, les filtres, les actions du panier, les pages de compte ou d’autres routes non mises en cache.
Une fois que vous avez détecté un pic, ne vous arrêtez pas à l’agent utilisateur.
Dans MyKinsta, vous pouvez filtrer le trafic le plus important par robots d’indexation IA et inspecter les chemins qu’ils sollicitent le plus souvent.
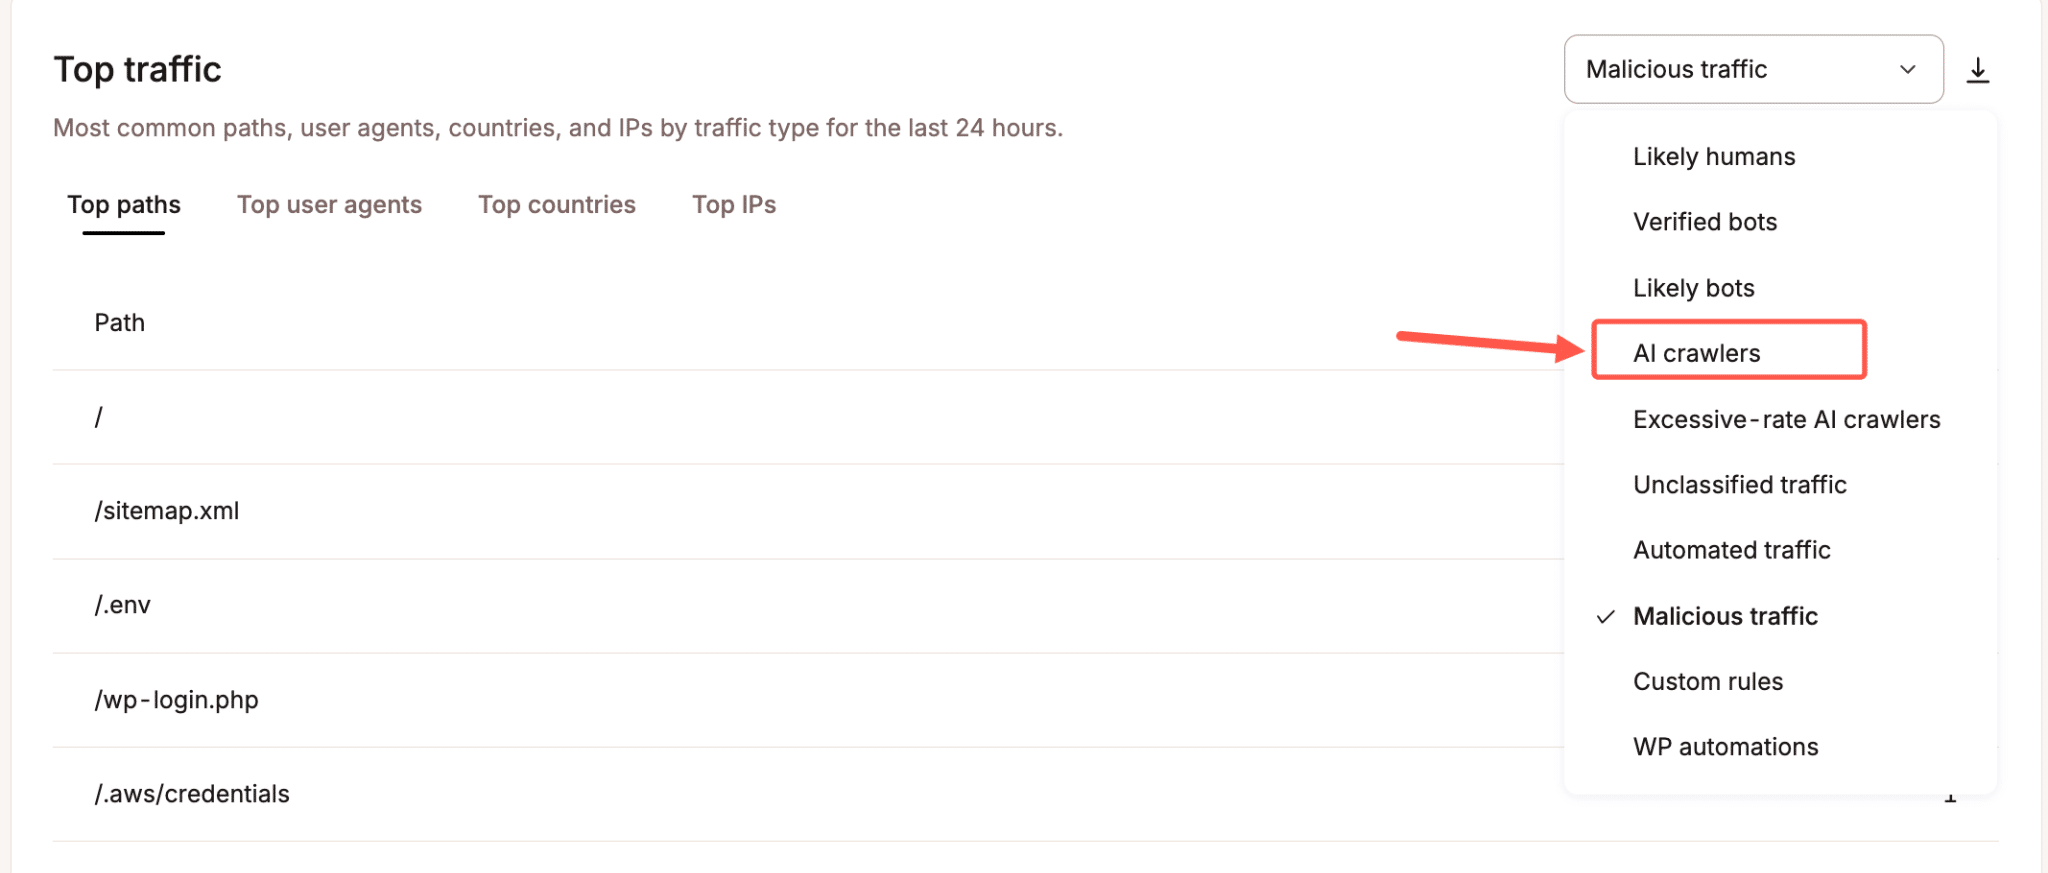
Comparez ensuite ces informations avec celles relatives au cache, à la bande passante du serveur et aux performances afin de déterminer si ces requêtes atteignent l’application et génèrent une charge de travail.
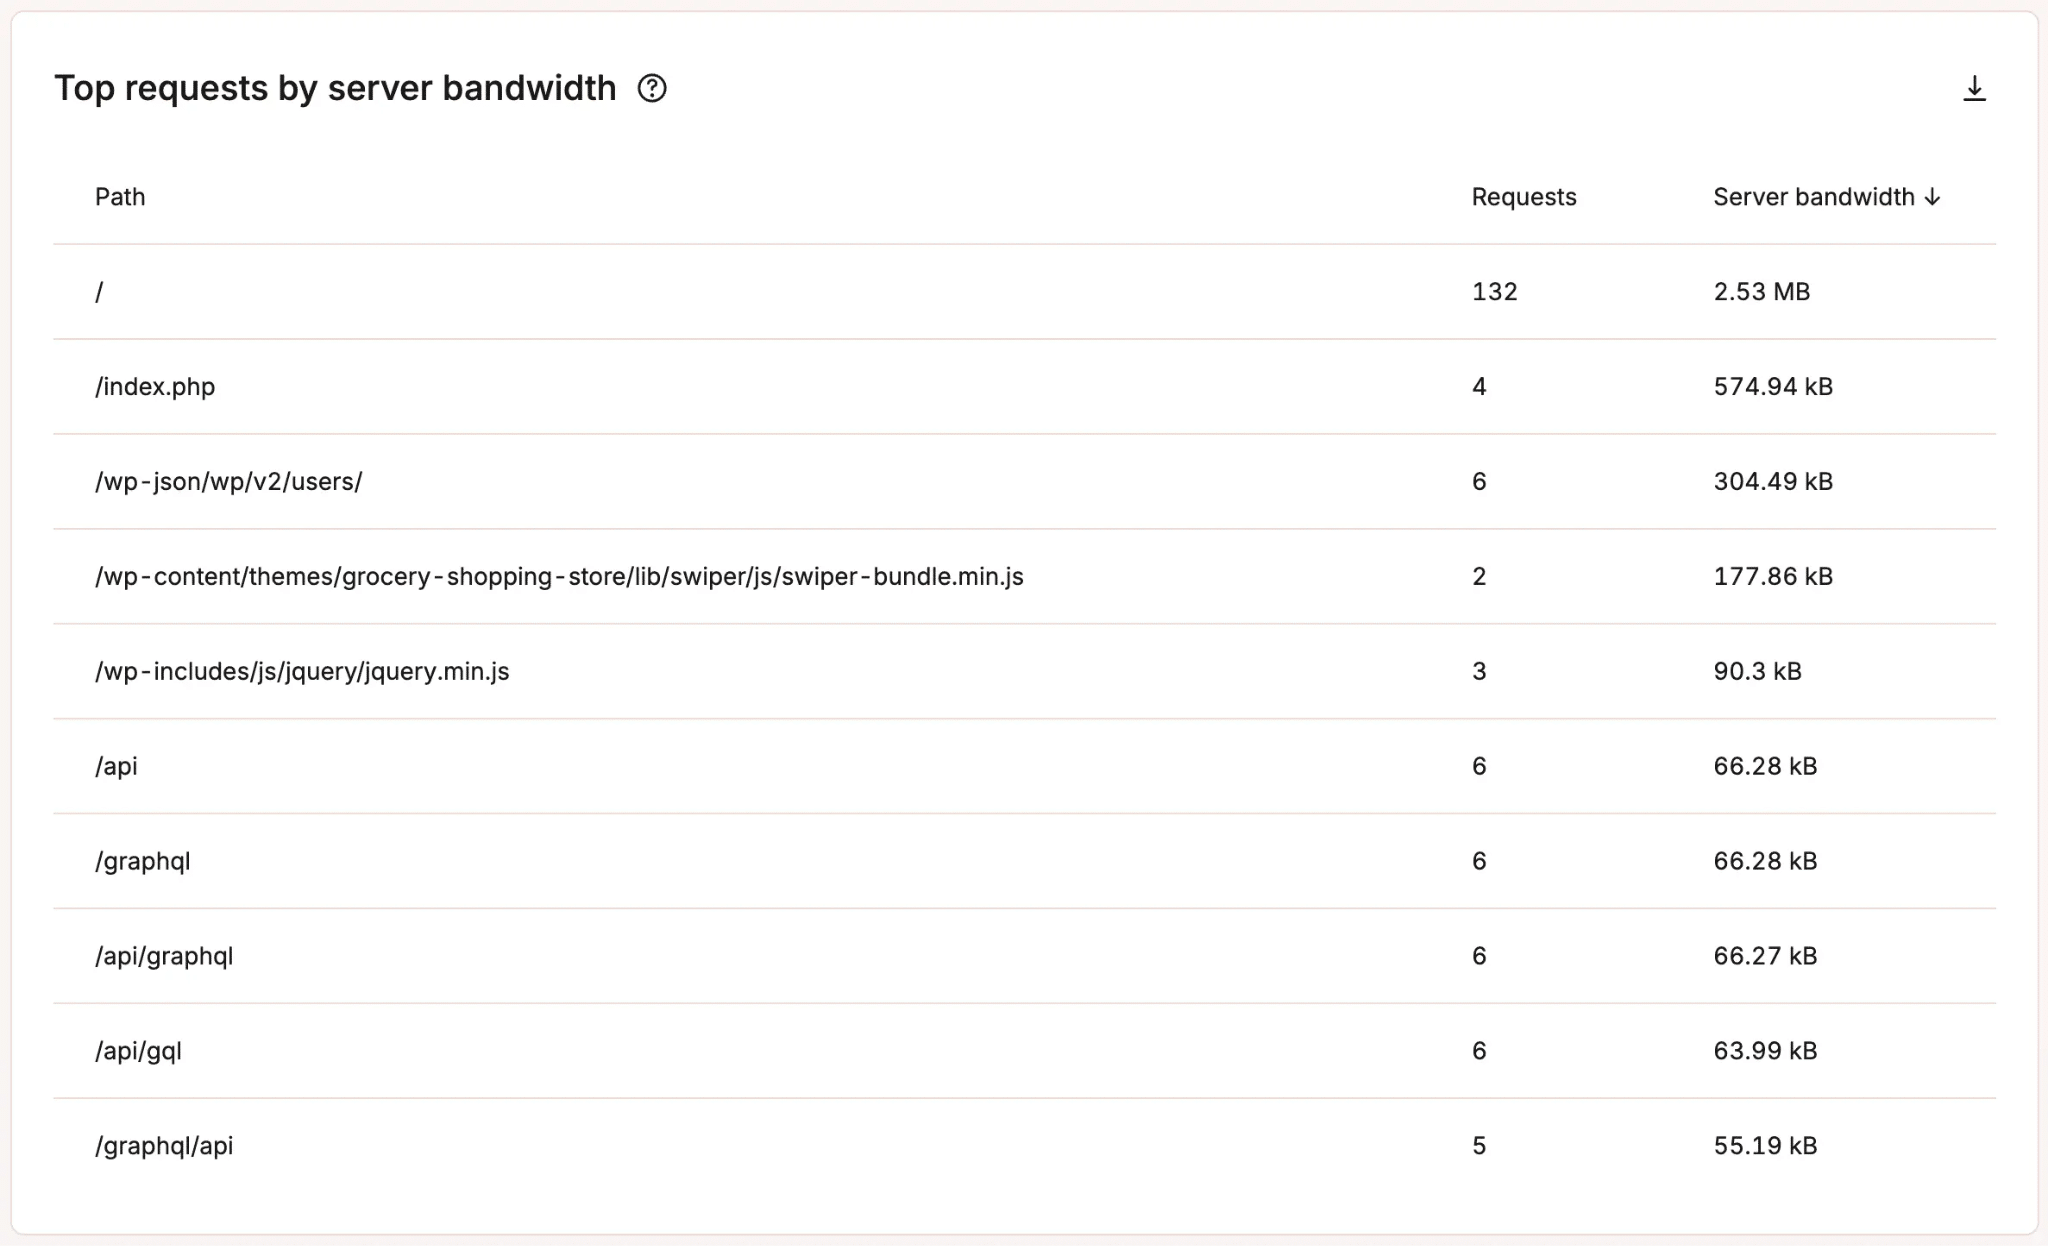
Il est utile de constater la présence d’ GPTBot ou d’un autre robot d’indexation en tête d’un rapport. Le fait de constater que des milliers de ses requêtes sont dirigées vers /blog/ vous indique une chose. Le fait de constater qu’elles sont dirigées vers des résultats de recherche ou une URL WooCommerce paramétrée vous indique autre chose.
Erreur n° 5 : bloquer le robot d’indexation et laisser le piège d’indexation en place
Parfois, le robot n’est que le révélateur d’un problème déjà présent dans votre structure d’URL.
Les sites WordPress peuvent générer un grand nombre d’URL à partir de paramètres de requête, de pages de recherche, d’archives filtrées, de pagination, de calendriers, de variantes de produits et d’actions de commerce électronique.
Une personne peut se rendre compte que deux URL légèrement différentes mènent en substance à la même page, tandis qu’un robot d’indexation ne voit là que davantage de liens à suivre.
Si chaque page génère un nouvel ensemble d’URL qui semblent nouvelles, le robot d’indexation peut continuer à les suivre. C’est ainsi que vous vous retrouvez avec des schémas qui semblent bien plus agressifs que ce qui était initialement prévu.
Nous avons constaté ce phénomène lors de nos précédentes recherches sur l’infrastructure. Un modèle récurrent a pris une ampleur telle qu’une seule règle conçue pour le détecter a filtré 550 millions de requêtes en 30 jours.
Bloquer le robot d’indexation peut mettre fin à la charge immédiate, mais cela ne supprime pas le schéma d’URL qui a permis au robot de découvrir de nouvelles pages.
Lorsqu’un chemin d’accès particulier domine soudainement le trafic des robots d’indexation basés sur l’IA, examinez ce chemin lui-même :
- WordPress génère-t-il un grand nombre de combinaisons de paramètres ?
- Un robot d’indexation peut-il parcourir indéfiniment des URL de calendrier ou de pagination ?
- Les pages de recherche et de filtrage exposent-elles des milliers de variantes d’URL ?
- Les URL d’action, telles que les liens « Ajouter au panier », sont-elles explorables alors qu’elles ne devraient pas l’être ?
- Chaque URL générée doit-elle nécessairement exister et être détectable ?
Vous pouvez toujours décider de bloquer ou de contrer le robot d’indexation, mais commencez par comprendre ce qui l’a poussé à revenir sans cesse.
Ceci est particulièrement important pour les agences. Si plusieurs sites de clients utilisent la même extension, la même configuration WooCommerce, le même thème ou le même modèle d’URL, un robot d’indexation agressif peut mettre en évidence le même problème sur plusieurs sites. Corriger ce comportement peut s’avérer plus utile que de tenir à jour une liste sans cesse croissante de noms de robots.
Erreur n° 6 : supposer que le fichier robots.txt a stoppé le trafic
Une modification du fichier robots.txt peut constituer la bonne réponse lorsque vous souhaitez demander à un robot d’indexation réputé de ne pas accéder à tout ou partie de votre site, mais vous devez tout de même vérifier le trafic par la suite.
Le fichier robots.txt repose sur le fait que le robot d’indexation respecte l’instruction et n’empêche pas physiquement la requête d’atteindre votre site.
Nous avons abordé cette distinction en détail dans notre guide consacré aux robots d’indexation basés sur l’IA. Le fichier robots.txt communique vos préférences d’indexation, tandis que le fichier llms.txt fournit un index de contenu structuré aux outils qui choisissent de le lire. L’application de ces règles se fait ailleurs.
Ceci est important après avoir détecté un problème de performances, car le simple fait de modifier un fichier peut vous donner l’impression que le problème a été résolu.
Vérifiez vos journaux ou vos statistiques relatives aux robots. Si les requêtes provenant du robot d’exploration diminuent après votre modification de robots.txt, vous disposez d’une preuve que cela a fonctionné. Si le trafic persiste, ou si vous êtes confronté à un autre système automatisé qui ne respecte pas les instructions, vous avez besoin d’un mécanisme de contrôle de l’application.
Il en va de même lorsque votre problème concerne le débit de requêtes plutôt que l’accès lui-même. Un robot d’indexation peut être autorisé à lire votre contenu tout en continuant à l’interroger à un débit que votre site ne peut pas gérer sans difficulté.
Erreur n° 7 : copier les règles de pare-feu d’un autre site sans vérifier ce qu’elles bloqueraient
L’exemple de PatronView est utile car la réponse du site s’est appuyée sur ses propres données.
Son audience se trouve en grande majorité en Amérique du Nord ; le propriétaire remet donc en question le trafic provenant d’autres continents. Il a vérifié ses données réelles de fréquentation avant de soumettre à un test les utilisateurs disposant d’anciennes versions de navigateur. Il surveille également le nombre de visiteurs soumis au test qui parviennent effectivement à le réussir. Au cours d’une période donnée, seules 0,24 % des plus de 100 000 vérifications ont été réussies.
Ces chiffres facilitent la justification des règles pour ce site, mais appliquer la même configuration à une boutique en ligne internationale pourrait finir par bloquer des clients légitimes. Le même risque apparait lorsque les équipes cumulent plusieurs outils de sécurité, car chacun d’entre eux semble utile en soi.
Un site WordPress peut disposer d’une protection anti-robots au niveau de l’hébergement, de règles Cloudflare, d’une extension de sécurité, d’une limitation de débit, de blocages par pays et de règles WAF personnalisées, qui prennent tous des décisions concernant la même requête. Le dépannage d’un faux positif devient beaucoup plus difficile lorsque vous ne savez pas quelle couche a pris la décision.
Pour les clients de Kinsta, nous déconseillons formellement de combiner la protection anti-robot de Kinsta avec des couches supplémentaires de protection anti-robot personnalisées. Des classifications contradictoires peuvent entrainer le blocage de visiteurs légitimes ou d’intégrations.
Des niveaux de protection plus élevés peuvent également affecter les automatisations légitimes telles que les API, les outils de surveillance, les webhooks et les intégrations WordPress. MyKinsta inclut donc une option Autoriser les automatisations WordPress courantes ainsi que des exceptions toujours autorisées pour les adresses IP, les chemins d’accès et les agents utilisateurs de confiance.
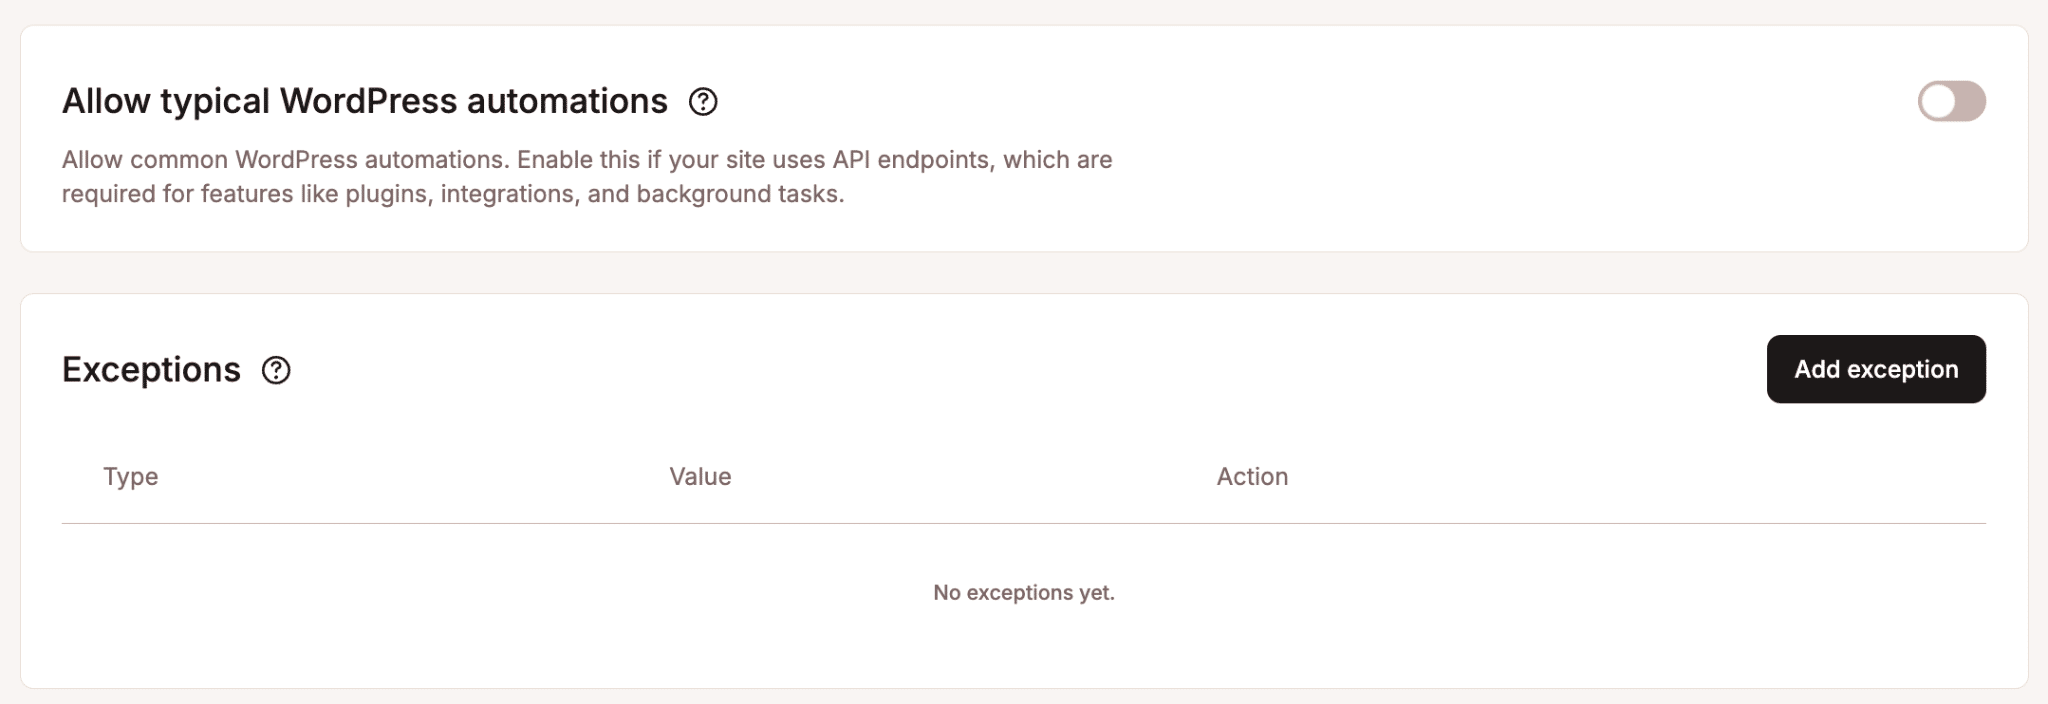
Si vous dirigez une agence, un processus standard s’avère plus utile qu’un ensemble de règles standard. Vous pouvez appliquer le même processus à 20 sites clients en identifiant le trafic, en inspectant ses chemins d’accès, en vérifiant les performances, en choisissant un contrôle, en le testant et en surveillant le résultat.
Que faire lorsque vous détectez du trafic provenant de robots IA ?
Commencez par analyser ce qui se passe sur votre site. Si le trafic de robots affecte les visiteurs réels, protégez d’abord le site, puis examinez le volume de trafic que vous recevez, les chemins qu’il emprunte et les systèmes en cause.
À partir de là, optez pour la modification la plus modeste permettant de résoudre le problème. Cela peut consister à mettre à jour robots.txt, à bloquer ou à interroger un robot d’indexation, à corriger un modèle d’URL indexable, ou à ne rien faire si le trafic ne cause aucun préjudice.
Les clients de Kinsta peuvent effectuer une grande partie de cette analyse directement dans MyKinsta. Les analyses sur le trafic des robots distinguent les robots d’exploration IA, les robots d’exploration IA à fréquence excessive, les robots vérifiés, le trafic automatisé et d’autres types de requêtes, tandis que la rubrique Top trafic affiche les chemins d’accès, les agents utilisateurs, les pays et les adresses IP qui se cachent derrière eux.
Vous pouvez également comparer cette activité avec le comportement du cache, la bande passante du serveur et les performances PHP afin de déterminer si le trafic exerce réellement une pression sur votre site avant de décider quoi bloquer.
Joel est un développeur d'interfaces publiques qui travaille chez Kinsta en tant que rédacteur technique. Il est un enseignant passionné par l'open source et a écrit plus de 200 articles techniques, principalement autour de JavaScript et de ses frameworks.