Toevoegen als voorkeursbron op Google
Bots genereren inmiddels meer webverkeer dan mensen. Interessanter is welk soort bot achter die interacties zit. En het loont om te onderzoeken wat die bots doen zodra ze op je site belanden.
Het standaardgesprek over AI-verkeer draait vooral om crawlers die je content scrapen om een model te trainen. Dat kost je resources. Maar er is ook een tweede categorie: AI-agents die namens iemand je site bezoeken om die te lezen en er acties uit te voeren zoals een klant dat zou doen. Daar zit omzet in. Alleen houdt de huidige technologie zonder aanpassingen beide soorten bots tegen, in plaats van alleen de bots die veel resources verbruiken.
Maak kennis met de bezoeker die leest als een bot en koopt als een klant
Het grootste deel van de internetgeschiedenis kreeg een WordPress site drie soorten bezoekers: mensen, zoekcrawlers en scripts die steeds dezelfde taken uitvoeren.
AI-agents zijn nu een vierde soort. Ze lezen de structuur van een pagina zoals een crawler, maar handelen als een mens. Een AI-agent kan vrij eenvoudig de prijs van een product opzoeken, die vergelijken en afrekenen.
Agentische bots verdienen dus je aandacht. Uit de verkeersdata van Cloudflare blijkt dat geautomatiseerde verzoeken nu voor het eerst talrijker zijn dan menselijke verzoeken. Binnen dat geautomatiseerde aandeel groeit het verkeer van AI-agents en agentische browsers volgens het onderzoek State of AI Traffic van HUMAN Security veel sneller dan elke andere categorie.
Sterker nog: AI-agents zijn al ingebouwd in een aantal populaire producten:
- De ingebouwde feature auto browse van Chrome doet onderzoek, vergelijkt en voert taken met meerdere stappen uit, zoals afrekenen, op de sites die je bezoekt.
- De browseragent van OpenAI, die in de ChatGPT app en de bijbehorende Chrome extensie zit, navigeert door pagina’s en voert taken uit namens een gebruiker.
- De browser Comet van Perplexity leest de geopende tabbladen van een gebruiker om namens die persoon onderzoek te doen en actie te ondernemen. Je downloadt hem gratis.
- Claude for Chrome (de browserextensie van Anthropic) navigeert, klikt en vult formulieren in namens een gebruiker.
Deze en nog veel meer agents komen al als echt verkeer op je site binnen. Alleen zijn de instellingen die trainingscrawlers moeten tegenhouden niet op hen afgestemd.
Verkeer via AI converteert beter dan menselijk verkeer
De retaildata van Adobe over het eerste kwartaal van 2026, gebaseerd op ruim een biljoen bezoeken aan Amerikaanse retailwebsites, laat iets zien wat een jaar geleden nog niemand had kunnen voorspellen.
In maart 2025 converteerde verkeer via AI nog 38% slechter dan standaardkanalen als betaalde zoekadvertenties en e-mail. In maart 2026 converteerde datzelfde verkeer 42% beter. Dat is een omslag van 80 procentpunten in twaalf maanden. Shoppers die via AI binnenkwamen, genereerden ook 37% meer omzet per bezoek dan ander verkeer, bleven 48% langer op de site en bekeken 13% meer pagina’s per bezoek. En alleen al in het eerste kwartaal van 2026 groeide het verkeersvolume uit AI-bronnen met 393% ten opzichte van een jaar eerder.
Dat verschil zit in het gedrag. Iemand die via organische zoekresultaten binnenkomt, kan in elke fase van een aankoopbeslissing zitten. Een agent die naar je site wordt gestuurd, heeft al een concrete taak gekregen.
Juist dit verkeer willen WooCommerce winkels, lidmaatschapsplatforms en sites met offerte- of boekingsformulieren binnenhalen:
- Shoppers die een plugin onderzoeken, laten een agent je prijzen checken en met een aanbeveling terugkomen.
- Iemand die wil weten of je dienst in de eigen regio beschikbaar is, laat een agent je offerteformulier invullen en wacht op antwoord.
- Kopers die abonnementsvormen vergelijken, laten een agent de aanmelding afronden zodra de vergelijking klaar is.
Een agent kan elk van deze taken nu van begin tot eind uitvoeren, als je site dat toelaat.
Cloudflare deelt het blokkeren van AI-bots op in drie categorieën
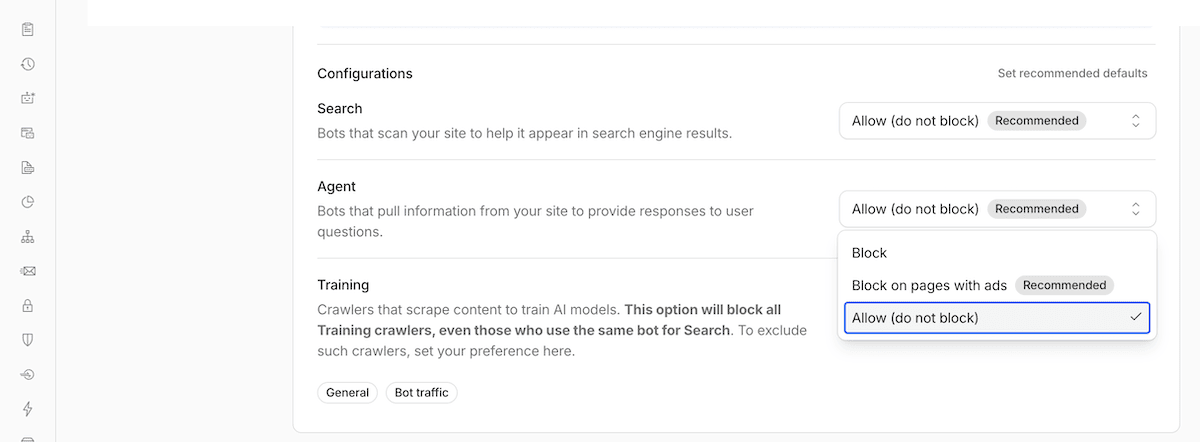
Ook de infrastructuur past zich inmiddels aan. Cloudflare vervangt de vroegere enkele schakelaar voor AI-bots door drie categorieën die je los van elkaar instelt en die voor elke klant beschikbaar zijn.
- Search bevat crawlers die je content indexeren, zodat die later in een door AI gegenereerd antwoord kan verschijnen. Dat levert meestal wat verkeer naar je site op.
- Training bevat crawlers die je content opnemen om een model te bouwen of te verfijnen, zonder dat er verkeer naar je site terugkomt of een transactie volgt.
- Agent bevat realtime verkeer dat een gebruiker aanstuurt en dat namens een specifieke persoon handelt, inclusief sessies die een aankoop afronden.
Cloudflare blokkeert Training en Agent standaard op pagina’s met advertenties, terwijl Search ingeschakeld blijft. Bestaande sites houden hun huidige instellingen, tenzij je die aanpast. Crawlers met meerdere doelen (zoals Googlebot) worden wel getoetst aan de strengste regel. Blokkeer je Training volledig, dan kan dat dus ook ten koste gaan van je zichtbaarheid in zoekmachines.
De Botbescherming van Kinsta maakt dit soort afwegingen al voor je. Die bundelt AI-crawlers op dit moment onder één schakelaar en neemt de driedeling uit het dashboard van Cloudflare niet over. Je moet dus wel weten hoe je werkt met wat je hebt.
Drie dingen die bepalen of een agent je afrekenproces doorloopt
Of een agent zijn taak op je site afmaakt, hangt af van drie factoren. Die liggen allemaal aan de kant van de infrastructuur, niet aan de kant van de content. Bij een groot deel daarvan kunnen de features en infrastructuur van Kinsta je helpen.
Zet prijzen en beschikbaarheid in de HTML
Een agent leest de onderliggende structuur van een pagina, niet de visuele lay-out. Verschijnt de prijs pas na een klik, of laadt je voorraad via een AJAX-call na het renderen? Dan ziet een agent die met de toegankelijkheidsboom werkt die informatie niet.
Daar zitten wel gradaties in. Zo slaagde een AI-agent in een onderzoek naar echte webtaken in bijna 80% van de gevallen. Bij interactie met alleen het toetsenbord (wat nabootst hoe iemand met een schermlezer navigeert) zakte het slagingspercentage naar 42%.
De gebruikelijke boosdoeners zijn voorspelbaar als je weet waar je op moet letten:
- FAQ’s in accordeonvorm verbergen antwoorden achter een klik die een agent misschien nooit doet.
- Prijstabellen met tabbladen zetten vaak maar één tabblad in de initiële markup van de pagina.
- Voorraadindicatoren die via JavaScript laden, bestaan misschien nog niet op het moment dat een agent de pagina leest.
De door Google voorgestelde standaard WebMCP is een poging om dit op browserniveau op te lossen. Een site kan daarmee zijn afreken- en prijsfuncties direct beschikbaar stellen, zodat een agent die niet zelf uit de pagina hoeft af te leiden. Het gaat nog wel om een vroege proef, dus semantische HTML is voorlopig de betrouwbare oplossing.
Zorg dat je pagina reageert voordat de agent een time-out krijgt
Een agent die een taak met meerdere stappen uitvoert, wacht een trage pagina niet af zoals een mens dat misschien doet. Hij verlaat een pagina die blijft hangen simpelweg, en dat kost je een conversie.
De drempelwaarden van Core Web Vitals zijn een redelijke graadmeter voor wat een agent accepteert, ook al zijn ze gebaseerd op hoe een mens een pagina ervaart. Met een Largest Contentful Paint onder de 2,5 seconden hebben zowel mensen als agents genoeg ruimte om een taak binnen dezelfde sessie af te ronden.
Ga je gissen naar oplossingen voor trage pagina’s, dan verspil je precies de tijd die je wilt besparen. Met de APM-tool van Kinsta analyseer je een afreken- of productpagina en breng je de vertraging terug tot de plugin, databasequery of externe call die ervoor verantwoordelijk is.
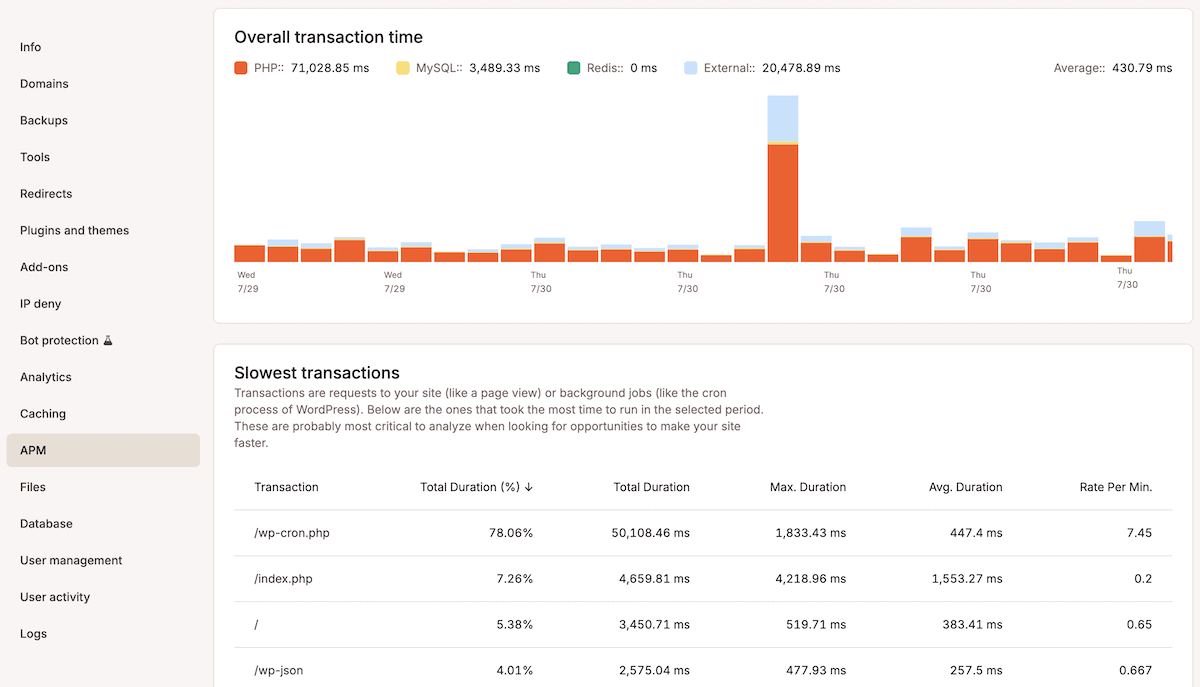
Zodra de monitoring loopt, zie je in het overzicht Transacties welke pagina of welk endpoint traag is. Daarna zoek je uit welke plugin of query erachter zit en pak je het juiste onderdeel aan. Zo bespaar je tijd, en blijven agents om de juiste redenen op je site.
Stel Botbescherming zo in dat converterende sessies doorkomen
Behandelen je instellingen voor botbescherming elke geautomatiseerde bezoeker als een trainingscrawler, dan komen de juiste bots misschien niet eens op je site. Een systeem dat deze botsessies niet uit elkaar kan houden, ziet ze allemaal als hetzelfde.
Daarom geeft de Botbescherming van Kinsta je vier aparte instellingen om die keuze te maken:
- Vier beschermingsniveaus, van Blokkeer kwaadaardig verkeer tot Iedereen controleren, bepalen hoe streng niet-geclassificeerd en vermoedelijk botverkeer op je hele site een challenge krijgt.
- Met de aparte schakelaar AI-crawlers blokkeren houd je AI-crawlerverkeer in één keer tegen, inclusief afrekenende sessies uit de categorie Agent en trainingscrawlers.
- Met Typische WordPress-automatiseringen toestaan blijven je REST API, integraties met plugins en achtergrondtaken werken, ook bij een strenger beschermingsniveau. Dat is belangrijk voor agentsessies die je afrekenpagina en API-endpoints aanroepen.
- Met Uitzonderingen altijd toestaan (op basis van IP-adres, pad of user agent) wijs je specifiek verkeer aan dat nooit geblokkeerd mag worden of een challenge mag krijgen, ongeacht je beschermingsniveau.
Voor een WooCommerce winkel of boekingssite is het een praktische middenweg om Typische WordPress-automatiseringen toestaan in te schakelen. Zo houdt een strenger beschermingsniveau het verkeer naar je checkout en REST API niet tegen. Het is ook verstandig om AI-crawlers blokkeren te zien als tijdelijke diagnosetool, niet als instelling die je permanent aan laat staan.
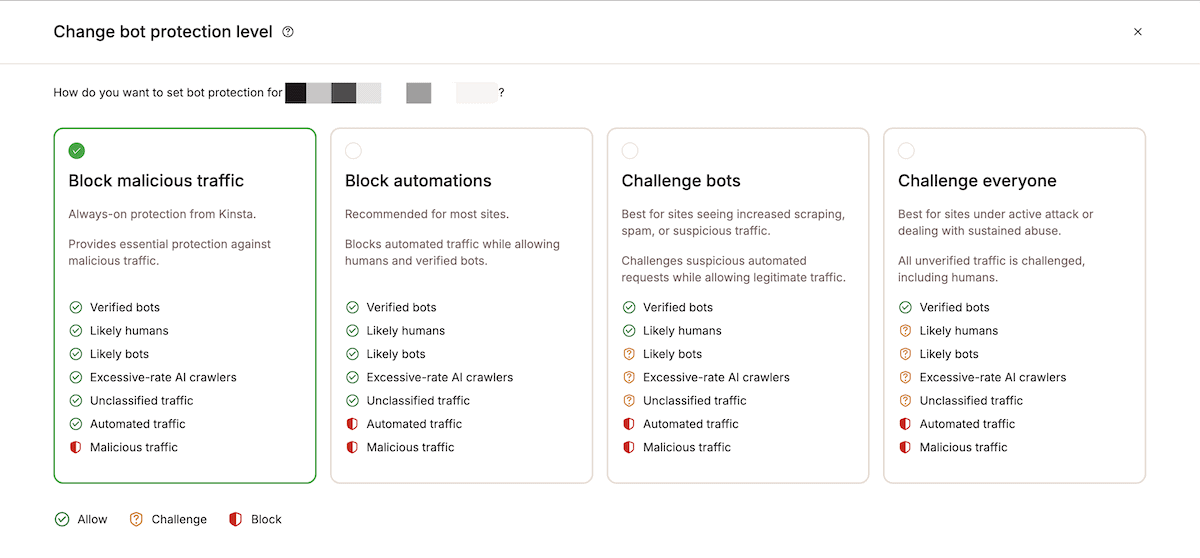
Wil je specifiek trainingscrawlers tegenhouden zonder aankopen via agents mis te lopen? Dan werk je preciezer met Uitzonderingen altijd toestaan voor de user agents van bekende agents dan met de schakelaar alleen.
Kijk in MyKinsta wat er op je eigen site gebeurt
Controleer voordat je instellingen aanpast eerst hoe het verkeer op je site eruitziet. Ga er niet van uit dat je agentsessies al goed afhandelt. MyKinsta heeft daar een paar plekken voor.
Allereerst krijg je op de pagina Sites > [sitenaam] > Botbescherming twee soorten inzichten in één grafiek. Het overzicht Breakdown verzoeken toont alle verzoeken aan je site van de afgelopen 24 uur, ingedeeld in verschillende categorieën. Zo zie je hoe je verkeer is verdeeld.
De grafiek met de resultaten van de botbescherming laat zien hoe dit verkeer is afgehandeld: toegestaan, via een challenge of geblokkeerd:
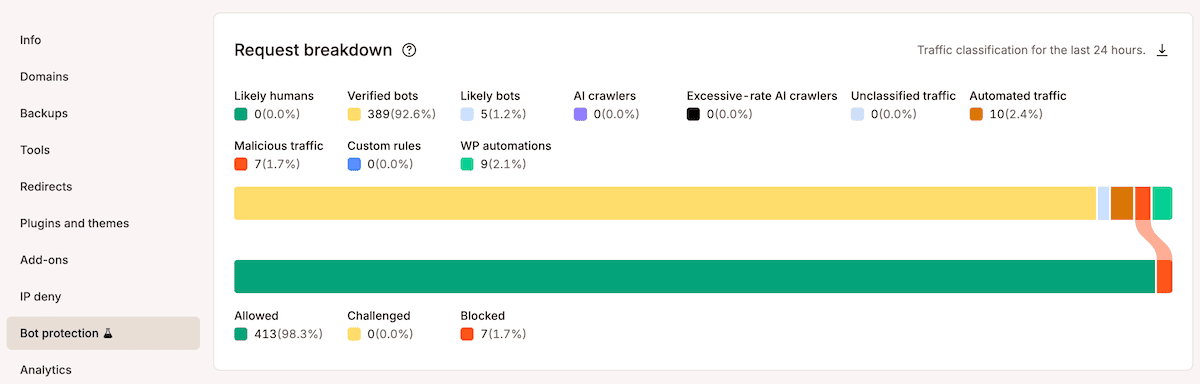
De Breakdown verzoeken legt de twee overzichten in feite naast elkaar. Krijgt een deel van je geautomatiseerde verkeer een challenge of wordt het geblokkeerd, dan zie je dat bijvoorbeeld samenvallen met de categorie AI-crawlers. Je ziet alleen niet of het om trainingscrawlers gaat of om agentsessies die converteren.
Kijk daarom wanneer een piek in geblokkeerd verkeer optreedt en vergelijk dat met je aantal bestellingen of leads in dezelfde periode. Daalt het ene terwijl het andere stijgt, dan worden er waarschijnlijk legitieme agentsessies tegengehouden.
Test je afrekenproces zonder JavaScript
Een agent die met de onderliggende structuur van een pagina werkt, ervaart die pagina ongeveer zoals iemand met een schermlezer. Met twee snelle tests zie je waar de flow hapert.
Open eerst de DevTools in je browser en ga naar Settings > Debugger. Vink daar Disable JavaScript aan. Laad de pagina daarna opnieuw en probeer een product toe te voegen of naar de afrekenpagina te gaan.
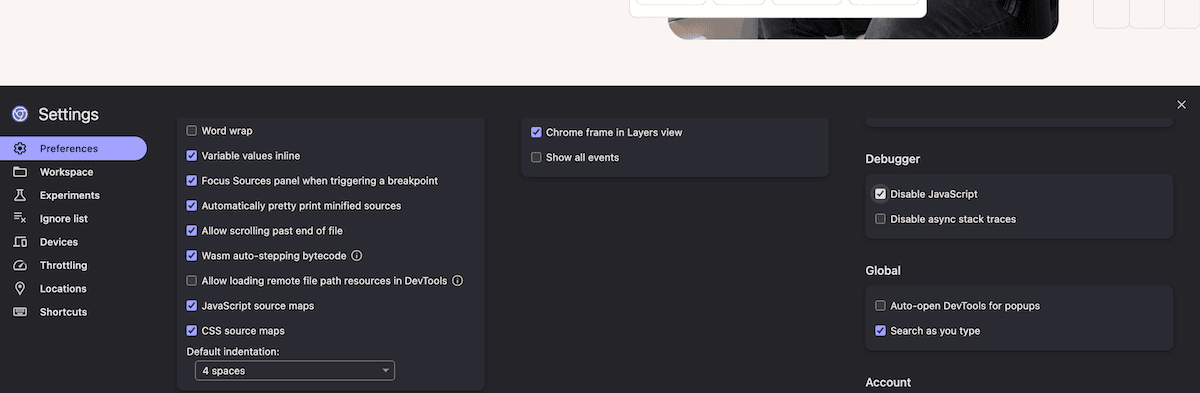
Gaat er iets mis of zie je foutmeldingen, dan hangt die stap af van een script dat misschien nooit wordt uitgevoerd. Een knop om iets aan je winkelwagen toe te voegen die als klikbare <div> is gebouwd, heeft zonder dat script bijvoorbeeld vaak geen fallback.
Je kunt ook een toegankelijkheidsscanner zoals axe of WAVE op hetzelfde afrekenproces uitvoeren. Elk ontbrekend label, verborgen veld of onbereikbare knop die je daarmee vindt, is ook voor een agent onzichtbaar. Met die twee tests samen heb je een concrete lijst met elementen om aan te pakken.
Houd de responstijden in de gaten bij gelijktijdige belasting
Een agentsessie die snel achter elkaar meerdere tabbladen opent of verschillende productpagina’s bekijkt, lijkt eerder op een korte piek in gelijktijdig verkeer. Veel prestatiechecks pikken dat belastingspatroon niet op, waardoor een test met één verzoek zonder problemen slaagt.
Kijk in Analytics in MyKinsta (Sites > sitenaam > Analytics > Prestaties) naar de gemiddelde responstijd van PHP + MySQL. Met die grafiek (en de gedetailleerde lijst onderaan de pagina) kun je de traagste paden op je site vinden, in plaats van alleen een sitebreed gemiddelde te zien dat het probleem verbergt.
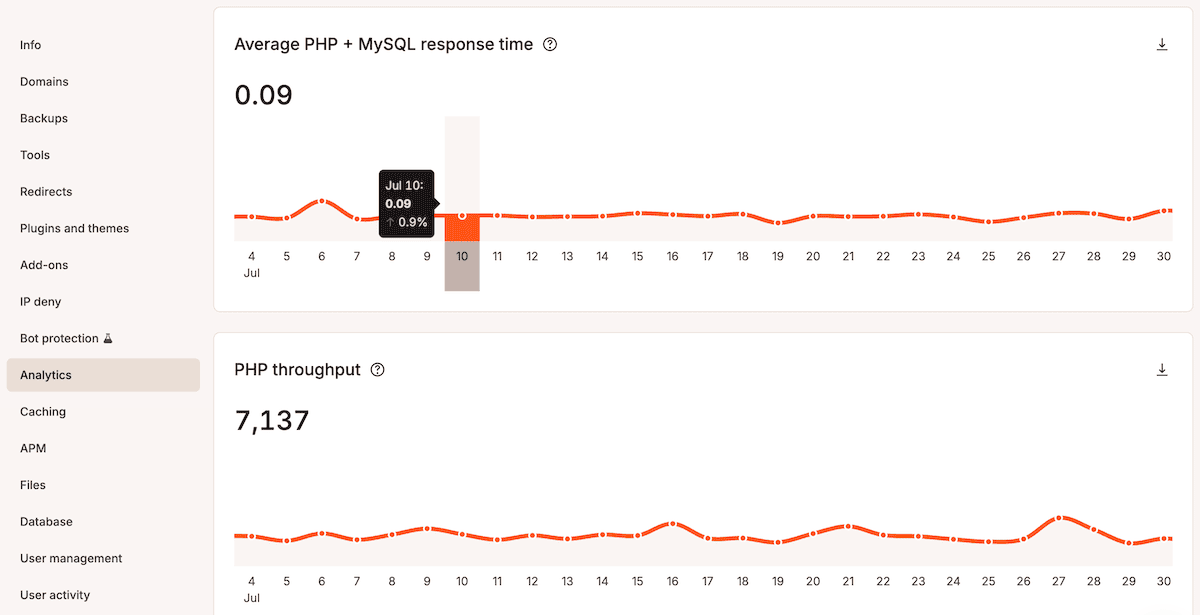
Start daarna de APM-tool en open meerdere sessies tegelijk naar de endpoints van je winkelwagen en zoekfunctie. Zo zie je waar de responstijd begint op te lopen.
Laat de grafiek met de threadlimiet van PHP in de sectie Prestaties van Analytics zien dat je site tegen zijn plafond aanloopt? Dat kun je oplossen. Verhoog je threadtoewijzing onder Sites > [sitenaam] > Info > PHP-prestaties > Wijzigen. Zo geef je je site eenvoudig meer ruimte om meerdere agentsessies tegelijk af te handelen.
Agentverkeer is tegenwoordig een volwaardig kanaal
Voor trainingscrawlers blijft blokkeren en de resources terugwinnen de juiste aanpak. Voor AI-agents die afrekenen niet. Zet daarom alle tools in die je hebt om bots goed te filteren.
De oplossing is om te controleren of je prijs- en voorraaddata in de initiële HTML van de pagina staat. Spoor daarna je traagste pagina’s op en loop je instellingen voor botbescherming na. Zo handel je bestaand verkeer nauwkeurig af en gebruik je je serverresources efficiënt.
Wil je zien hoe Botbescherming, APM en de Cloudflare integratie van Kinsta samenwerken om je infrastructuur klaar te houden voor beide soorten bezoekers? Bekijk dan de Managed WordPress Hosting van Kinsta.