Toevoegen als voorkeursbron op Google
Ontdek je dat een groot deel van het verkeer op je website van bots komt, dan lijkt blokkeren misschien de logische volgende stap. Niet zo gek, soms vragen de cijfers inderdaad ook echt om direct ingrijpen.
PatronView kreeg onlangs op één dag 3,6 miljoen verzoeken op zijn site binnen, afkomstig van meer dan 360.000 IP-adressen. De eigenaar stelde uiteindelijk een behoorlijk strenge set Cloudflare regels op om het verkeer weer onder controle te krijgen.
Ook op onze eigen infrastructuur zien we geregeld extreme gevallen. In ons rapport over AI- en botverkeer stuurde één crawler in 24 uur 3,75 miljoen verzoeken naar ‘toevoegen aan winkelwagen’-URL’s. Een ander, herhalend loop-patroon was goed voor honderden miljoenen verzoeken, tot we een regel invoerden om het af te vangen.
Deze gevallen mogen echt zijn, maar ze gelden niet voor elke website.
In onze nieuwste analyse van meer dan 5.000 WordPress sites waren AI-bots bij de mediane site goed voor slechts 1,57% van de bandbreedte. Bij de 10% sites met het meeste AI-verkeer was dat minstens 17,8%, bij de top 1% zelfs minstens 90,3%. Meer dan 1.000 sites verbruikten helemaal geen bandbreedte aan AI-bots.
Die spreiding laat zien dat AI-botverkeer op je site nog niet meteen betekent dat je ook daadwerkelijk een AI-botprobleem hebt.
Wat je besluit zodra je AI-botverkeer ontdekt, kan gevolgen hebben voor de prestaties van je site, je integraties, je vindbaarheid in zoekmachines en de vraag of AI-tools je content kunnen tonen. Wil je iets veranderen, zoek dan eerst uit wat die bots eigenlijk doen.
Dit zijn een paar fouten die we site-eigenaren zien maken als ze die stap overslaan.
Fout 1: het percentage als diagnose zien
Nemen AI-crawlers 20% van de verzoeken op je site voor hun rekening, dan zegt dat cijfer op zichzelf nog niets over of er een probleem is.
Een groot aantal verzoeken naar gecachete artikelen legt misschien relatief weinig druk op de applicatie. Een kleiner aantal verzoeken dat steeds zoekresultaten, gefilterde productpagina’s of winkelwagen-URL’s opvraagt, kan juist veel meer werk opleveren.
Dat is een van de redenen waarom je netwerkbrede botstatistieken voorzichtig moet toepassen op een individuele site.
Uit ons nieuwste onderzoek bleek dat het gemiddelde aantal AI-botverzoeken per site over vier metingen varieerde van 667 tot 928 per dag. De mediaan lag op slechts 33 tot 67 verzoeken, en ongeveer 20% tot 27% van de sites kreeg op een gemeten dag helemaal geen AI-botverzoeken.
Met andere woorden: een kleine groep intensief gecrawlde sites trekt het gemiddelde omhoog.
Lees je dus dat bots meer dan de helft van het webverkeer uitmaken, of zie je een andere site-eigenaar 99% botverkeer melden? Gebruik dat getal dan niet om te bepalen wat jouw site nodig heeft.
Begin bij je eigen verkeer.
Als Kinsta klant zie je op de pagina Botbescherming in MyKinsta hoe verzoeken zijn ingedeeld: waarschijnlijk mensen, geverifieerde bots, waarschijnlijk bots, AI-crawlers, agressieve AI-crawlers, geautomatiseerd verkeer en kwaadaardig verkeer.
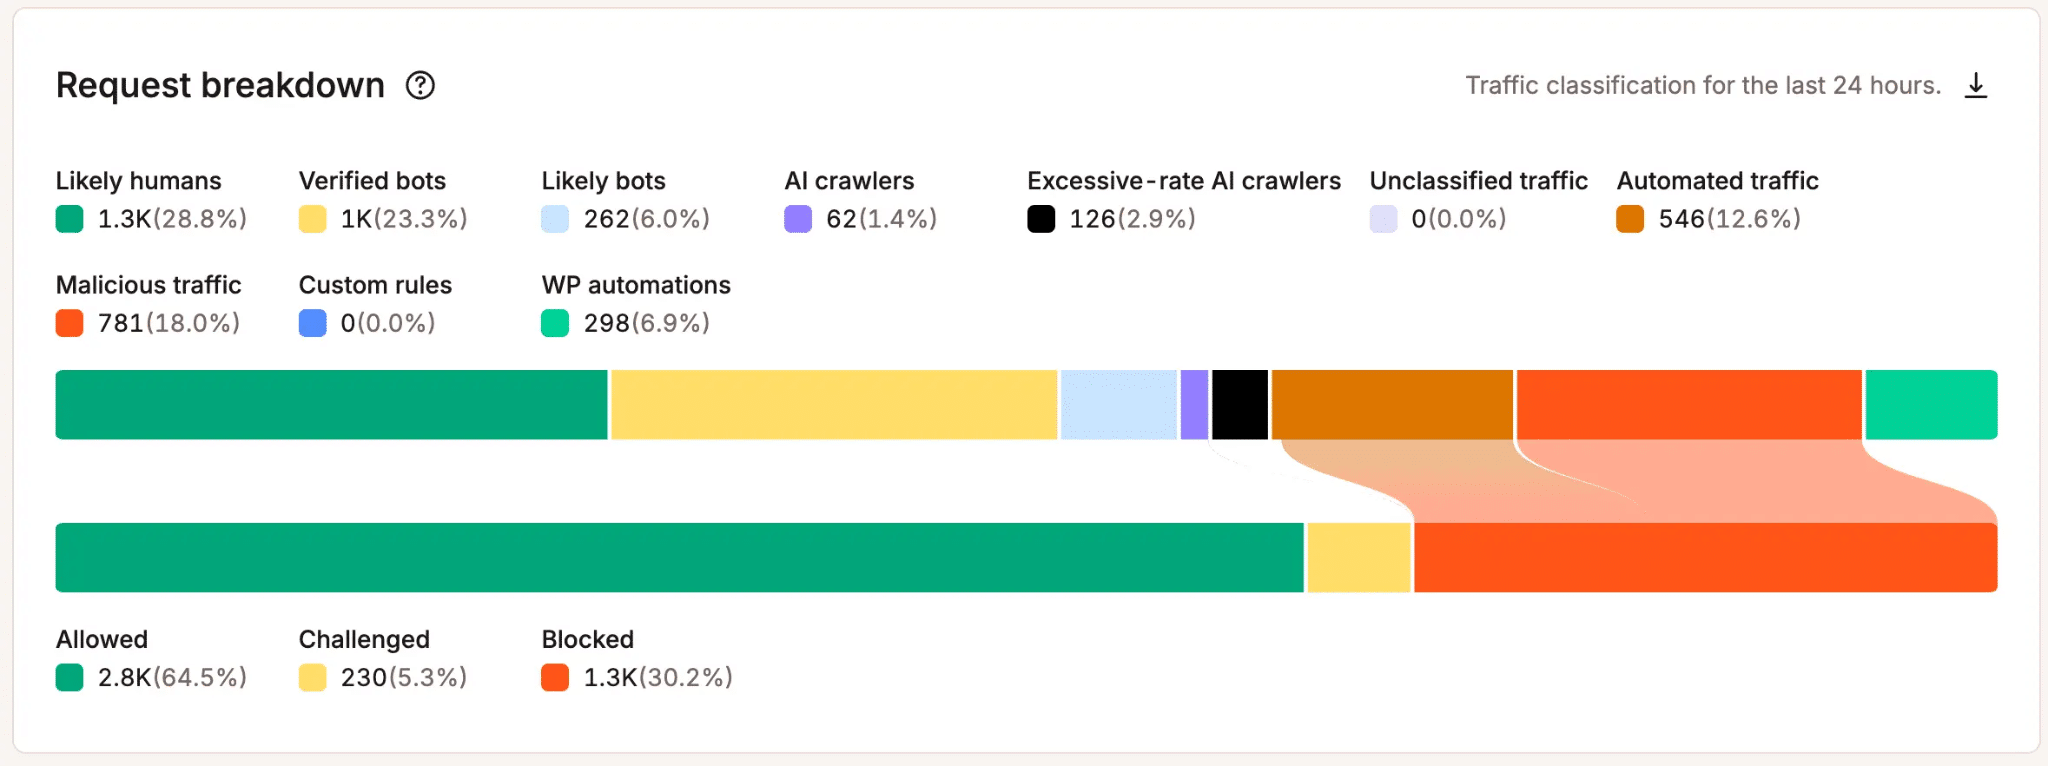
Met Top verkeer bekijk je vervolgens de paden, user agents, landen en IP-adressen achter een bepaald verkeerstype.
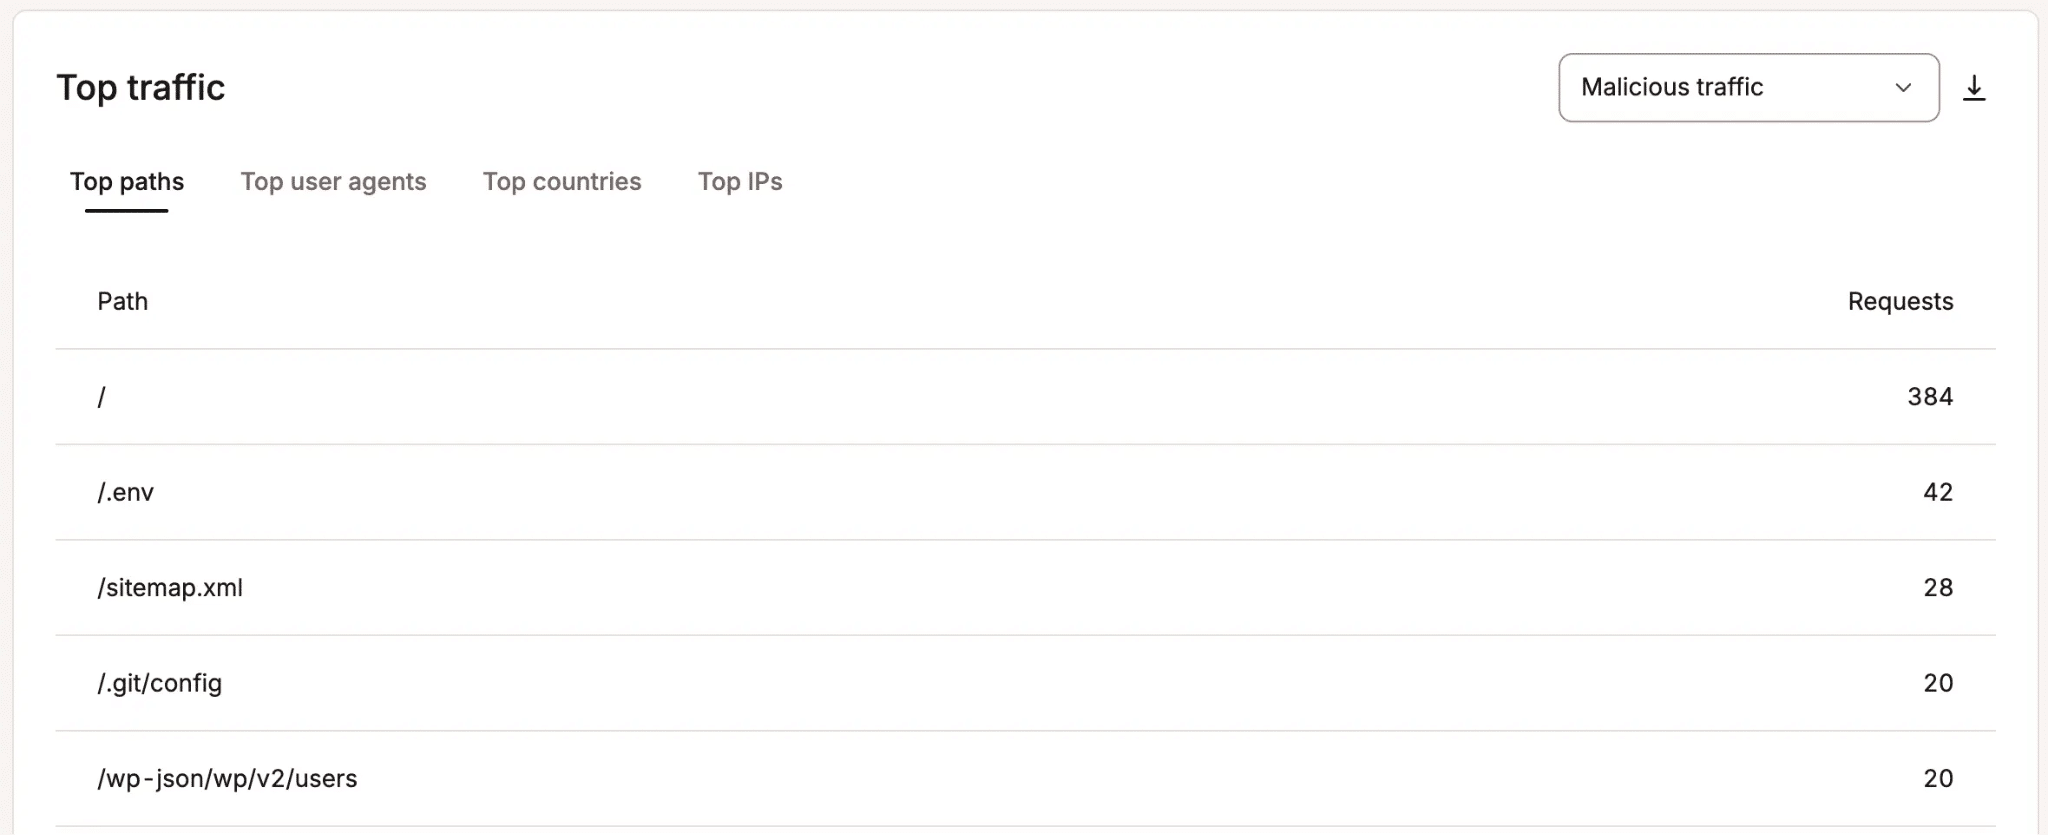
Voordat je actie onderneemt, moet je een paar basisvragen kunnen beantwoorden:
- Hoeveel AI-verkeer komt er echt binnen op de site?
- Welke pagina’s of endpoints vraagt het op?
- Welke crawlers, agents of andere geautomatiseerde systemen zitten erachter?
- Heeft dat verkeer invloed op de prestaties, bandbreedte, PHP threads of de ervaring van echte bezoekers?
Ons nieuwste rapport benadert dit via de positie, het patroon en het profiel van het verkeer. Een site die weinig AI-verkeer met normaal verzoekgedrag krijgt, hoeft misschien niets te doen. Een site met aanhoudend crawlerverkeer naar dure dynamische URL’s verdient een veel nauwkeurigere analyse.
Fout 2: elke bot blokkeren omdat het om geautomatiseerd verkeer gaat
De term ‘AI-bot’ dekt tegenwoordig verschillende soorten verkeer. Sommige crawlers verzamelen openbare content voor modeltraining of AI-zoekfuncties. Andere halen pagina’s op omdat een gebruiker daarom vraagt.
Die verschillen doen ertoe als je bepaalt wat je toestaat. OpenAI gebruikt bijvoorbeeld GPTBot voor content die kan worden ingezet om zijn modellen te verbeteren, terwijl OAI-SearchBot helpt websites vindbaar te maken in de zoekfunctie van ChatGPT. Blokkeer je OAI-SearchBot, dan kan dat dus invloed hebben op of je content in de zoekresultaten van ChatGPT verschijnt.
Anthropic maakt een vergelijkbaar onderscheid. ClaudeBot verzamelt webcontent die kan bijdragen aan modeltraining, Claude-SearchBot wordt gebruikt voor zoekopdrachten en Claude-User kan een website ophalen als iemand daar in Claude om vraagt.
Volgens Perplexity gebruikt het PerplexityBot voor de zoekindex en Perplexity-User voor verzoeken die voortkomen uit een vraag van een gebruiker.
Google biedt uitgevers een aparte instelling, Google-Extended, waarmee je kunt bepalen hoe gecrawlde content voor Gemini mag worden gebruikt. Google geeft expliciet aan dat wijzigingen in die instelling geen invloed hebben op opname of ranking in Google Search.
Schaar je al deze systemen onder één noemer ‘AI’, dan gaat er bruikbare informatie verloren.
Wil je liever geen resources van je site besteden aan modeltraining, dan kun je trainingscrawlers beperken en zoek- en ophaalsystemen wel toegankelijk houden. Is je probleem dat een AI-agent steeds een dynamisch endpoint aanroept, dan lost een ander beleid voor trainingscrawlers dat misschien niet op.
Er speelt ook een zakelijke afweging mee. In ons consumentenonderzoek gaf 44,7% van de respondenten aan dat ze altijd of meestal de website van een bedrijf bezoeken nadat ze een AI-aanbeveling kregen. Dat betekent niet dat toegang voor AI-crawlers automatisch verwijzingsverkeer oplevert. Wel is het de moeite waard om vindbaarheid via AI mee te wegen voordat je een algemene beslissing neemt over zichtbaarheid.
Bij Kinsta houd je met de instelling Blokkeer AI crawlers AI-crawlers tegen, ook geverifieerde. Traditionele zoekmachinecrawlers zoals Googlebot en Bing blijven toegang houden.
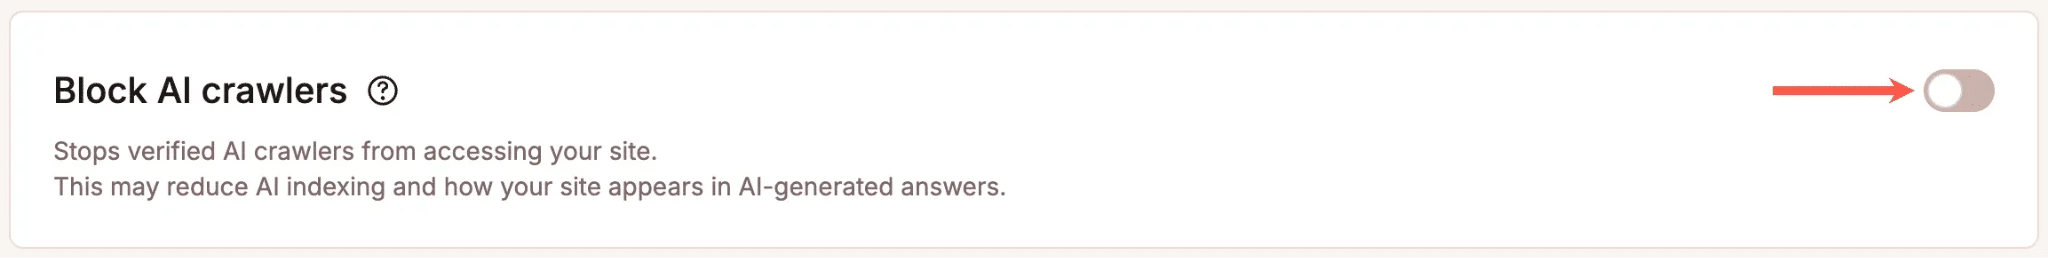
We wijzen klanten er wel op dat je door AI-crawlers te blokkeren minder zichtbaar kunt worden in AI-gestuurde zoekresultaten, samenvattingen of aanbevelingen.
Fout 3: elke AI-crawlerpiek als beveiligingscrisis behandelen
Bots kunnen beveiligingsproblemen veroorzaken via brute-force-pogingen, DDoS-aanvallen, aanvallen op inloggegevens en ander misbruik via automatisering. Een geverifieerde AI-crawler die te veel legitieme verzoeken stuurt, is een heel ander soort probleem.
Tijdens ons webinar over botverkeer legde Daniel Pataki, CTO van Kinsta, uit waarom hij zich zorgen maakt over hoe site-eigenaren reageren als die twee door elkaar lopen:
‘Ik ben in dit geval banger voor een overreactie dan voor een te zwakke reactie, want het is geen beveiligingsprobleem.’
Hij had het over het bredere probleem van AI-crawlers. Veel van het lastige verkeer dat we zien, komt van legitieme systemen die inefficiënt crawlen, niet van een aanvaller die de site probeert binnen te dringen.
Zit de site al in de problemen, dan verandert de aanpak. Leggen bots beslag op serverresources, vertragen ze pagina’s of houden ze echte klanten tegen, dan gaat het stabiliseren van de site voor alles. Daniel raadde aan om botverkeer dat een acuut probleem veroorzaakt tijdelijk te blokkeren, en pas te onderzoeken wat er speelt zodra de site weer onder controle is.
De fout is om van die noodmaatregel een permanent beleid te maken zonder uit te zoeken wat er precies is gebeurd.
De Botbescherming van Kinsta geeft je verschillende niveaus van controle, van basisbescherming tegen kwaadaardig verkeer tot automatiseringen blokkeren of vermoedelijke bots een challenge geven als je strengere bescherming nodig hebt. Agressieve AI-crawlers kunnen op de juiste beschermingsniveaus ook een challenge krijgen.
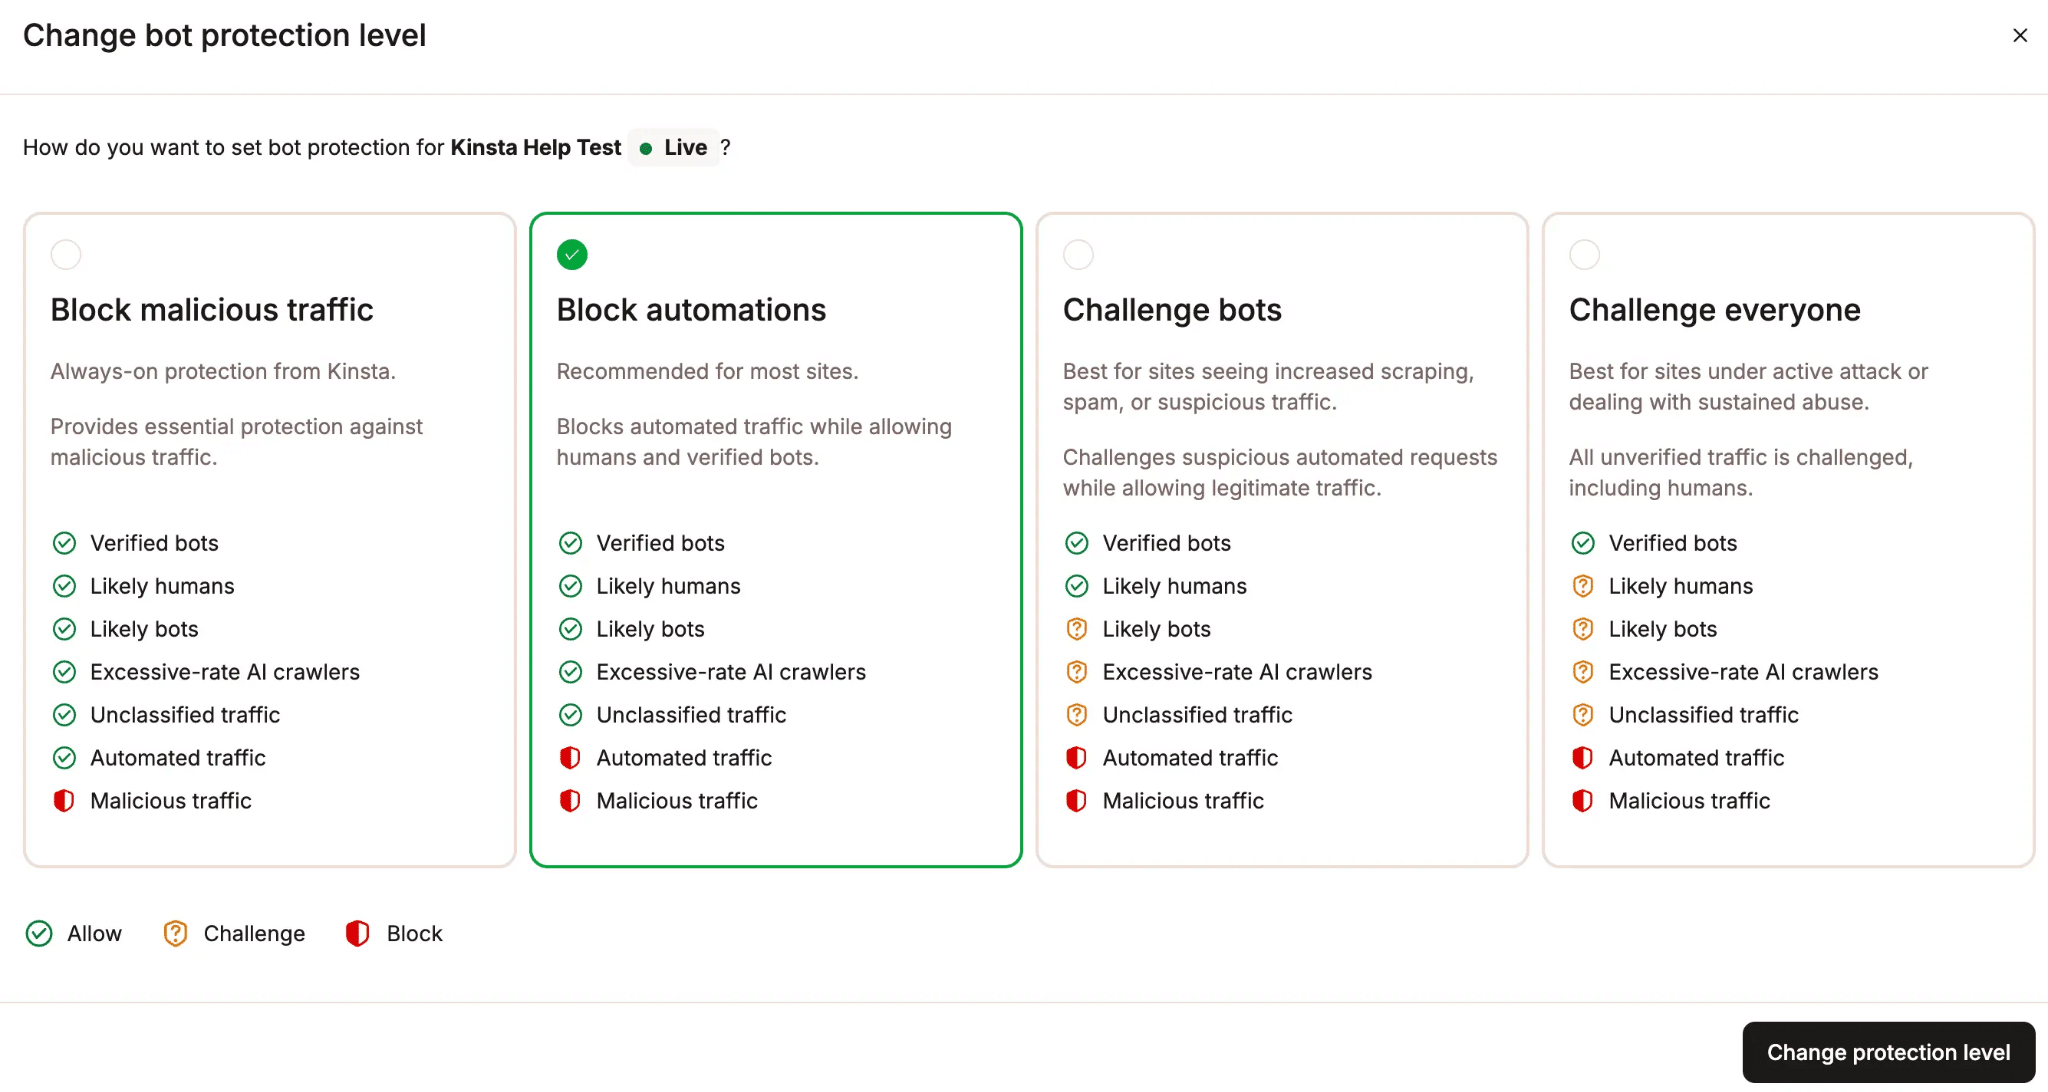
Bij een plotseling prestatieprobleem kunnen strengere maatregelen op dat moment gerechtvaardigd zijn. Is het incident voorbij, kijk dan wat er op de site afkwam en of die strengere maatregelen nog steeds zinvol zijn.
Fout 4: verzoeken tellen zonder te kijken waar ze naartoe gaan
Onze infrastructuurdata maken dit verschil goed zichtbaar. Een verzoek voor een gecachet blogartikel en een verzoek voor een niet-gecachete WooCommerce zoekpagina tellen allebei als één verzoek, terwijl het tweede véél meer serverwerk kan kosten.
Hier zie je een illustratie uit het webinar ‘Reality Check: Botverkeer’:
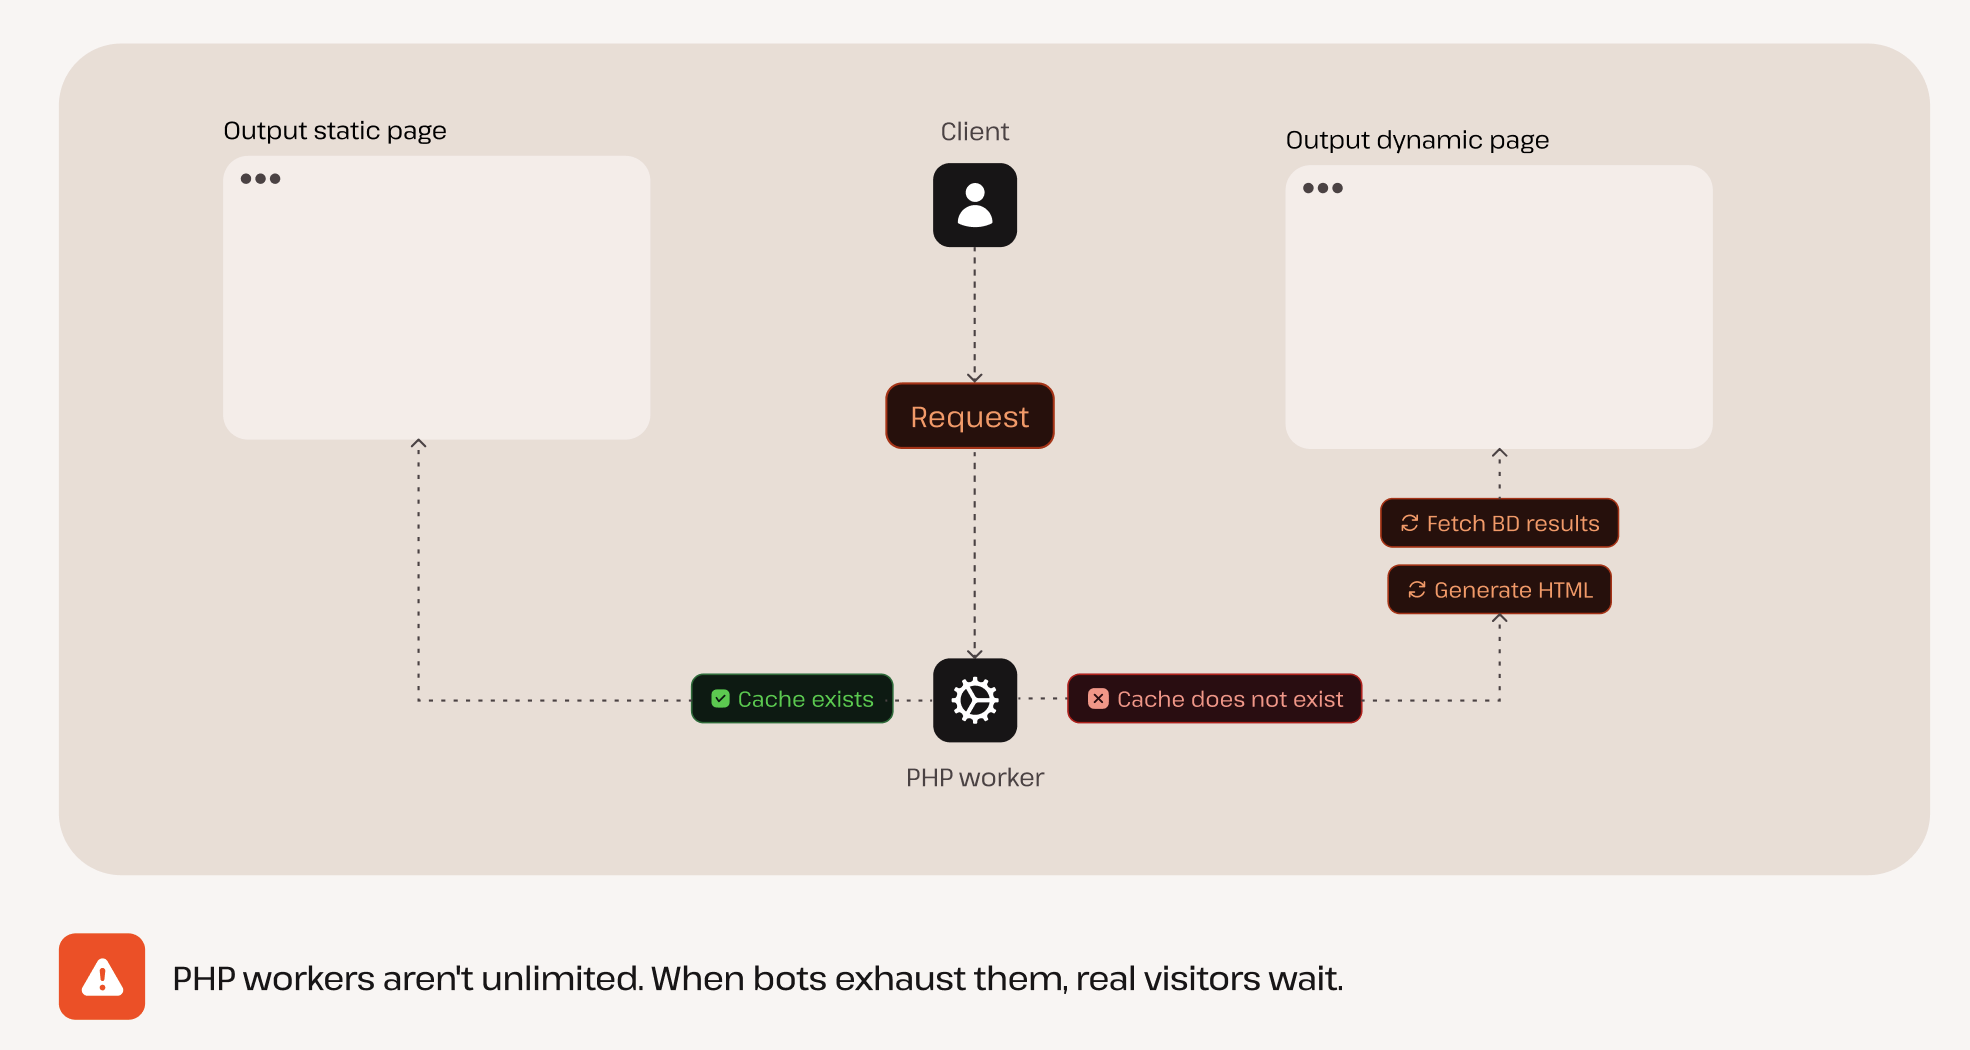
Is er een gecachete pagina beschikbaar, dan kan WordPress een groot deel van het verzoek afhandelen zonder de pagina opnieuw te genereren.
Een dynamisch verzoek vraagt mogelijk om een PHP thread (ook wel ‘worker’ genoemd), databasequery’s, het genereren van de pagina en soms sessiebeheer voordat WordPress iets kan terugsturen. Acties rond de winkelwagen en het afrekenen kunnen nog meer werk opleveren.
Herhaal dat nu duizenden keren.
Uit drie metingen in ons nieuwste onderzoek bleek dat 76,9% tot 90,5% van de AI-crawlerverzoeken naar dynamische content ging. Bij menselijke verzoeken lag dat tussen 18,3% en 18,9%.
Dat verschil zegt veel meer over mogelijke druk op de infrastructuur dan het ruwe aantal verzoeken.
Denk aan het ‘toevoegen aan winkelwagen’-incident dat we in ons onderzoek naar AI-botverkeer tegenkwamen. Eén crawler genereerde 3,75 miljoen verzoeken in 24 uur, ongeveer één per 23 milliseconden. Elk verzoek kon WordPress aan het werk zetten voor een ‘bezoeker’ die nooit iets zou kopen.
Daarom kunnen twee sites met hetzelfde percentage AI-verkeer zich ook heel verschillend gedragen.
Een contentsite waar crawlers vooral gecachete artikelen opvragen, kan een groot volume zonder veel problemen aan. Bij een WooCommerce winkel is de impact veel sneller merkbaar als zelfs een kleiner aantal verzoeken steeds zoekopdrachten, filters, winkelwagenacties, accountpagina’s of andere niet-gecachete routes opvraagt.
Zie je een piek, kijk dan niet alleen naar de user agent.
In MyKinsta kun je Top verkeer filteren op AI crawlers en bekijken welke paden ze het vaakst opvragen.
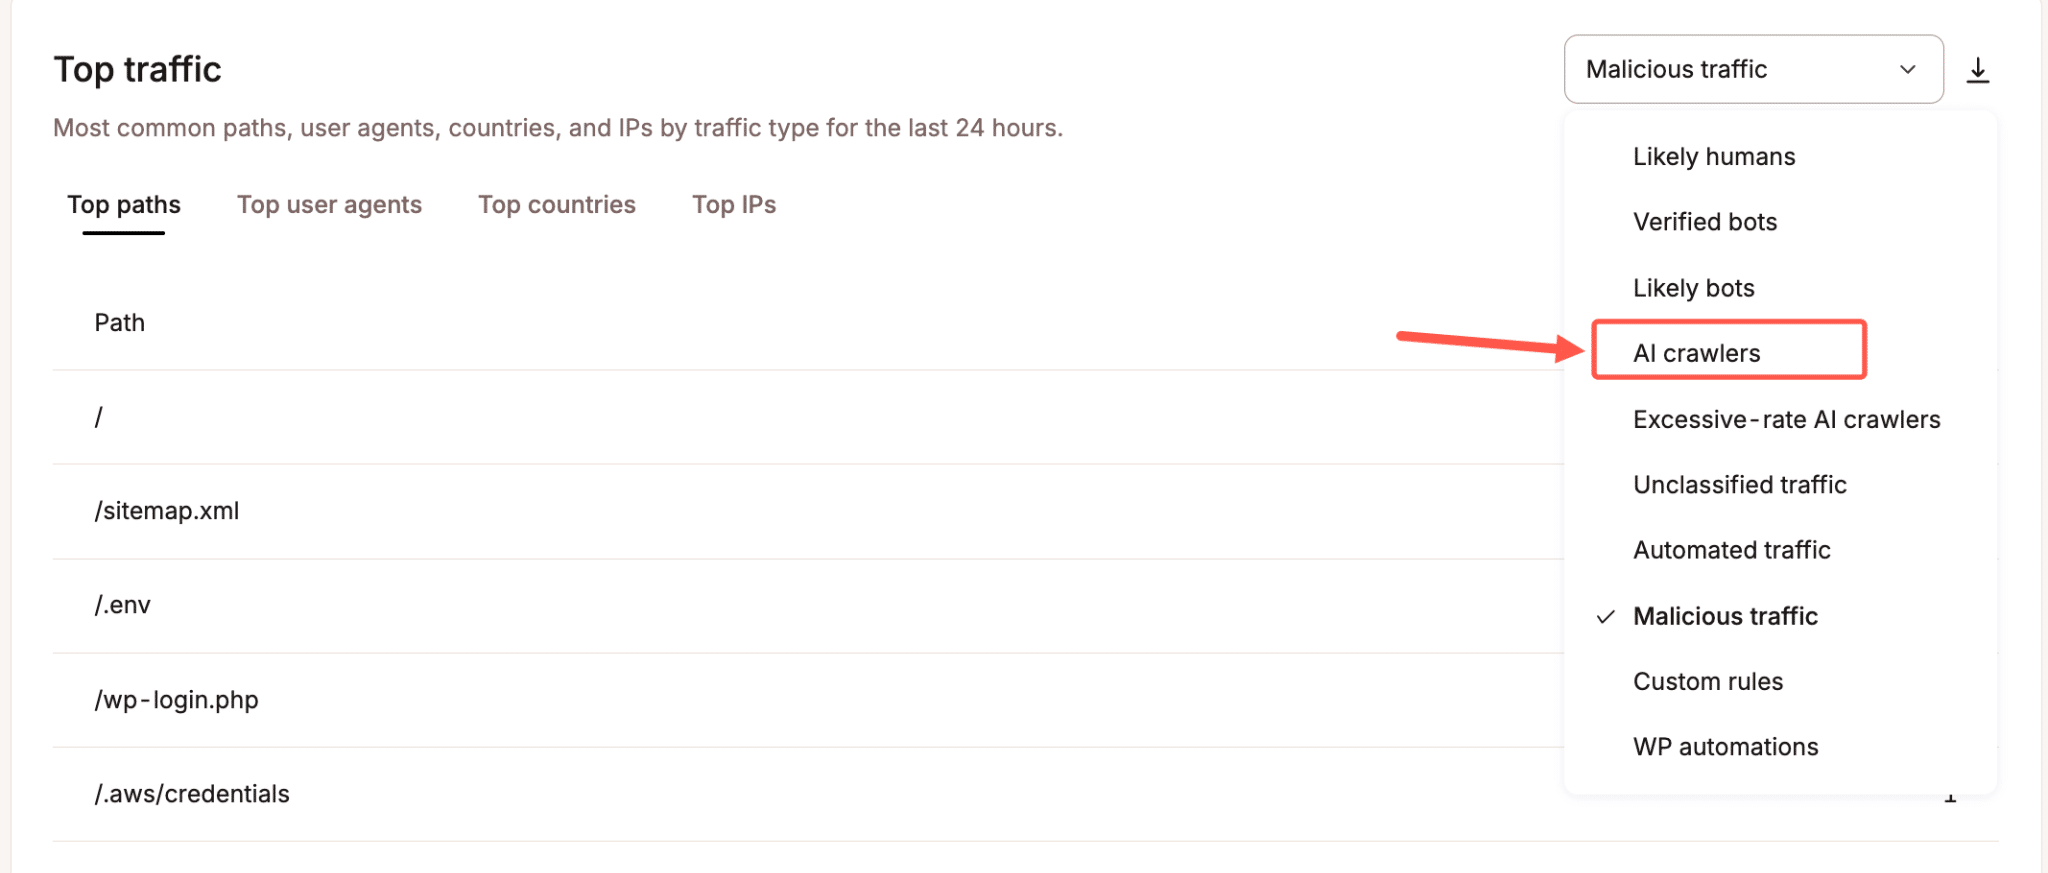
Vergelijk dat vervolgens met cache-informatie, serverbandbreedte en prestatiedata om te zien of die verzoeken de applicatie bereiken en werk veroorzaken.
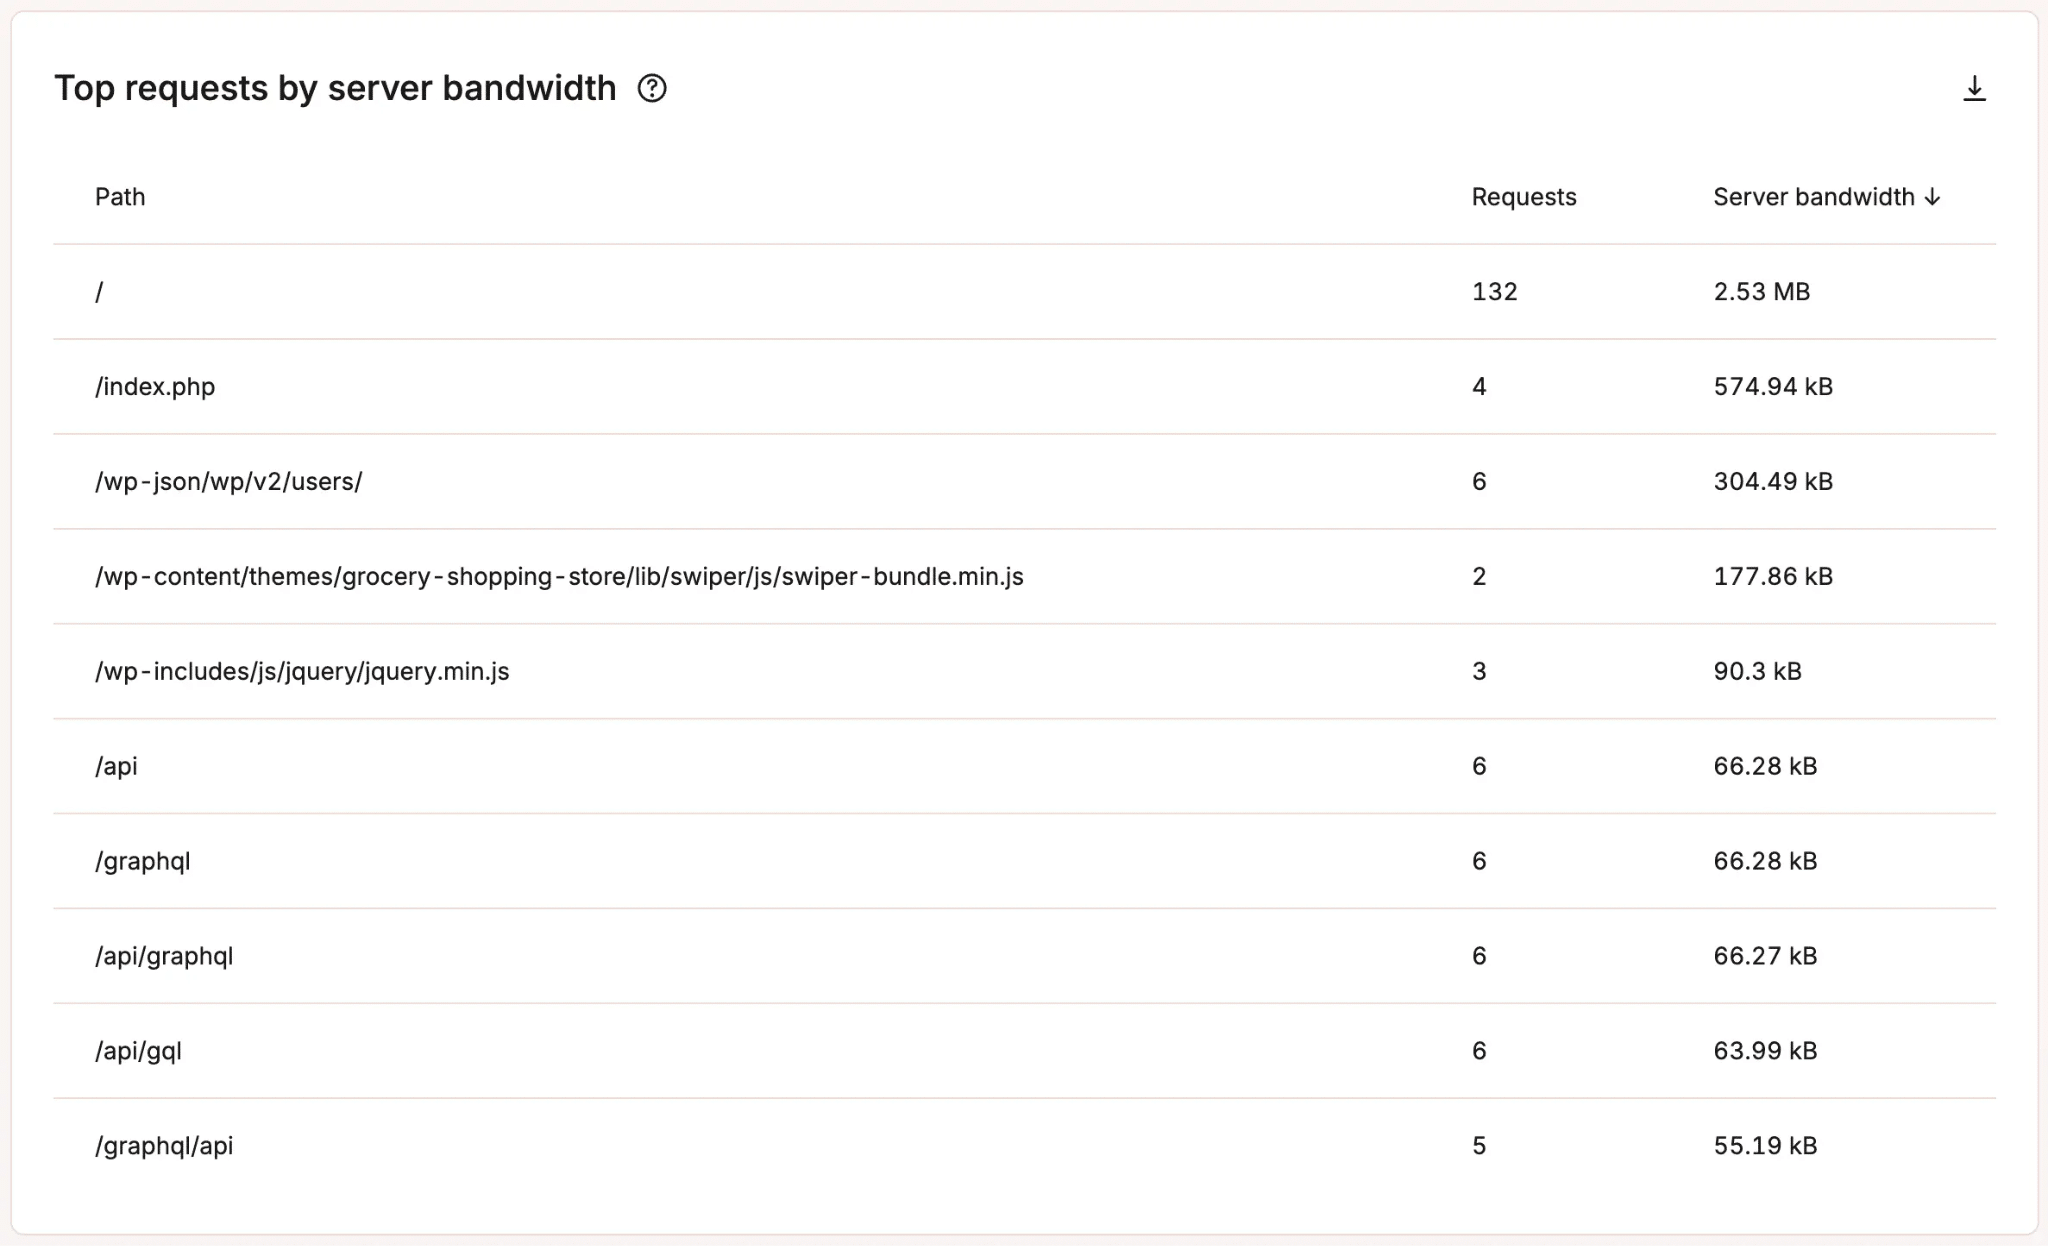
Het is handig om GPTBot of een andere crawler bovenaan een rapport te zien staan. Gaan duizenden van die verzoeken naar /blog/, dan zegt dat één ding. Gaan ze naar zoekresultaten of een WooCommerce URL met parameters, dan zegt dat iets anders.
Fout 5: de crawler blokkeren, maar de URL-structuur laten staan
Soms legt de bot alleen maar een probleem bloot dat al in je URL-structuur zat.
WordPress sites kunnen veel URL’s genereren via queryparameters, zoekpagina’s, gefilterde archieven, paginering, kalenders, productvarianten en e-commerce-acties.
Een mens ziet misschien dat twee net iets verschillende URL’s eigenlijk naar dezelfde pagina leiden. Een crawler ziet simpelweg meer links om te volgen.
Levert elke pagina weer een nieuwe reeks nieuw ogende URL’s op, dan kan de crawler die blijven volgen. Zo ontstaan patronen die er veel agressiever uitzien dan iemand ooit bedoeld had.
We zagen dit in ons eerdere infrastructuuronderzoek. Eén terugkerend patroon werd zo groot dat één enkele regel, bedoeld om het te detecteren, in 30 dagen 550 miljoen verzoeken filterde.
De crawler blokkeren kan de directe belasting stoppen, maar het URL-patroon waardoor hij steeds nieuwe pagina’s vond, blijft bestaan.
Domineert een bepaald pad ineens het AI-crawlerverkeer, kijk dan eens naar het pad zelf:
- Genereert WordPress grote aantallen parametercombinaties?
- Kan een crawler eindeloos door kalender- of paginerings-URL’s blijven gaan?
- Tonen zoek- en filterpagina’s duizenden URL-varianten?
- Zijn actie-URL’s, zoals ‘toevoegen aan winkelwagen’-links, crawlbaar terwijl dat niet nodig is?
- Moet elke gegenereerde URL echt bestaan en vindbaar zijn?
Misschien besluit je de crawler alsnog te blokkeren of een challenge te geven, maar zorg eerst dat je begrijpt waarom hij steeds terugkwam.
Dit is vooral belangrijk voor bureaus. Gebruiken meerdere klantsites dezelfde plugin, WooCommerce configuratie, hetzelfde thema of hetzelfde URL-patroon, dan kan één agressieve crawler hetzelfde probleem op meerdere sites blootleggen. Het gedrag aanpassen kan dan nuttiger zijn dan een steeds langere lijst met botnamen bijhouden.
Fout 6: aannemen dat robots.txt het verkeer heeft gestopt
Een wijziging in robots.txt kan de juiste reactie zijn als je een betrouwbare crawler wilt laten weten dat hij een deel van de site, of de hele site, niet mag benaderen. Controleer daarna wel het verkeer.
robots.txt werkt alleen als de crawler de instructie respecteert, en houdt het verzoek niet fysiek tegen voordat het je site bereikt.
We behandelen dit verschil uitgebreid in onze gids over AI-crawlers. robots.txt geeft crawlvoorkeuren door, terwijl llms.txt een gestructureerde contentindex biedt voor tools die ervoor kiezen die te lezen. Handhaven gebeurt ergens anders.
Dat is belangrijk bij een prestatieprobleem, want alleen een bestand aanpassen kan je het gevoel geven dat het probleem is opgelost.
Controleer je logs of botanalyses. Daalt het aantal crawlerverzoeken na je wijziging in robots.txt, dan heb je bewijs dat het werkt. Houdt het verkeer aan, of heb je te maken met een ander geautomatiseerd systeem dat de instructie negeert, dan heb je een maatregel nodig die het ook echt afdwingt.
Hetzelfde geldt als je probleem de verzoekfrequentie is en niet de toegang zelf. Een crawler mag je content dan wel lezen, maar kan dat nog steeds doen in een tempo dat je site niet soepel aankan.
Fout 7: de firewallregels van een andere site overnemen zonder te checken wat ze zouden blokkeren
Het voorbeeld van PatronView is nuttig omdat de maatregelen van de site op eigen data waren gebaseerd.
Het overgrote deel van het publiek zit in Noord-Amerika, dus de eigenaar geeft verkeer van andere continenten een challenge. Hij controleerde zijn echte bezoekersdata voordat hij gebruikers met oude browserversies een challenge gaf. Ook houdt hij bij hoeveel bezoekers die een challenge krijgen, die daadwerkelijk voltooien. In één periode werd slechts 0,24% van de meer dan 100.000 challenges opgelost.
Met die cijfers zijn de regels voor die site makkelijker te verantwoorden. Pas je dezelfde opzet toe op een internationale webwinkel, dan geef je mogelijk legitieme klanten een challenge. Hetzelfde risico ontstaat als teams meerdere beveiligingstools op elkaar stapelen, omdat elk ervan op zichzelf nuttig lijkt.
Een WordPress site kan botbescherming op hostingniveau hebben, Cloudflare regels, een beveiligingsplugin, rate limiting, landblokkades en custom WAF-regels, die allemaal over hetzelfde verzoek beslissen. Een vals-positief opsporen wordt dan veel lastiger als je niet weet welke laag de beslissing nam.
Kinsta klanten raden we uitdrukkelijk af om Kinsta Botbescherming te combineren met extra custom botbeschermingslagen. Tegenstrijdige classificaties kunnen ertoe leiden dat legitieme bezoekers of integraties worden geblokkeerd.
Hogere beschermingsniveaus kunnen ook invloed hebben op legitieme automatiseringen, zoals API’s, monitoringtools, webhooks en WordPress integraties. Daarom heeft MyKinsta de optie Sta typische WordPress automatiseringen toe, plus uitzonderingen die vertrouwde IP-adressen, paden en user agents altijd doorlaten.
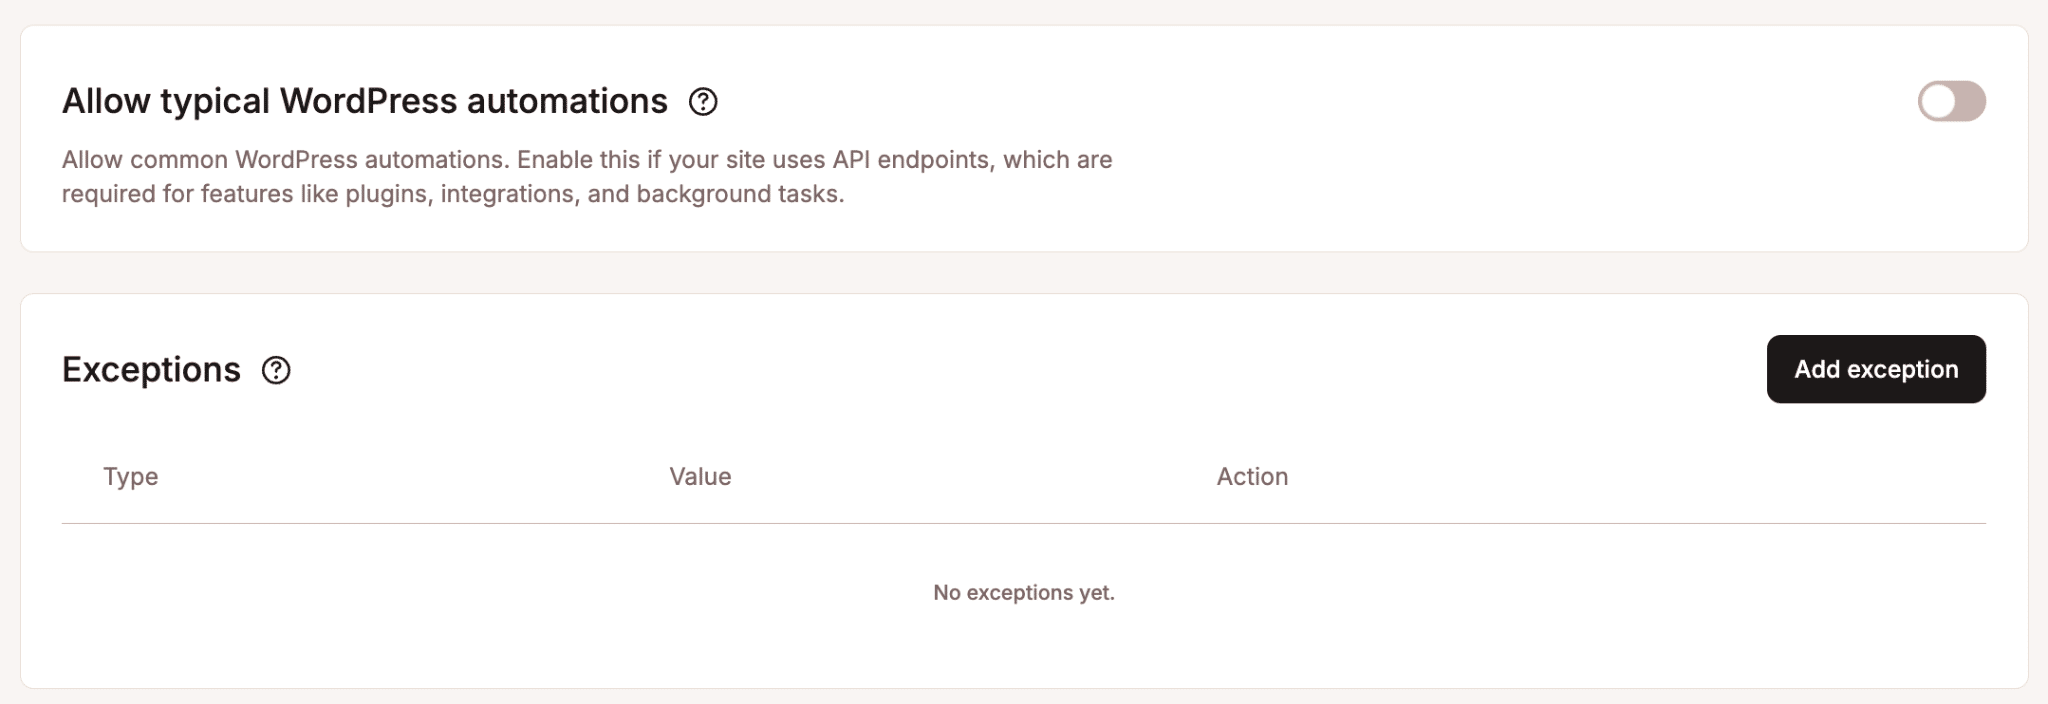
Run je een bureau, dan heb je meer aan een standaardproces dan aan een standaardset regels. Hetzelfde proces kun je toepassen op 20 klantsites: verkeer identificeren, paden inspecteren, prestaties controleren, een maatregel kiezen, die testen en het resultaat monitoren.
Wat te doen als je AI-botverkeer ontdekt
Begin met kijken wat er op je site gebeurt. Hindert botverkeer echte bezoekers, bescherm dan eerst de site. Kijk daarna hoeveel verkeer er binnenkomt, welke paden het bereikt en welke systemen erachter zitten.
Kies vervolgens de kleinste aanpassing die het probleem oplost. Dat kan betekenen dat je robots.txt bijwerkt, een crawler blokkeert of een challenge geeft, een crawlbaar URL-patroon aanpakt, of simpelweg niets doet als het verkeer geen schade veroorzaakt.
Als Kinsta klant kun je een groot deel van dit onderzoek direct in MyKinsta doen. De botverkeeranalyse maakt onderscheid tussen AI-crawlers, agressieve AI-crawlers, geverifieerde bots, geautomatiseerd verkeer en andere soorten verzoeken. Top verkeer laat de paden, user agents, landen en IP-adressen erachter zien.
Je kunt die activiteit ook vergelijken met het cachegedrag, de serverbandbreedte en de PHP prestaties om te zien of het verkeer je site echt onder druk zet, voordat je beslist wat je blokkeert.