Toevoegen als voorkeursbron op Google
Wil je dat je site in AI-zoekresultaten verschijnt, dan lijkt crawlers toelaten de logische keuze. Maar slokt geautomatiseerd verkeer te veel serverresources op, dan lijkt blokkeren net zo logisch. Het probleem ontstaat pas als je die twee opties als elkaar uitsluitend ziet.
Je hoeft niet elke bot dezelfde toegang te geven. Sommige crawlers helpen je content in zoek- of AI-resultaten te laten verschijnen. Andere belasten je site mogelijk zwaar, zonder veel bij te dragen aan je zichtbaarheid. Weet je welke welke is, dan kun je beslissen waar je de toegang openhoudt en waar je die aanscherpt.
“AI-crawler” wordt een te brede categorie
Niet elke AI-crawler doet hetzelfde werk. Behandel je ze allemaal hetzelfde, dan lever je al snel onnodig iets in: zichtbaarheid als je alles blokkeert, of snelheid als je alles toelaat.
Cloudflare deelt AI-verkeer nu in drie brede categorieën in:
- Zoekcrawlers indexeren content voor toekomstige zoekresultaten.
- Agentverkeer komt van tools die in realtime namens een gebruiker handelen.
- Trainingscrawlers verzamelen content om AI-modellen te trainen of te verfijnen.
De verkeersmix laat zien waarom dat onderscheid ertoe doet. Volgens Cloudflare was AI-training in juni 2026 goed voor 52% van de crawlerverzoeken. Crawlers voor gemengd gebruik namen meer dan 36% voor hun rekening. Crawlen puur voor zoekmachines heeft een kleiner aandeel, maar speelt nog altijd een belangrijke rol bij de vindbaarheid.
Ook zegt de naam of identiteit van een crawler niet alles. Eén bedrijf kan meerdere bots voor verschillende doelen inzetten, en één crawler kan meerdere functies vervullen. Zelfs geverifieerde bots kunnen prestatieproblemen veroorzaken als het aantal verzoeken te hoog oploopt.
Daardoor zijn algemene regels om alles toe te laten of te blokkeren minder bruikbaar. Wil je zichtbaar blijven in zoekmachines en AI-tools, kijk dan naar wat elke crawler daadwerkelijk doet en welke waarde hij oplevert. Als je begrijpt hoe AI-crawlers zich gedragen, kun je beter beslissen wat je toestaat, beperkt of in de gaten houdt.
Vraag je eerst af wat een crawler je oplevert
Heb je crawlers op doel ingedeeld, dan is de volgende vraag wat hun activiteit je oplevert.
Geautomatiseerd verkeer ondersteunt traditionele zoekposities, AI-vermeldingen, productontdekking, aanbevelingen en onderzoek dat namens jou wordt gedaan. Sommige van die interacties sturen uiteindelijk misschien bezoekers naar je site. Andere vergroten mogelijk je zichtbaarheid, zonder dat dat een klik oplevert die je makkelijk kunt meten.
Het mogelijke rendement loopt sterk uiteen. De data van Cloudflare over crawls per verwijzing laat zien hoe groot die kloof kan zijn. In 2025 crawlde Anthropic soms tienduizenden pagina’s voor elke verwijzing naar een website. Bij OpenAI liep die verhouding meestal op tot in de duizenden, terwijl Perplexity vaak onder een paar honderd crawls per verwijzing bleef.
Die cijfers veranderen in de loop van de tijd. Ze zijn dus vooral bruikbaar als bewijs van de scheve verhouding, niet als vaste ranglijst van AI-platforms. Ook vangen ze niet elke vorm van waarde. Cloudflare merkt op dat verkeer uit native AI-apps mogelijk geen traditionele Referer-header meestuurt. Daardoor worden sommige bezoeken niet aan het platform toegeschreven. AI-vermeldingen kunnen een merk of stuk content ook zichtbaar maken voor gebruikers die nooit doorklikken.
Toch blijft de basisvraag nuttig: wat krijg je terug voor de verzoeken die je site verwerkt?
Je kunt die afweging maken aan de hand van een paar factoren:
| Vraag | Wat je wilt vaststellen |
| Draagt de crawler bij aan vindbaarheid in zoekmachines of AI? | Mogelijke zichtbaarheid |
| Stuurt hij meetbaar verwijzingsverkeer? | Direct rendement |
| Welke pagina’s of endpoints vraagt hij op? | Infrastructuurkosten |
| Hoe vaak crawlt hij? | Operationele impact |
| Start een gebruiker het verzoek? | Directe waarde voor de gebruiker |
| Verlies je een belangrijk ontdekkingskanaal als je hem blokkeert? | Zichtbaarheidsrisico |
Tienduizend crawlerverzoeken zijn niet automatisch evenveel waard omdat ze allemaal van geautomatiseerde systemen komen. Kijk je naar zowel het rendement als de kosten, dan kun je beter beslissen welk verkeer je wilt behouden.
Scherm zware verzoeken af in plaats van al het botverkeer als even schadelijk te zien
Het type crawler doet ertoe, maar wat hij opvraagt zodra hij op je site is ook. Een bot die periodiek gecachete artikelen laadt, zorgt voor een heel andere workload dan een bot die steeds weer WordPress zoekresultaten, gefilterde productpagina’s, winkelwagen- en checkout-URL’s, REST API endpoints of URL’s met wisselende queryparameters opvraagt. Voor die verzoeken moet WordPress mogelijk een nieuw antwoord genereren, in plaats van content uit de cache te serveren.
Dat verschil loopt snel op. In een analyse van Kinsta naar botactiviteit genereerde geautomatiseerd verkeer binnen één periode van 24 uur 7,67 miljoen verzoeken naar add-to-cart-URL’s. ClaudeBot was goed voor 3,75 miljoen daarvan. Het probleem was niet simpelweg dat een AI-crawler de sites bezocht. Het probleem was dat miljoenen verzoeken op dynamische URL’s gericht waren, waar elk bezoek de applicatie mogelijk extra werk kostte.
Elders gaan we dieper in op het verband tussen botverkeer en de belasting van WordPress servers, en op de infrastructuurkosten die overmatig geautomatiseerd verkeer kan veroorzaken. Waar het hier om gaat: een crawler toegang geven hoeft niet te betekenen dat hij overal op je site dezelfde toegang krijgt.
Het kan zinvol zijn om een AI-dienst een openbaar artikel of productpagina te laten lezen, als je content daardoor beter in zoek- of AI-resultaten verschijnt. Maar het levert weinig op om diezelfde crawler steeds weer winkelwagen-URL’s, interne zoekpagina’s of andere delen van je site te laten opvragen die zwaar zijn om te laden en je vindbaarheid niet verbeteren.
Zo kun je op een andere manier naar botbescherming kijken. Vraag je niet alleen af welke crawlers je moet blokkeren, maar ook welke verzoeken het waard zijn om te verwerken.
Stem je botbeleid af op het verkeer dat je wilt behouden
Weet je welke verzoeken je site het zwaarst belasten, dan kun je makkelijker beslissen wat je toestaat en wat je beperkt. Eén allowlist of blocklist is meestal niet genoeg. Verschillende crawlers dienen verschillende doelen en leveren niet allemaal dezelfde waarde op.
Traditionele zoekcrawlers
Legitieme zoekcrawlers zoals Googlebot en Bingbot wil je meestal toelaten. Ze blijven belangrijk voor organische zoekresultaten, en dezelfde zoekindexen worden ook gebruikt voor steeds meer AI-gestuurde zoekervaringen.
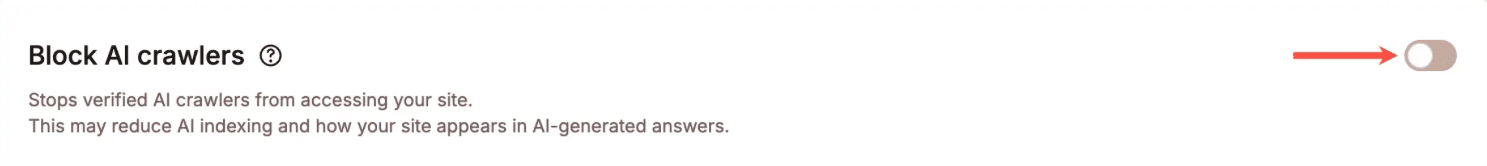
Kinsta behandelt grote zoekcrawlers als geverifieerde bots, en de instelling Blokkeer AI crawlers laat Googlebot en Bingbot door. Die scheiding helpt écht: je site beschermen tegen AI-crawlerverkeer betekent niet automatisch dat je hem uit de traditionele zoekresultaten haalt.
AI-crawlers voor zoeken en opvragen
Is AI-zichtbaarheid belangrijk voor je bedrijf, dan verdienen crawlers voor zoeken en opvragen een ander beleid dan bots die vooral trainingsdata verzamelen.
Deze crawlers kunnen actuele content ophalen, zodat AI-tools vragen beantwoorden, onderzoek doen, producten aanbevelen of gebruikers naar nuttige pagina’s sturen. Toelaten garandeert geen vermelding of verwijzing. Blokkeren kan wel een van de manieren afsluiten waarop een AI-systeem je nieuwste content vindt of ophaalt.
Voor sites die actief werken aan zichtbaarheid in AI-zoekresultaten is de praktische aanpak: laat dit verkeer toe waar het waarde oplevert en houd in de gaten hoe het zich gedraagt.
Trainingscrawlers
Bij trainingscrawlers ligt die afweging anders. Ze verzamelen content om modellen te trainen of te verbeteren. Hun activiteit heeft dus minder direct invloed op de vraag of iemand je nieuwste artikel of product via AI-zoekopdrachten kan vinden.
Dat betekent niet dat elke site ze automatisch moet blokkeren. Je beslissing hangt mogelijk af van hoeveel ze crawlen, hoeveel resources die verzoeken verbruiken, je contentstrategie en of je wilt dat je content voor modelontwikkeling wordt gebruikt.
Zorgt trainingsverkeer voor een flinke belasting terwijl het weinig meetbaar of strategisch rendement oplevert, dan is het makkelijker te verantwoorden om het te beperken.
Onbekend of overmatig geautomatiseerd verkeer
Zelfs een legitieme crawler kan een probleem worden als zijn verzoekfrequentie hoog genoeg oploopt.
De Botbescherming van Kinsta zet AI-crawlers met een te hoge verzoekfrequentie in een aparte categorie, agressieve AI-crawlers, los van gewoon AI-crawlerverkeer. Dat geldt ook voor geverifieerde crawlers, zodra hun activiteit een niveau bereikt dat de prestaties van je site kan beïnvloeden. Afhankelijk van het beschermingsniveau dat je kiest, krijgt dat verkeer een challenge. Verificatie is dan geen permanente vrijbrief om onbeperkt verzoeken te doen.
Je crawlerregels kunnen meebewegen met je verkeer. Misschien vind je het meestal prima om bepaalde bots toe te laten, maar wil je de toegang aanscherpen zodra ze te veel resources gaan gebruiken of de prestaties van je site beïnvloeden.
Bij Kinsta krijg je meerdere instellingen, niet één aan/uit-schakelaar voor AI
Een selectief botbeleid werkt het best als je aanpast hoe je site met verschillende soorten geautomatiseerd verkeer omgaat. Met Botbescherming van Kinsta krijg je daarvoor meerdere instellingen, zodat de beslissing niet beperkt blijft tot één instelling om toe te staan of te blokkeren.
Je kiest uit vier beschermingsniveaus:
- Blokkeer kwaadaardig verkeer houdt bekende kwaadaardige verzoeken tegen en laat ander verkeer door.
- Blokkeer automatiseringen voegt beperkingen toe voor bevestigd geautomatiseerd verkeer.
- Daag bots uit stuurt verkeer dat Kinsta als geautomatiseerd of waarschijnlijk geautomatiseerd herkent eerst langs een challenge.
- Geef iedereen een challenge is het strengste beschermingsniveau: alle bezoekers krijgen een challenge.
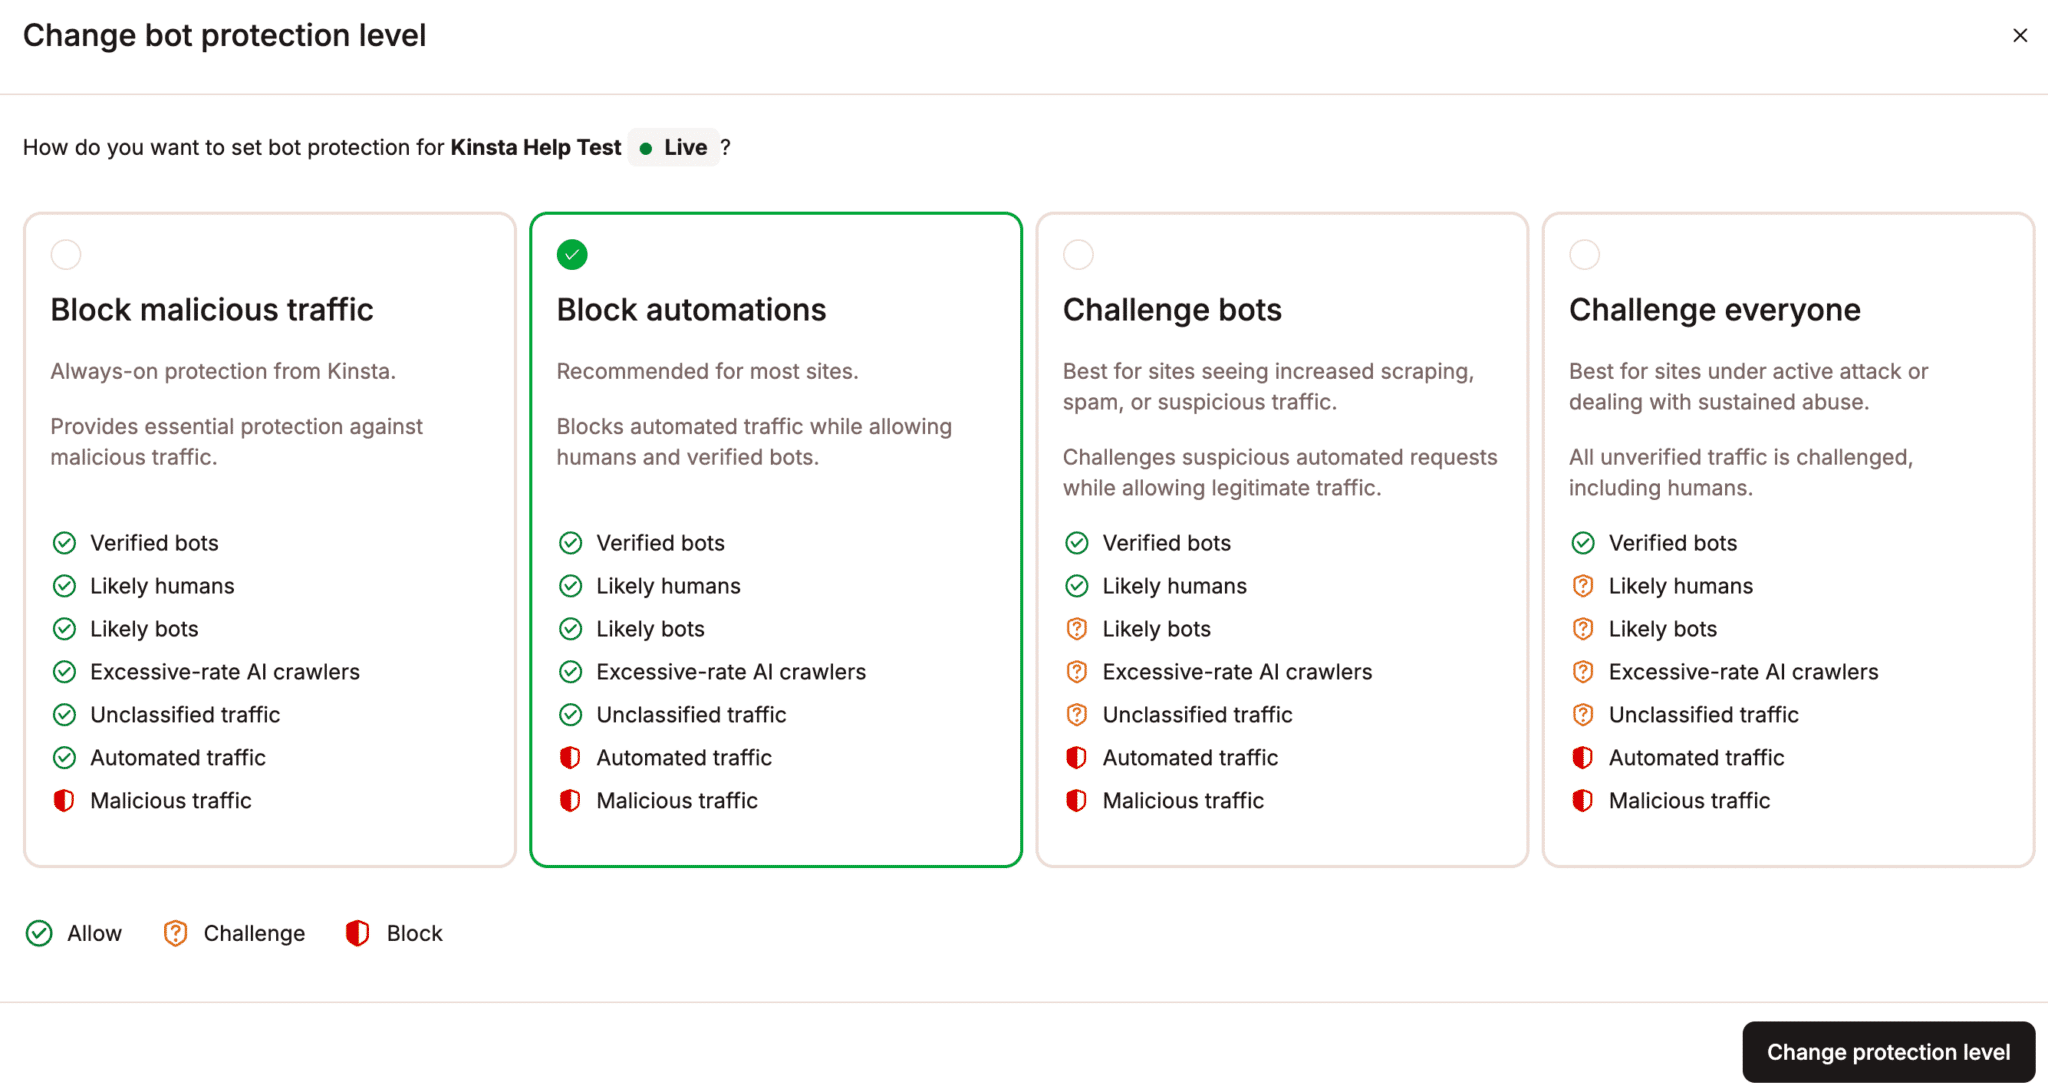
Met deze niveaus scherp je de handhaving aan zodra botverkeer een probleem wordt, zonder dat je voor elke crawler of user agent handmatig regels hoeft op te stellen.
Zoals gezegd heeft Kinsta ook een aparte instelling Blokkeer AI crawlers. Staat die aan, dan blokkeert hij ondersteunde AI-crawlers, ook geverifieerde, maar niet Googlebot of Bingbot. Zo kun je bepaalde AI-specifieke crawls beperken zonder je site af te sluiten voor traditionele zoekmachines.
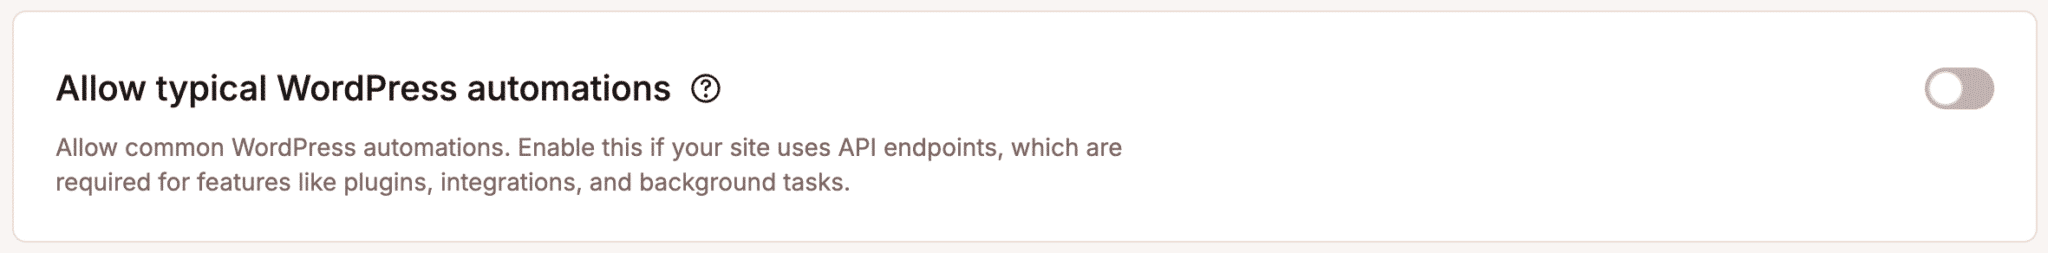
Strengere bescherming brengt wel een ander aandachtspunt met zich mee: legitieme automatisering. WordPress sites zijn afhankelijk van geplande taken, REST API verzoeken, plugin-integraties, betaaldiensten, monitoringtools en andere geautomatiseerde processen die je niet wilt onderbreken. De optie Sta typische WordPress automatiseringen toe helpt die activiteit door te laten als je een strenger beschermingsniveau gebruikt.
Heb je voor iets een specifiekere aanpak nodig, dan kun je met Uitzonderingen verkeer toestaan op basis van een IP-adres, pad of user agent.
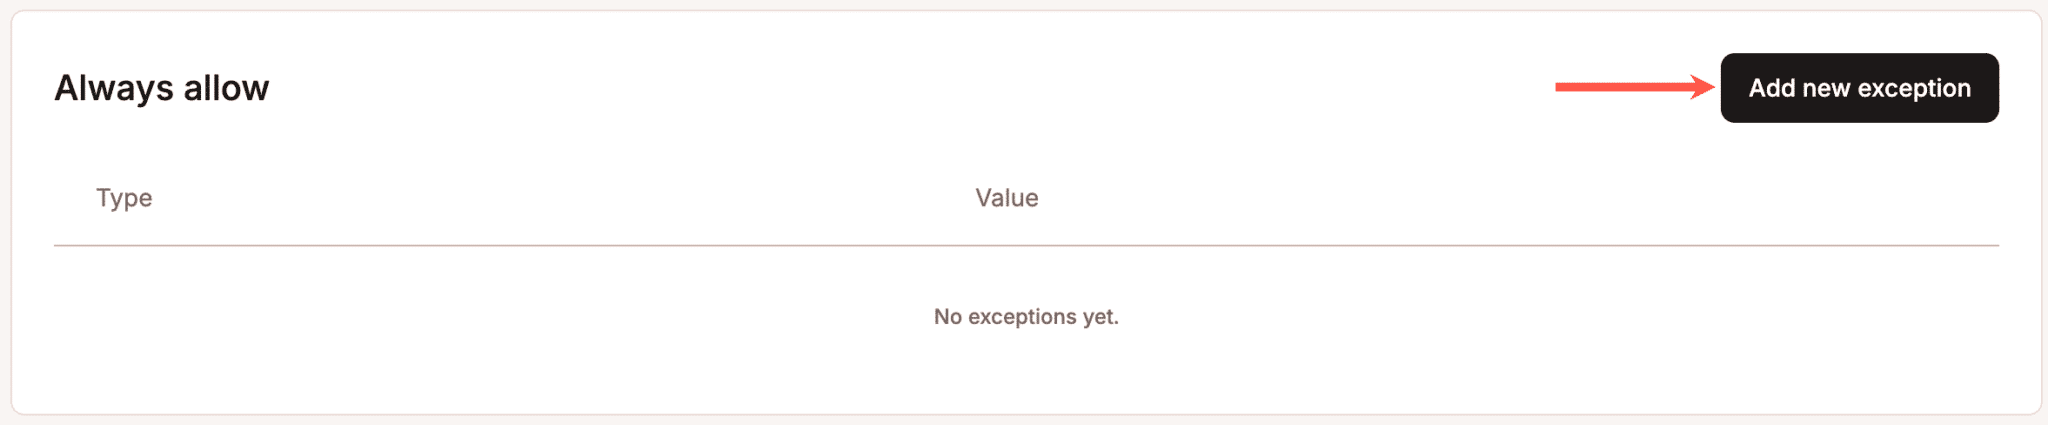
Samen geven deze instellingen je ruimte om je aanpak bij te stellen als het verkeer verandert. Je laat nuttig zoek- en automatiseringsverkeer door, beperkt AI-crawlers als dat het waard is en verhoogt de bescherming zodra geautomatiseerde activiteit je site te zwaar belast.
Meet of je balans echt werkt
Botbescherming werkt het best als doorlopend proces, niet als eenmalige configuratie. Heb je aangepast hoe je site met geautomatiseerd verkeer omgaat, controleer dan of die wijziging de prestaties echt verbetert zonder nuttige ontdekkingskanalen af te sluiten.
Vergelijk eerst wat er gebeurt voor en na een wijziging. Kijk naar:
- Het aantal AI-crawlerverzoeken
- Activiteit van agressieve AI-crawlers
- De meest opgevraagde paden
- Hoeveel verzoeken worden toegestaan, een challenge krijgen of worden geblokkeerd
- De prestaties van je site tijdens pieken in crawlerverkeer
- Organisch zoekverkeer
- AI-verwijzingsverkeer, voor zover je dat kunt meten
- Conversies of andere waardevolle acties van bezoekers die via AI binnenkomen
In MyKinsta kun je die activiteit op verschillende manieren onderzoeken. Het overzicht Breakdown verzoeken deelt verzoeken in categorieën in, waaronder geverifieerde bots, AI-crawlers, agressieve AI-crawlers, geautomatiseerd verkeer en waarschijnlijke bots. Met het overzicht Top verkeer kun je vervolgens achterhalen welke paden, user agents, IP-adressen en landen de meeste verzoeken genereren.
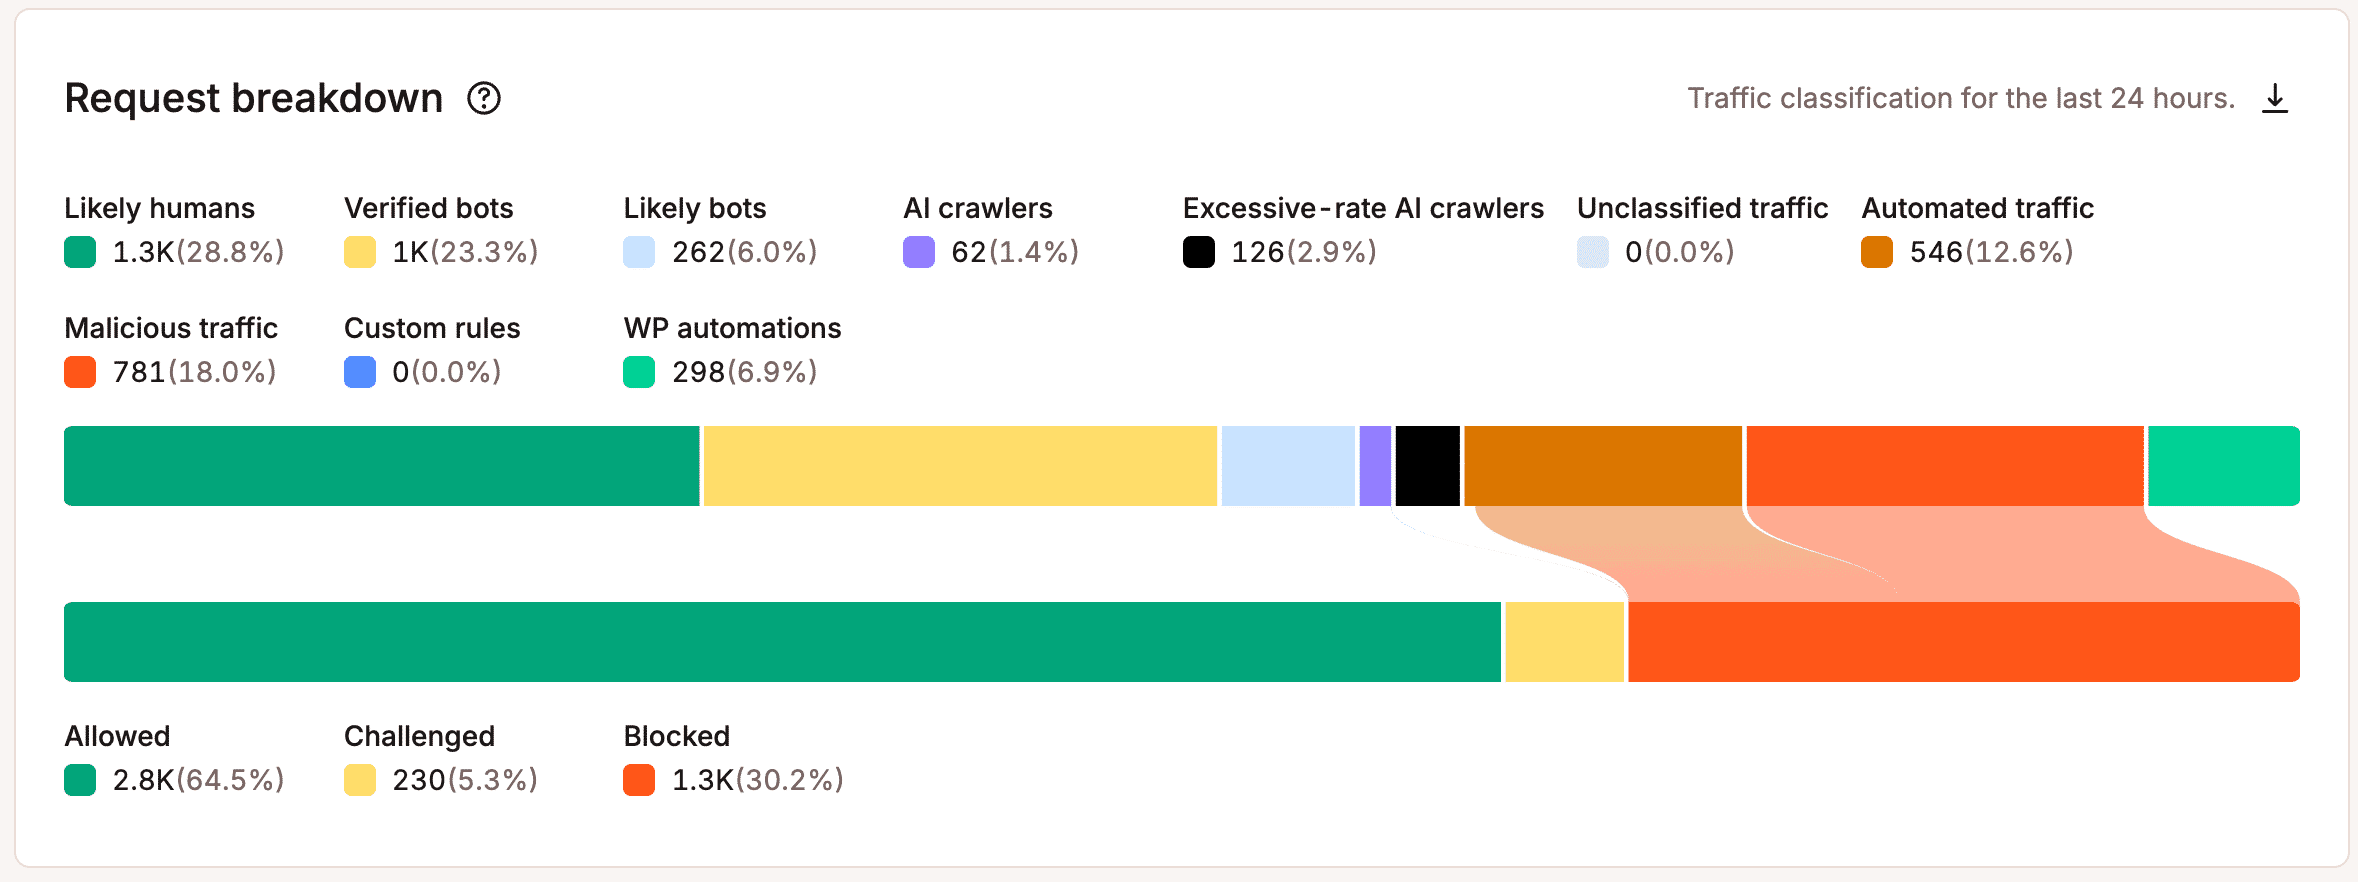
Die overzichten zijn vooral handig nadat je een beschermingsniveau hebt aangepast of een categorie crawlers hebt geblokkeerd. Daalt de serverbelasting terwijl het zoekverkeer en de AI-verwijzingen stabiel blijven, dan doet de wijziging misschien precies wat je bedoelde. Daalt het nuttige verkeer mee, dan heb je een reden om de instelling opnieuw te bekijken of een gerichtere uitzondering toe te voegen.
Hetzelfde geldt als de omstandigheden veranderen. Een crawler die vandaag weinig problemen geeft, kan later zijn verzoekfrequentie opvoeren. En een AI-ontdekkingskanaal dat nu weinig meetbaar verkeer stuurt, kan na verloop van tijd juist waardevoller worden.
Een eenvoudige cyclus werkt goed: observeer, pas aan, vergelijk en houd de wijziging daarna aan of draai hem terug.
De nieuwe AI-instellingen van Cloudflare laten zien waar botbeheer naartoe gaat
De recente wijzigingen bij Cloudflare wijzen op dezelfde bredere strategie: beheer geautomatiseerd verkeer op basis van wat het doet, in plaats van voor elke AI-crawler dezelfde regel te hanteren.
In juli 2026 verving Cloudflare zijn uniforme aanpak voor AI-bots door aparte instellingen voor Search-, Agent- en Training-verkeer. Site-eigenaren kunnen elke categorie toestaan, op de hele site blokkeren of alleen blokkeren op pagina’s met advertenties. Vanaf 15 september krijgen nieuwe domeinen standaardinstellingen die Search toestaan en Agent- en Training-verkeer blokkeren op pagina’s met advertenties. Cloudflare past ook aan hoe zijn beleid geldt voor crawlers met gemengde doelen, die bijvoorbeeld Search en Training combineren.
Die wijziging is belangrijk omdat ze een probleem erkent waar site-eigenaren al mee worstelen. Misschien wil je dat een crawler content indexeert zodat die vindbaar is, zonder dat dezelfde partij onbeperkte toegang krijgt om modellen te trainen. Met één schakelaar voor “AI-bots” kun je die voorkeur niet goed uitdrukken.
Host je bij Kinsta, wees dan voorzichtig met extra botbescherming bovenop wat er al is. Gebruik je daarnaast een eigen Cloudflare configuratie met custom WAF- of botregels, dan verwerkt Cloudflare die verzoeken eerst. In sommige gevallen kan legitiem verkeer daardoor al worden geblokkeerd voordat Kinsta het te zien krijgt.
De wijzigingen van Cloudflare zijn minder bruikbaar als nieuwe set regels die elke WordPress site moet overnemen, en meer als teken van waar botbeheer naartoe gaat. Het is niet langer alles of niets: je houdt het geautomatiseerde verkeer dat iets oplevert en beperkt de rest.
Bureaus hebben een beleid nodig, niet één instelling voor elke klant
Voor bureaus bestaat er geen botbeleid dat voor elke klant werkt. Een uitgever wil misschien meer AI-crawleractiviteit toestaan als dat de vindbaarheid helpt. Een drukbezochte WooCommerce site heeft mogelijk juist strengere limieten nodig, zodra die verzoeken met kopers gaan concurreren om serverresources.
Een casestudy over ons werk met Hall laat zien waarom die verschillen ertoe doen. Een van de WooCommerce klanten van het bureau had last van downtime tijdens verkeerspieken, voordat die klant naar Kinsta overstapte. Naarmate het bedrijf groeide van $3 miljoen naar meer dan $50 miljoen jaaromzet, werden betrouwbare prestaties tijdens piekmomenten steeds belangrijker.
Botregels moeten aansluiten bij hoe elke site werkt. Zoek uit welke crawlers belangrijk zijn voor de klant, welke de site het zwaarst belasten en welke geautomatiseerde diensten bereikbaar moeten blijven. Stel de regels daarna in de loop van de tijd bij, naarmate het verkeer en de behoeften van de klant veranderen.
Beheer de toegang zonder onzichtbaar te worden
Je hoeft niet te kiezen tussen je site zichtbaar maken voor AI-systemen en hem beschermen tegen overmatig geautomatiseerd verkeer. De betere vraag is welke activiteit toegang verdient, waar die toegang zinvol is en wat het je site kost om die te verwerken.
Behoud het zoek- en AI-verkeer dat mensen helpt je site te vinden, maar let goed op wat er gebeurt zodra die crawlers binnen zijn. Gebruikt een bot veel resources zonder dat het veel oplevert, dan kun je zijn toegang beperken. Let er wel op dat je de WordPress automatiseringen of andere diensten waar je site op draait niet verstoort.
Die beslissingen kunnen veranderen naarmate het gedrag van crawlers, AI-verwijzingspatronen en je eigen prioriteiten zich ontwikkelen. Waar het om gaat, is dat je genoeg inzicht hebt om te zien wat er gebeurt en genoeg controle om daarop te reageren.
Lees meer over Botbescherming van Kinsta en bekijk de bevindingen in ons AI & Botverkeer Rapport.
Carlo is een gepassioneerd liefhebber van webdesign en front-end development. Hij werkt al meer dan 10 jaar met WordPress, ook in samenwerking met Italiaanse en Europese universiteiten en onderwijsinstellingen. Hij heeft tientallen artikelen en gidsen over WordPress geschreven, gepubliceerd op zowel Italiaanse als internationale websites en in gedrukte tijdschriften. Je kunt Carlo vinden op X en LinkedIn.