Ajouter comme source préférée sur Google
Si vous souhaitez que votre site apparaisse dans les résultats de recherche basés sur l’IA, autoriser les robots d’indexation peut sembler être le choix évident. Mais si le trafic automatisé consomme trop de ressources serveur, le bloquer semble tout aussi raisonnable. Le problème réside dans le fait de considérer ces deux options comme mutuellement exclusives.
Vous n’avez pas besoin d’accorder le même niveau d’accès à tous les robots. Certains robots d’indexation contribuent à faire apparaitre votre contenu dans les résultats de recherche ou d’IA, tandis que d’autres peuvent solliciter massivement votre site sans pour autant améliorer sa visibilité. Une fois que vous aurez fait la distinction entre les uns et les autres, vous pourrez décider où maintenir l’accès ouvert et où le restreindre.
La catégorie « robot d’IA » devient trop vague
Tous les robots d’exploration IA ne remplissent pas la même fonction ; les traiter tous de la même manière peut donc entrainer des compromis inutiles entre visibilité et performances.
Cloudflare regroupe désormais le trafic IA en trois grandes catégories :
- Les robots d’indexation indexent le contenu en vue de futurs résultats de recherche.
- Le trafic des agents provient d’outils agissant en temps réel pour le compte d’un utilisateur.
- Les robots d’entrainement collectent du contenu pour entrainer ou affiner des modèles d’IA.
La composition du trafic montre pourquoi ces distinctions sont importantes. Cloudflare indique que l’entraînement de l’IA représente 52 % des requêtes de robots explorateurs en juin 2026, tandis que les robots explorateurs à usage mixte en représentent plus de 36 %. L’exploration dédiée à la recherche ne représente qu’une part plus modeste, mais joue néanmoins un rôle important dans la visibilité.
L’identité d’un robot d’indexation à elle seule ne vous apporte qu’une information limitée. Une même entreprise peut exploiter plusieurs robots à des fins différentes, et un seul robot d’indexation peut remplir plusieurs fonctions. Même les bots vérifiés peuvent entrainer des problèmes de performances si le volume de requêtes devient trop important.
Cela rend les politiques générales d’autorisation ou de blocage moins efficaces. Si vous souhaitez rester visible dans les résultats de recherche et la découverte alimentée par l’IA, concentrez-vous sur ce que chaque robot d’indexation fait réellement et sur la valeur qu’il apporte. Comprendre le comportement des robots d’indexation IA vous offre une meilleure base pour décider ce qu’il convient d’autoriser, de restreindre ou de surveiller.
Commencez par vous demander ce que le robot d’indexation vous apporte en retour
Une fois que vous avez classé les robots d’indexation par objectif, la question suivante est de savoir ce que leur activité vous apporte en retour.
Le trafic automatisé soutient les classements de recherche traditionnels, les citations issues de l’IA, la découverte de produits, les recommandations et les recherches effectuées en votre nom. Certaines de ces interactions peuvent, à terme, diriger des visiteurs vers votre site. D’autres peuvent accroitre votre visibilité sans générer de clic que vous puissiez facilement mesurer.
Le retour potentiel varie considérablement. Les données de Cloudflare sur le rapport entre l’exploration et les références montrent à quel point cet écart peut être important. Tout au long de l’année 2025, Anthropic a parfois exploré des dizaines de milliers de pages pour chaque référence envoyée à un site web. Le ratio d’OpenAI atteignait généralement plusieurs milliers, tandis que celui de Perplexity restait souvent inférieur à quelques centaines d’explorations par référence.
Ces chiffres évoluent au fil du temps ; ils constituent donc davantage une illustration de cette disparité qu’un classement définitif des plateformes d’IA. Ils ne reflètent pas non plus toutes les formes de valeur. Cloudflare souligne que le trafic provenant d’applications d’IA natives peut ne pas inclure d’en-tête « Referer » traditionnel, ce qui signifie que certaines visites ne sont pas attribuées à la plateforme. Les citations issues de l’IA peuvent également exposer une marque ou un contenu à des utilisateurs qui ne cliquent jamais sur le lien.
Néanmoins, la question fondamentale reste pertinente : qu’obtenez-vous en échange des requêtes traitées par votre site ?
Vous pouvez évaluer ce rapport en examinant plusieurs facteurs :
| Question | Ce que vous cherchez à établir |
| Le robot d’indexation prend-il en charge la recherche ou la découverte par IA ? | Visibilité potentielle |
| Génère-t-il un trafic de référence mesurable ? | Retour direct |
| Quelles pages ou quels points de terminaison interroge-t-il ? | Cout de l’infrastructure |
| À quelle fréquence effectue-t-il son exploration ? | Impact opérationnel |
| La requête est-elle déclenchée par un utilisateur ? | Valeur immédiate pour l’utilisateur |
| Le blocage de cette requête supprimerait-il un canal de découverte important ? | Risque lié à la visibilité |
Dix mille requêtes de robots d’indexation n’ont pas la même valeur simplement parce qu’elles proviennent de systèmes automatisés. En examinant à la fois le rendement et le cout, vous disposez d’une meilleure base pour décider quel trafic préserver.
Protégez les requêtes couteuses plutôt que de considérer l’ensemble du trafic des robots comme également nuisible
Le type de robot d’indexation a son importance, mais ce qu’il demande une fois sur votre site en a tout autant. Un robot qui charge périodiquement des articles mis en cache génère une charge de travail très différente de celle d’un robot qui accède de manière répétée aux résultats de recherche WordPress, aux pages de produits filtrées, aux URL du panier et de commande, aux points de terminaison de l’API REST ou aux URL dont les paramètres de requête changent. Ces requêtes peuvent obliger WordPress à générer une nouvelle réponse au lieu de servir le contenu à partir de la mémoire cache.
Cette différence s’accumule rapidement. Dans l’analyse de Kinsta portant sur l’activité des bots, le trafic automatisé a généré 7,67 millions de requêtes vers des URL « Ajouter au panier » en l’espace de 24 heures seulement. ClaudeBot en a représenté 3,75 millions. Le problème ne résidait pas simplement dans le fait qu’un robot d’indexation basé sur l’IA ait visité les sites. Il tenait au fait que des millions de requêtes ciblaient des URL dynamiques, où chaque visite était susceptible d’exiger davantage de travail de la part de l’application.
Nous avons abordé plus en détail ailleurs la relation entre le trafic des robots et la charge des serveurs WordPress, ainsi que le coût d’infrastructure que peut engendrer un trafic automatisé excessif. Le point important ici est que l’accès d’un robot d’indexation ne doit pas nécessairement signifier un accès égal à toutes les parties d’un site.
Il peut être judicieux de laisser un service d’IA lire un article public ou une page produit si cela aide votre contenu à apparaitre dans les résultats de recherche ou d’IA. Mais il y a peu d’intérêt à laisser ce même robot d’indexation accéder à plusieurs reprises à des URL de commande, à des pages de recherche interne ou à d’autres parties du site dont le chargement est couteux et qui n’améliorent pas la visibilité.
Cela vous offre une autre façon d’envisager la protection contre les robots. Au lieu de vous demander uniquement quels robots d’indexation vous devriez bloquer, demandez-vous également quelles requêtes méritent d’être traitées.
Élaborez votre politique relative aux robots en fonction du trafic que vous souhaitez préserver
Une fois que vous savez quelles requêtes sollicitent le plus votre site, il est plus facile de décider ce qu’il faut autoriser et ce qu’il faut limiter. Une simple liste d’autorisation ou une liste de blocage ne suffit généralement pas, car les différents robots ont des objectifs variés et n’apportent pas tous la même valeur ajoutée.
Les robots d’indexation traditionnels
Vous souhaiterez généralement conserver les robots d’indexation légitimes tels que Googlebot et Bingbot. Ils restent essentiels pour le référencement naturel, et ces mêmes index de recherche sont également utilisés pour alimenter des expériences de recherche davantage basées sur l’IA.
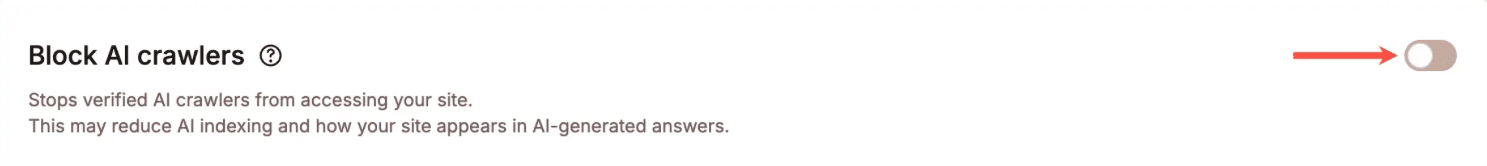
Kinsta considère les principaux robots d’indexation comme des bots vérifiés, et son paramètre « Bloquer les robots d’indexation IA » ne bloque ni Googlebot ni Bingbot. Cette distinction est très utile, car protéger votre site contre le trafic des robots d’indexation IA ne signifie pas automatiquement le retirer du référencement traditionnel.
Robots de recherche et d’extraction basés sur l’IA
Si la visibilité via l’IA est importante pour votre entreprise, les robots de recherche et d’extraction méritent une politique différente de celle appliquée aux bots qui collectent principalement des données d’entrainement.
Ces robots peuvent accéder au contenu actuel afin que les outils d’IA puissent répondre à des questions, effectuer des recherches, recommander des produits ou orienter les utilisateurs vers des pages utiles. Leur autoriser l’accès ne garantit pas une citation ou un renvoi, mais les bloquer peut priver un système d’IA d’un moyen de trouver ou d’extraire votre contenu le plus récent.
Pour les sites qui cherchent activement à gagner en visibilité dans la recherche par IA, l’approche la plus pragmatique consiste à autoriser ce trafic lorsqu’il apporte de la valeur ajoutée et à surveiller son comportement.
Les robots d’indexation destinés à l’entrainement
Les robots d’indexation utilisés pour l’entrainement posent un autre dilemme. Ils collectent du contenu pour entrainer ou affiner des modèles ; leur activité a donc un lien moins direct avec la capacité d’un utilisateur à trouver votre dernier article ou produit via la recherche par IA.
Cela ne signifie pas pour autant que chaque site doive automatiquement les bloquer. Votre décision peut dépendre de l’intensité de leur exploration, des ressources consommées par ces requêtes, de votre stratégie de contenu et de votre volonté ou non de voir votre contenu utilisé pour le développement de modèles.
Si le trafic lié à l’entrainement génère une charge importante tout en n’apportant qu’un faible retour mesurable ou stratégique, il devient plus facile de justifier sa restriction.
Trafic automatisé inconnu ou excessif
Même un robot d’exploration légitime peut poser problème lorsque son taux de requêtes devient suffisamment élevé.
La protection contre les robots de Kinsta classe les robots d’exploration IA à taux excessif séparément du trafic ordinaire des robots d’exploration IA. Cela inclut les robots d’exploration vérifiés lorsque leur activité atteint des niveaux susceptibles d’affecter les performances du site. En fonction du niveau de protection que vous choisissez, Kinsta peut remettre en question ce trafic plutôt que de considérer la vérification comme une autorisation permanente à effectuer un nombre illimité de requêtes.
Vos règles relatives aux robots d’indexation peuvent évoluer en fonction des variations du trafic. Vous pouvez choisir d’autoriser certains robots la plupart du temps, puis de restreindre leur accès s’ils commencent à utiliser trop de ressources ou à affecter les performances du site.
Kinsta vous offre plusieurs options de contrôle, et non un simple bouton « On/Off » pour l’IA
Une politique sélective vis-à-vis des robots fonctionne mieux lorsque vous adaptez la manière dont votre site gère les différents types de trafic automatisé. La protection contre les robots de Kinsta vous offre plusieurs contrôles pour y parvenir, plutôt que de réduire la décision à un simple réglage « autoriser ou bloquer ».
Kinsta propose quatre niveaux de protection :
- Le blocage du trafic malveillant bloque les requêtes malveillantes connues tout en laissant passer le reste du trafic.
- Le blocage des automatisations ajoute des restrictions au trafic automatisé confirmé.
- Défier les robots : applique une vérification au trafic que Kinsta identifie comme automatisé ou susceptible de l’être.
- Défier tout le monde : applique le niveau de protection le plus strict et soumet tous les visiteurs à une mise à l’épreuve.
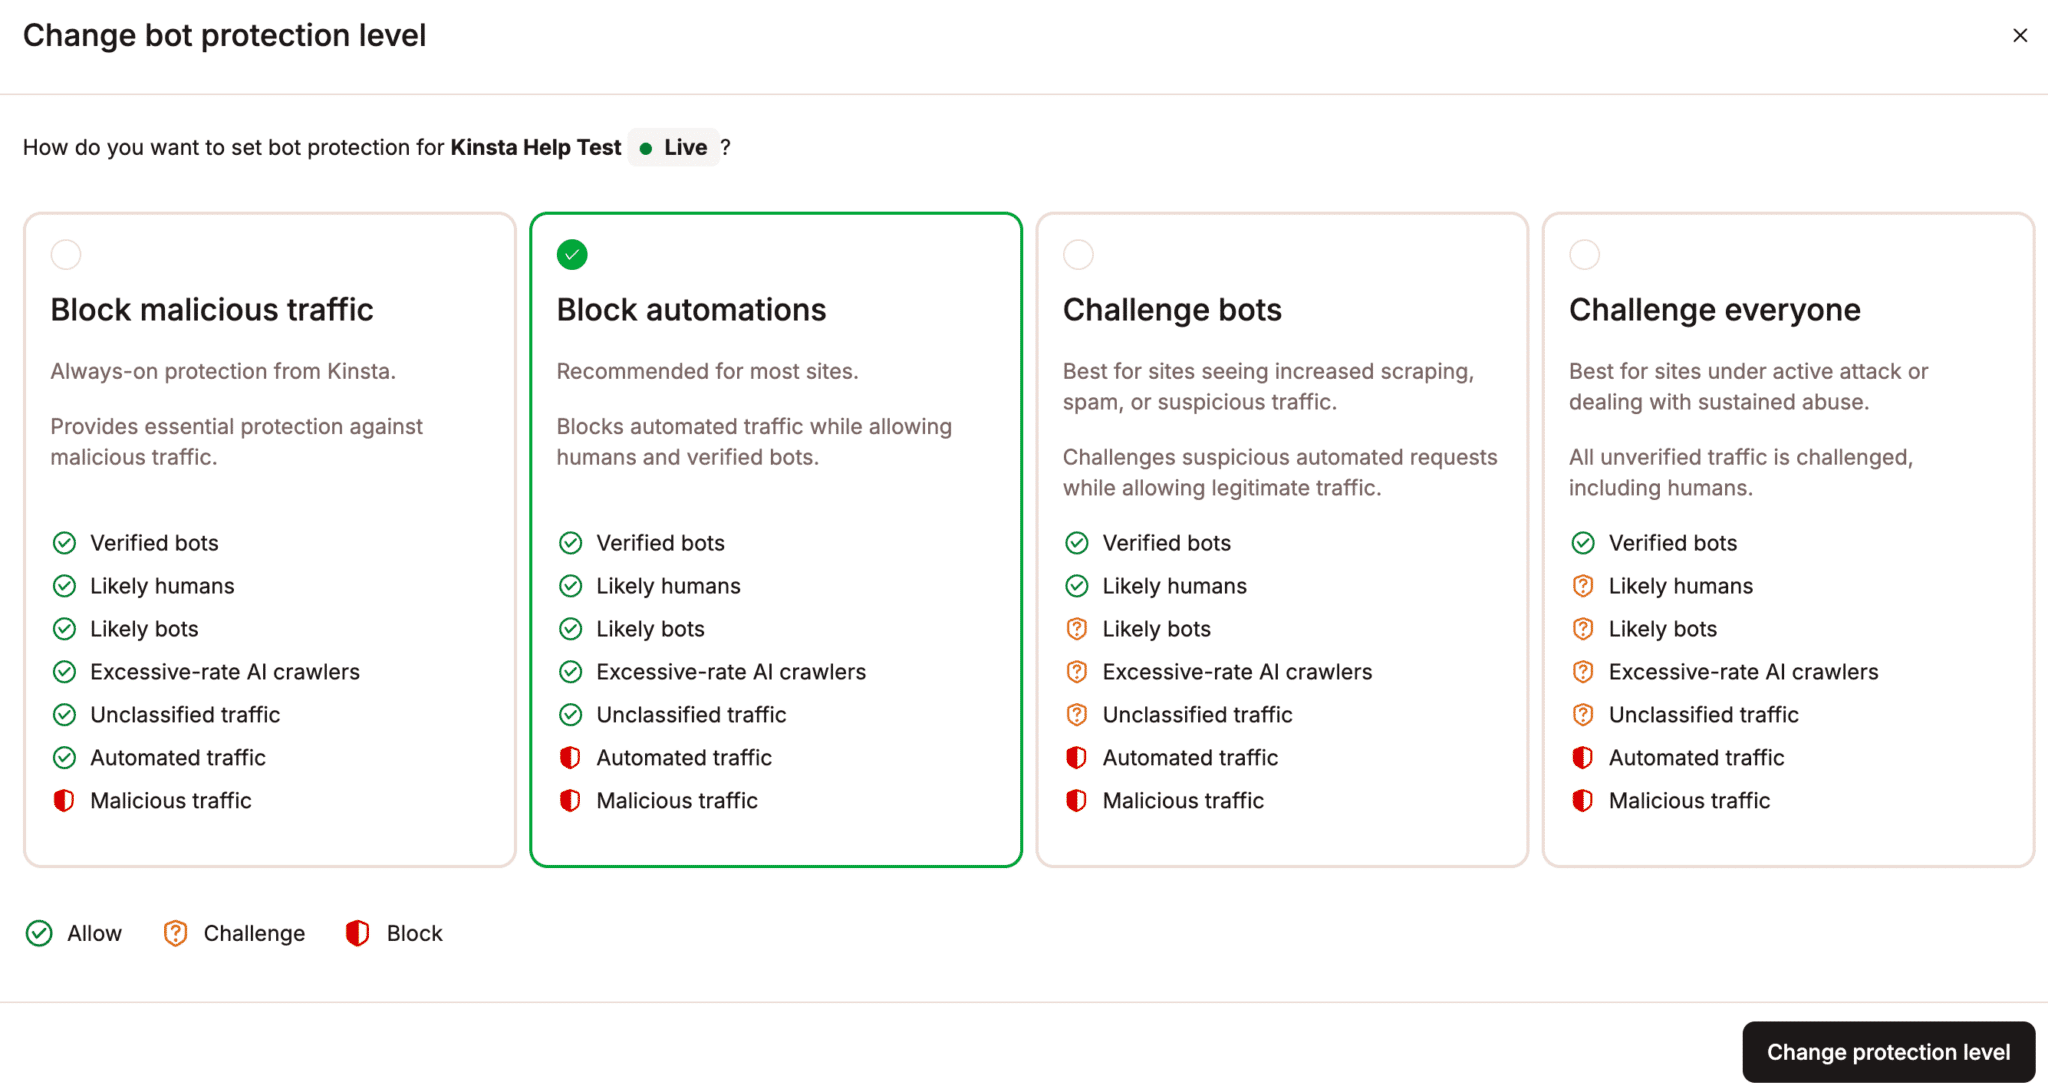
Ces niveaux vous permettent de renforcer la protection lorsque le trafic généré par les robots devient problématique, sans avoir à créer manuellement des règles pour chaque robot d’indexation ou agent utilisateur.
Comme indiqué précédemment, Kinsta propose également un réglage distinct intitulé Bloquer les robots d’indexation IA. Lorsqu’il est activé, il bloque les robots d’indexation IA pris en charge, y compris ceux qui ont été vérifiés, mais ne bloque pas Googlebot ni Bingbot. Cela permet de restreindre certains processus d’indexation spécifiques à l’IA sans couper votre site des moteurs de recherche traditionnels.
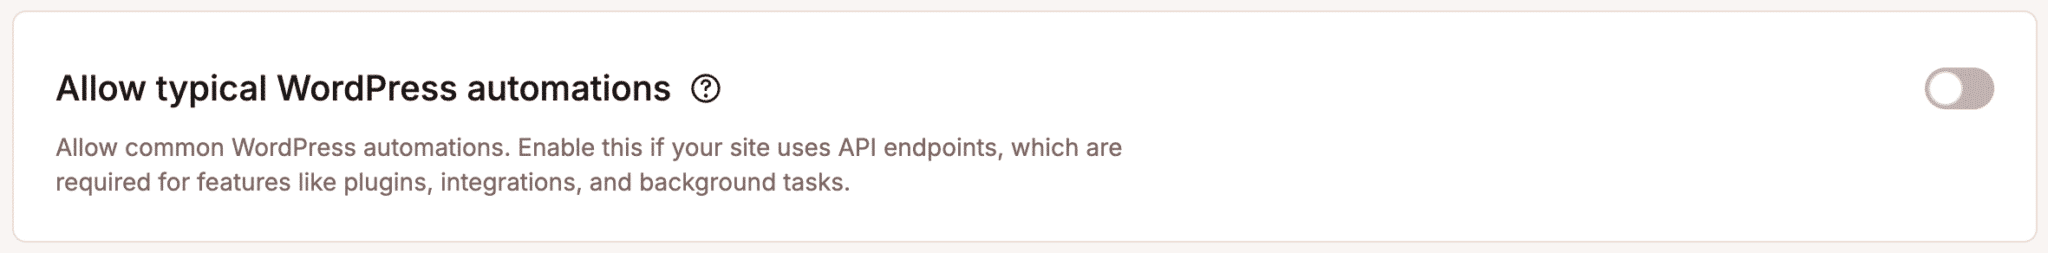
Une protection plus stricte soulève toutefois une autre préoccupation : l’automatisation légitime. Les sites WordPress s’appuient sur des tâches planifiées, des requêtes API REST, des intégrations d’extensions, des services de paiement, des outils de surveillance et d’autres processus automatisés que vous ne souhaitez pas interrompre. L’option Autoriser les automatisations WordPress courantes de Kinsta permet de préserver cette activité lorsque vous utilisez des niveaux de protection plus élevés.
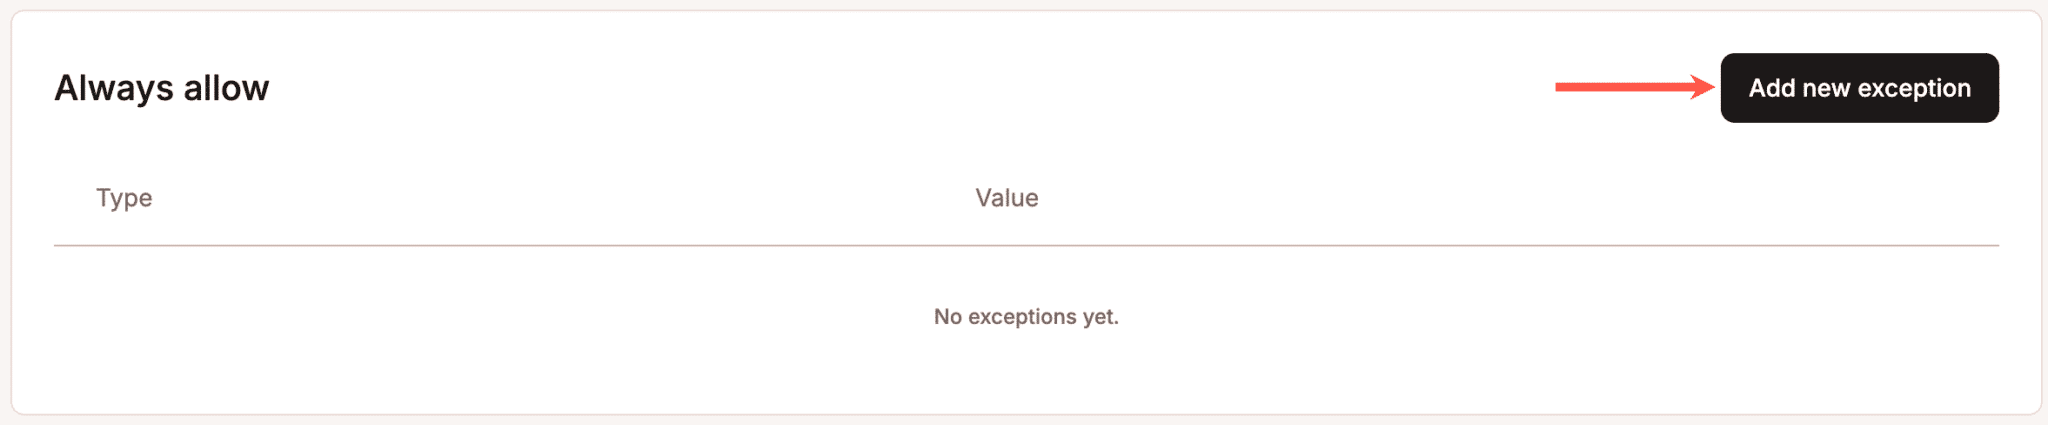
Pour tout ce qui nécessite un traitement plus spécifique, les exceptions Toujours autoriser vous permettent d’autoriser le trafic en fonction d’une adresse IP, d’un chemin d’accès ou d’un agent utilisateur.
Ensemble, ces contrôles vous offrent la possibilité d’adapter votre réponse à l’évolution du trafic. Vous pouvez maintenir le trafic utile lié à la recherche et à l’automatisation, restreindre l’accès aux robots d’indexation basés sur l’IA lorsque le compromis s’avère judicieux, et renforcer la protection lorsque l’activité automatisée commence à exercer une pression trop importante sur le site.
Vérifiez si votre équilibre fonctionne réellement
La protection contre les robots fonctionne mieux lorsqu’elle est gérée de manière continue, et non pas simplement comme une configuration ponctuelle. Après avoir ajusté la manière dont votre site gère le trafic automatisé, vous devez vérifier si cette modification améliore réellement les performances sans pour autant bloquer les canaux de découverte utiles.
Commencez par comparer ce qui se passe avant et après avoir effectué une modification. Examinez :
- Le volume de requêtes des robots d’indexation IA
- L’activité excessive des robots d’indexation IA
- Les chemins les plus sollicités
- Les requêtes autorisées, contestées et bloquées
- Les performances du site lors des pics d’activité des robots d’indexation
- Le trafic issu du référencement naturel
- Le trafic de référence provenant de l’IA, lorsque vous pouvez le mesurer
- Les conversions ou autres actions à valeur ajoutée générées par les visiteurs référés par l’IA
Kinsta vous propose plusieurs moyens d’analyser cette activité dans MyKinsta. La vue Répartition des requêtes regroupe les requêtes par catégories, notamment les robots vérifiés, les robots d’exploration IA, les robots d’exploration IA à fréquence excessive, le trafic automatisé et les robots potentiels. Le rapport Top traffic peut ensuite vous aider à identifier les chemins d’accès, les agents utilisateurs, les adresses IP et les pays qui génèrent le plus de requêtes.
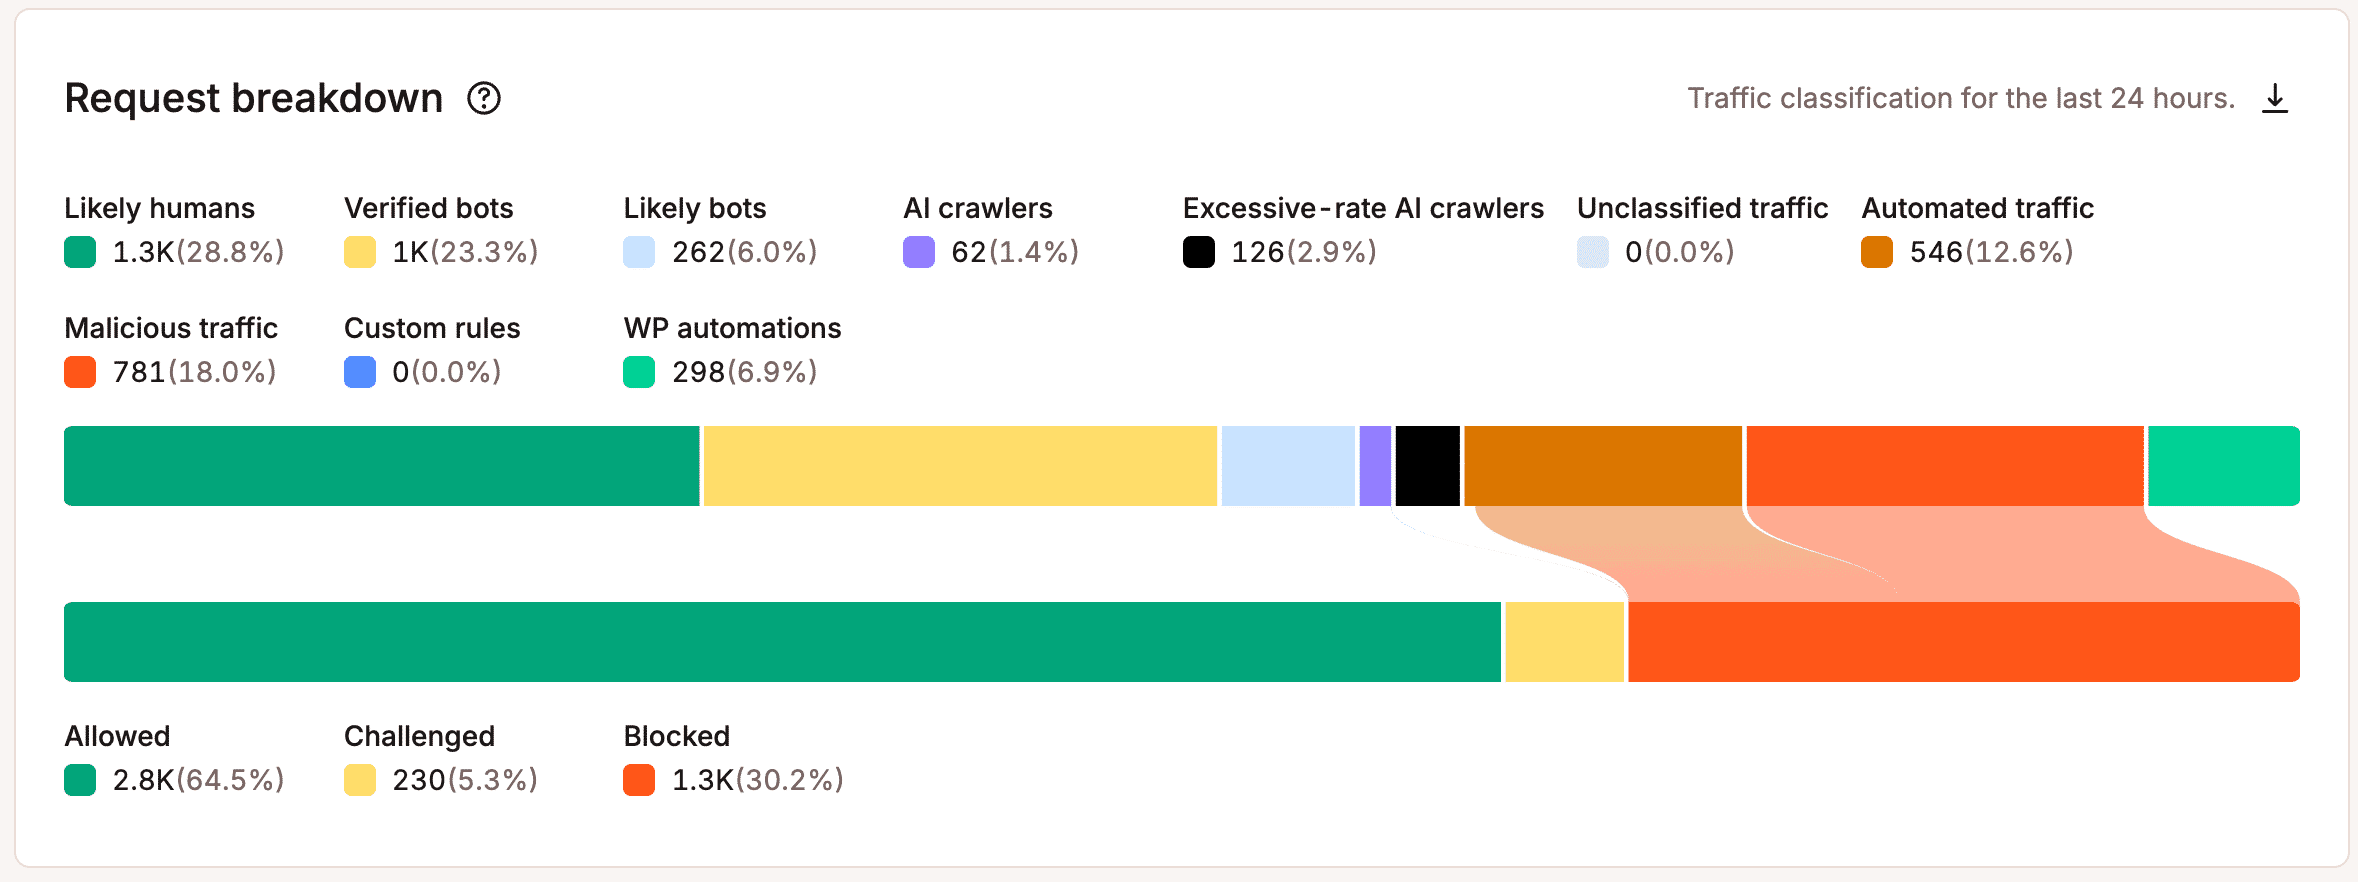
Ces vues s’avèrent particulièrement utiles après avoir modifié un niveau de protection ou bloqué une catégorie de robots d’indexation. Si la charge du serveur diminue alors que le trafic de recherche et les références provenant de l’IA restent stables, il se peut que cette modification produise exactement l’effet escompté. Si le trafic utile diminue en parallèle, vous avez alors une bonne raison de revoir ce réglage ou d’ajouter une exception plus ciblée.
Il en va de même lorsque les conditions évoluent. Un robot d’indexation qui pose peu de problèmes aujourd’hui peut augmenter son taux de requêtes ultérieurement, tandis qu’un canal de découverte par IA qui génère actuellement peu de trafic mesurable peut gagner en importance au fil du temps.
Un cycle simple s’avère efficace : observez, ajustez, comparez, puis conservez ou annulez la modification.
Les nouveaux contrôles IA de Cloudflare indiquent la direction que prend la gestion des robots
Les récentes modifications apportées par Cloudflare s’inscrivent dans la même stratégie globale : gérer le trafic automatisé en fonction de son comportement plutôt que d’appliquer la même règle à tous les robots d’IA.
En juillet 2026, Cloudflare a remplacé son approche unique des robots d’IA par des contrôles distincts pour le trafic de recherche, d’agent et d’entrainement . Les propriétaires de sites peuvent autoriser chaque catégorie, la bloquer sur l’ensemble du site ou la bloquer uniquement sur les pages affichant des publicités. À compter du 15 septembre, les nouveaux domaines utiliseront des réglages par défaut autorisant le trafic de recherche tout en bloquant les trafics « Agent » et « Formation » sur les pages comportant des publicités. Cloudflare modifie également la manière dont ses politiques s’appliquent aux robots à usages mixtes qui combinent des activités telles que la recherche et la formation.
Ce changement est important car il tient compte d’un problème auquel les propriétaires de sites sont déjà confrontés. Vous pouvez souhaiter qu’un robot d’exploration indexe votre contenu à des fins de découverte sans pour autant accorder à ce même opérateur un accès illimité pour l’entrainement de modèles. Un simple commutateur « robots IA » ne permet pas d’exprimer clairement cette préférence.
Si vous hébergez votre site chez Kinsta, veillez à ne pas superposer de protection supplémentaire contre les robots à celle qui est déjà en place. Si vous utilisez également votre propre configuration Cloudflare avec un WAF personnalisé ou des règles anti-robots, Cloudflare traite ces requêtes en premier. Dans certains cas, cela peut signifier que du trafic légitime est bloqué avant même que Kinsta ne le détecte.
Les modifications apportées par Cloudflare sont moins utiles en tant que nouvel ensemble de règles que chaque site WordPress devrait copier qu’en tant qu’indicateur de l’orientation future de la gestion des robots. L’approche binaire cède la place à des contrôles qui vous permettent de préserver le trafic automatisé utile tout en limitant les activités à faible valeur ajoutée.
Les agences ont besoin d’une politique, et non d’un réglage unique pour chaque client
Pour les agences, il n’existe pas de politique unique en matière de robots qui convienne à tous les clients. Un éditeur peut être disposé à autoriser davantage d’activité des robots d’indexation basés sur l’IA si cela facilite la découverte de son site, tandis qu’un site WooCommerce à fort trafic peut nécessiter des limites plus strictes lorsque ces requêtes commencent à entrer en concurrence avec les acheteurs pour les ressources du serveur.
Une étude de cas portant sur le travail réalisé avec Hall montre pourquoi ces différences sont importantes. L’un des clients WooCommerce de l’agence était confronté à des temps d’indisponibilité lors des pics de trafic avant de migrer vers Kinsta. À mesure que l’entreprise passait d’un chiffre d’affaires annuel de 3 millions de dollars à plus de 50 millions de dollars, la fiabilité des performances pendant les pics de demande devenait de plus en plus cruciale.
Les règles relatives aux robots doivent refléter le fonctionnement réel de chaque site. Déterminez quels robots d’indexation sont importants pour le client, lesquels exercent la plus forte pression sur le site et quels services automatisés doivent rester accessibles. Adaptez ensuite ces règles au fil du temps, à mesure que le trafic évolue et que les besoins du client changent en conséquence.
Contrôlez l’accès sans vous faire disparaitre
Vous n’avez pas à choisir entre rendre votre site visible aux systèmes d’IA et le protéger contre un trafic automatisé excessif. La question à se poser est plutôt de savoir quelle activité mérite d’avoir accès, dans quels cas cet accès est justifié, et quel est le cout pour votre site de répondre à cette demande.
Conservez le trafic issu des moteurs de recherche et de l’IA qui aide les internautes à trouver votre site, mais restez attentif à ce qui se passe une fois que ces robots d’indexation y accèdent. Si un bot commence à utiliser beaucoup de ressources sans apporter grand-chose en retour, vous pouvez limiter son accès. Veillez simplement à ne pas perturber les automatisations WordPress ou les autres services dont dépend votre site.
Ces décisions peuvent évoluer à mesure que le comportement des robots d’indexation, les schémas de référencement de l’IA et vos propres priorités changent. L’important est de disposer d’une visibilité suffisante pour observer ce qui se passe et d’un contrôle suffisant pour y réagir.
Découvrez-en davantage sur la protection contre les robots de Kinsta et consultez les conclusions de notre rapport sur le trafic généré par l’IA et les robots.
Carlo est un passionné de webdesign et de développement frontend. Il joue avec WordPress depuis plus de 10 ans, notamment en collaboration avec des universités et des établissements d'enseignement italiens et européens. Il a écrit des dizaines d'articles et de guides sur WordPress, publiés à la fois sur des sites web italiens et internationaux, ainsi que dans des magazines imprimés. Vous pouvez trouver Carlo sur X et LinkedIn.