Als bevorzugte Quelle bei Google hinzufügen
Wenn du möchtest, dass deine Website in der KI-Suche erscheint, scheint es naheliegend, Crawler zuzulassen. Wenn automatisierter Traffic jedoch zu viele Serverressourcen beansprucht, erscheint es ebenso sinnvoll, ihn zu blockieren. Das Problem besteht darin, diese beiden Optionen als sich gegenseitig ausschließend zu betrachten.
Du musst nicht jedem Bot denselben Zugriff gewähren. Manche Crawler helfen dabei, dass deine Inhalte in Such- oder KI-Ergebnissen erscheinen, während andere deine Website stark belasten, ohne viel zur Sichtbarkeit beizutragen. Sobald du weißt, welche welche sind, kannst du entscheiden, wo du den Zugriff offen hältst und wo du ihn einschränkst.
„KI-Crawler“ wird zu einer zu weit gefassten Kategorie
Nicht jeder KI-Crawler erfüllt dieselbe Aufgabe, daher kann eine pauschale Behandlung zu unnötigen Kompromissen zwischen Sichtbarkeit und Leistung führen.
Cloudflare unterteilt den KI-Traffic nun in drei große Kategorien:
- Such-Crawler indexieren Inhalte für zukünftige Suchergebnisse.
- Agenten-Traffic stammt von Tools, die in Echtzeit im Auftrag eines Nutzers agieren.
- Trainings-Crawler sammeln Inhalte, um KI-Modelle zu trainieren oder zu optimieren.
Die Zusammensetzung des Datentraffics zeigt, warum diese Unterscheidungen wichtig sind. Cloudflare berichtet, dass das KI-Training im Juni 2026 52 % der Crawler-Anfragen ausmachte, während Crawler mit gemischter Nutzung mehr als 36 % ausmachten. Das reine Such-Crawling macht einen geringeren Anteil aus, spielt aber dennoch eine wichtige Rolle für die Auffindbarkeit.
Die Identität eines Crawlers allein sagt auch nicht alles aus. Ein Unternehmen kann mehrere Bots für unterschiedliche Zwecke betreiben, und ein einzelner Crawler kann mehrere Funktionen erfüllen. Selbst verifizierte Bots können Leistungsprobleme verursachen, wenn das Anfragevolumen zu hoch wird.
Das macht pauschale Zulassungs- oder Sperrrichtlinien weniger sinnvoll. Wenn du in der Suche und bei der KI-gestützten Auffindbarkeit sichtbar bleiben willst, konzentriere dich darauf, was jeder Crawler tatsächlich tut und welchen Nutzen er bietet. Wenn du verstehst, wie sich KI-Crawler verhalten, hast du eine bessere Grundlage, um zu entscheiden, was du zulassen, einschränken oder überwachen solltest.
Frag dich zunächst, was der Crawler dir im Gegenzug bietet
Sobald du die Crawler nach ihrem Zweck unterschieden hast, lautet die nächste Frage: Was bringt dir ihre Aktivität im Gegenzug?
Automatisierter Traffic unterstützt traditionelle Suchrankings, KI-Zitate, Produktentdeckung, Empfehlungen und Recherchen, die in deinem Auftrag durchgeführt werden. Einige dieser Interaktionen können letztendlich Besucher auf deine Website leiten. Andere erhöhen möglicherweise die Sichtbarkeit, ohne einen Klick zu erzeugen, den du leicht messen kannst.
Der potenzielle Nutzen variiert erheblich. Die „Crawl-to-Referral“-Daten von Cloudflare zeigen, wie groß die Unterschiede sein können. Im Laufe des Jahres 2025 hat Anthropic manchmal Zehntausende von Seiten gecrawlt, um eine einzige Weiterleitung an eine Website zu generieren. Das Verhältnis bei OpenAI lag im Allgemeinen im vierstelligen Bereich, während Perplexity oft unter einigen Hundert Crawls pro Weiterleitung blieb.
Diese Zahlen ändern sich im Laufe der Zeit, daher eignen sie sich eher als Beleg für die Unterschiede denn als dauerhaftes Ranking der KI-Plattformen. Außerdem erfassen sie nicht jede Form von Wert. Cloudflare weist darauf hin, dass der Traffic von nativen KI-Apps möglicherweise keinen herkömmlichen „Referer“-Header enthält, was bedeutet, dass manche Besuche nicht der Plattform zugeordnet werden. KI-Verweise können eine Marke oder einen Inhalt auch Nutzern präsentieren, die niemals darauf klicken.
Dennoch bleibt die grundlegende Frage sinnvoll: Was bekommst du im Gegenzug für die Anfragen, die deine Website bedient?
Du kannst dieses Verhältnis anhand einiger Faktoren bewerten:
| Frage | Was du erreichen möchtest |
| Unterstützt der Crawler die Suche oder die KI-Entdeckung? | Mögliche Sichtbarkeit |
| Bringt er messbaren Referral-Traffic? | Direkter Ertrag |
| Welche Seiten oder Endpunkte ruft er ab? | Infrastrukturkosten |
| Wie oft wird gecrawlt? | Auswirkungen auf den Betrieb |
| Löst ein Nutzer die Anfrage aus? | Unmittelbarer Nutzen für den Nutzer |
| Würde das Blockieren einen wichtigen Entdeckungskanal wegnehmen? | Risiko für die Sichtbarkeit |
Zehntausend Crawler-Anfragen haben nicht denselben Wert, nur weil sie von automatisierten Systemen stammen. Wenn du sowohl den Nutzen als auch die Kosten betrachtest, hast du eine bessere Grundlage, um zu entscheiden, welchen Datentraffic du beibehalten solltest.
Schütze teure Anfragen, anstatt den gesamten Bot-Traffic als gleichermaßen schädlich zu behandeln
Die Art des Crawlers spielt eine Rolle, aber ebenso wichtig ist, was er anfordert, sobald er deine Website erreicht. Ein Bot, der regelmäßig zwischengespeicherte Artikel lädt, verursacht eine ganz andere Arbeitslast als einer, der wiederholt auf WordPress-Suchergebnisse, gefilterte Produktseiten, Warenkorb- und Checkout-URLs, REST-API-Endpunkte oder URLs mit wechselnden Abfrageparametern zugreift. Diese Anfragen können dazu führen, dass WordPress eine neue Antwort generieren muss, anstatt Inhalte aus dem Cache bereitzustellen.
Dieser Unterschied summiert sich schnell. In Kinstas Analyse der Bot-Aktivitäten erzeugte automatisierter Traffic innerhalb eines einzigen 24-Stunden-Zeitraums 7,67 Millionen Anfragen an „In den Warenkorb“-URLs. Davon entfielen 3,75 Millionen auf ClaudeBot. Das Problem war nicht einfach, dass ein KI-Crawler die Seiten besuchte. Es lag vielmehr daran, dass Millionen von Anfragen auf dynamische URLs abzielten, bei denen jeder Besuch potenziell mehr Arbeit für die Anwendung bedeutete.
Wir haben den Zusammenhang zwischen Bot-Traffic und der Auslastung von WordPress-Servern an anderer Stelle bereits ausführlicher behandelt, ebenso wie die Infrastrukturkosten, die durch übermäßigen automatisierten Traffic entstehen können. Der wichtige Punkt hierbei ist, dass der Zugriff durch Crawler nicht zwangsläufig einen gleichberechtigten Zugriff auf jeden Teil einer Website bedeuten muss.
Es kann sinnvoll sein, einen KI-Dienst einen öffentlichen Artikel oder eine Produktseite lesen zu lassen, wenn das dazu beiträgt, dass deine Inhalte in Such- oder KI-Ergebnissen erscheinen. Es bringt jedoch kaum einen Vorteil, denselben Crawler wiederholt auf Warenkorb-URLs, interne Suchseiten oder andere Teile der Website zugreifen zu lassen, deren Laden aufwendig ist und die die Auffindbarkeit nicht verbessern.
Das eröffnet dir eine weitere Perspektive beim Thema Bot-Schutz. Anstatt dich nur zu fragen, welche Crawler du blockieren solltest, frag dich auch, welche Anfragen es wert sind, bedient zu werden.
Richte deine Bot-Richtlinie auf den Traffic aus, den du erhalten möchtest
Sobald du weißt, welche Anfragen deine Website am stärksten belasten, fällt es dir leichter zu entscheiden, was du zulassen und was du einschränken solltest. Eine einzige Zulassungs- oder Sperrliste reicht meist nicht aus, da verschiedene Crawler unterschiedliche Zwecke erfüllen und nicht alle den gleichen Nutzen bringen.
Herkömmliche Such-Crawler
In der Regel wirst du legitime Such-Crawler wie Googlebot und Bingbot zulassen wollen. Sie sind nach wie vor wichtig für die organische Suche, und dieselben Suchindizes werden auch genutzt, um zunehmend KI-gesteuerte Sucherlebnisse zu ermöglichen.
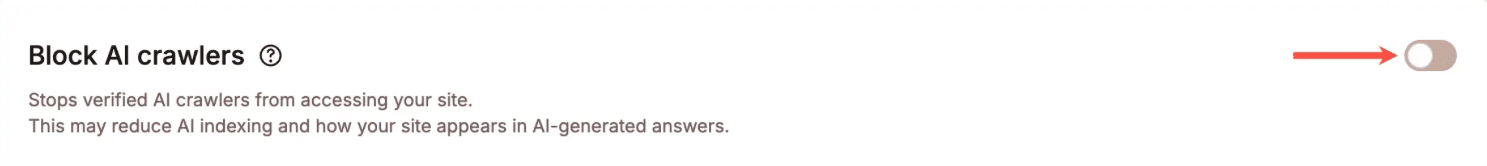
Kinsta behandelt große Such-Crawler als verifizierte Bots, und die Einstellung KI-Crawler blockieren blockiert weder Googlebot noch Bingbot. Diese Unterscheidung ist sehr hilfreich, denn den Schutz deiner Website vor KI-Crawler-Traffic bedeutet nicht automatisch, dass sie aus der traditionellen Suche entfernt wird.
KI-Such- und Abruf-Crawler
Wenn KI-Sichtbarkeit für dein Unternehmen wichtig ist, verdienen Such- und Abruf-Crawler eine andere Vorgehensweise als Bots, die in erster Linie Trainingsdaten sammeln.
Diese Crawler können auf aktuelle Inhalte zugreifen, damit KI-Tools Fragen beantworten, Recherchen durchführen, Produkte empfehlen oder Nutzer auf nützliche Seiten hinweisen können. Ihnen den Zugriff zu erlauben, garantiert zwar keine Nennung oder Weiterleitung, aber sie zu blockieren kann eine der Möglichkeiten ausschließen, wie ein KI-System deine neuesten Inhalte findet oder abruft.
Für Websites, die aktiv nach Sichtbarkeit in der KI-Suche streben, ist es sinnvoll, diesen Traffic dort zuzulassen, wo er einen Mehrwert bietet, und zu beobachten, wie er sich verhält.
Trainings-Crawler
Das Training von Crawlern bringt einen anderen Kompromiss mit sich. Sie sammeln Inhalte, um Modelle zu trainieren oder zu verfeinern, daher hat ihre Aktivität einen weniger direkten Einfluss darauf, ob jemand deinen neuesten Artikel oder dein neuestes Produkt über die KI-Suche finden kann.
Das bedeutet nicht, dass jede Website sie automatisch blockieren sollte. Deine Entscheidung hängt möglicherweise davon ab, wie viel sie crawlen, welche Ressourcen diese Anfragen verbrauchen, wie deine Content-Strategie aussieht und ob du möchtest, dass deine Inhalte für die Modellentwicklung genutzt werden.
Wenn Trainings-Traffic eine erhebliche Belastung verursacht, dabei aber kaum messbaren oder strategischen Nutzen bringt, lässt sich eine Einschränkung leichter rechtfertigen.
Unbekannter oder übermäßiger automatisierter Traffic
Selbst ein legitimer Crawler kann zum Problem werden, wenn seine Anfragerate hoch genug wird.
Der Bot-Schutz von Kinsta unterscheidet zwischen KI-Crawlern mit übermäßiger Anfragerate und normalem KI-Crawler-Traffic. Dazu gehören auch verifizierte Crawler, wenn ihre Aktivität ein Ausmaß erreicht, das die Website-Leistung beeinträchtigen könnte. Je nach der von dir gewählten Schutzstufe kann Kinsta diesen Traffic überprüfen, anstatt die Verifizierung als dauerhafte Erlaubnis für unbegrenzte Anfragen zu betrachten.
Deine Crawler-Regeln können sich mit dem Traffic ändern. Vielleicht ist es für dich in Ordnung, bestimmte Bots die meiste Zeit zuzulassen, den Zugriff dann aber zu verschärfen, wenn sie zu viele Ressourcen verbrauchen oder die Website-Leistung beeinträchtigen.
Kinsta bietet dir mehrere Einstellungsmöglichkeiten, nicht nur einen einfachen KI-Ein-/Aus-Schalter
Eine selektive Bot-Richtlinie funktioniert am besten, wenn du anpasst, wie deine Website mit verschiedenen Arten von automatisiertem Datentraffic umgeht. Der Bot-Schutz von Kinsta bietet dir dafür mehrere Einstellungsmöglichkeiten, anstatt die Entscheidung auf eine einzige „Zulassen-oder-Blockieren“-Einstellung zu reduzieren.
Kinsta bietet vier Schutzstufen:
- Bösartigen Datentraffic blockieren blockiert bekannte bösartige Anfragen, während anderer Traffic durchgelassen wird.
- Automatisierungen blockieren fügt Einschränkungen für bestätigten automatisierten Datentraffic hinzu.
- Bots herausfordern wendet eine Überprüfung auf Datentraffic an, den Kinsta als automatisiert oder wahrscheinlich automatisiert identifiziert.
- Alle herausfordern wendet die strengste Schutzstufe an und fordert alle Besucher zur Überprüfung auf.
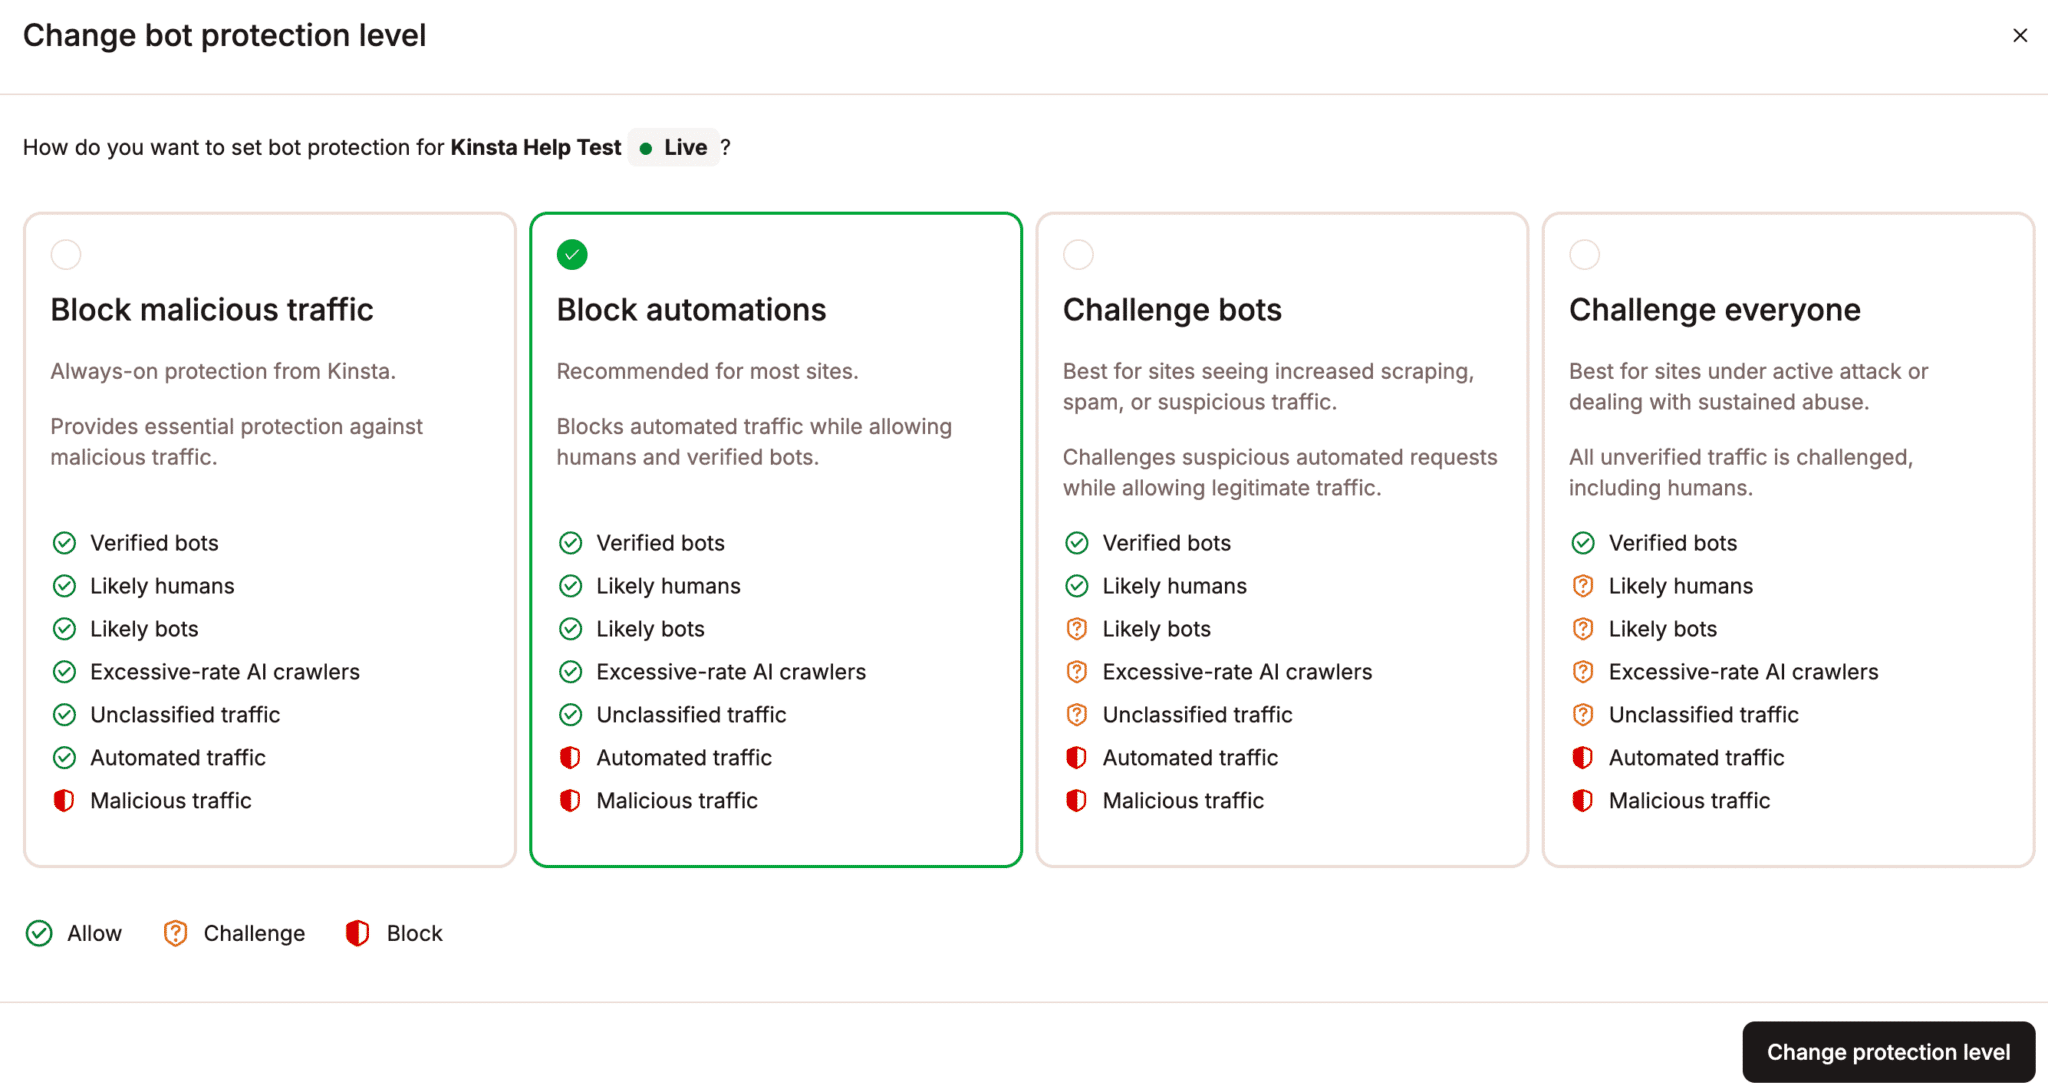
Mit diesen Stufen kannst du die Durchsetzung verschärfen, wenn Bot-Traffic zum Problem wird, ohne manuell Regeln für jeden Crawler oder User-Agent erstellen zu müssen.
Wie bereits erwähnt, bietet Kinsta außerdem eine separate Einstellung zum Blockieren von KI-Crawlern. Wenn diese aktiviert ist, werden unterstützte KI-Crawler – einschließlich verifizierter KI-Crawler – blockiert, Googlebot und Bingbot jedoch nicht. So kannst du bestimmte KI-spezifische Crawling-Aktivitäten einschränken, ohne deine Website von der herkömmlichen Suche abzuschneiden.
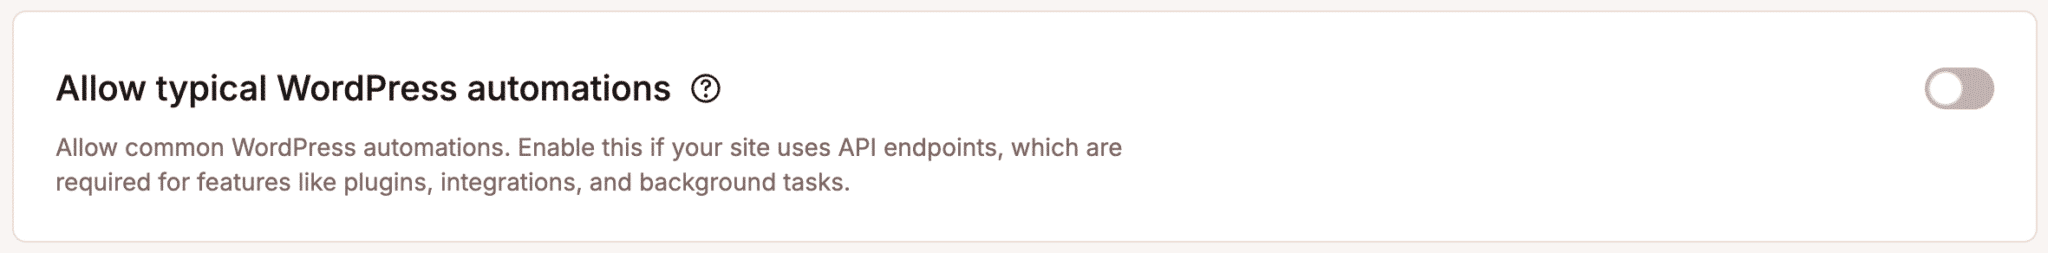
Ein strengerer Schutz wirft jedoch ein weiteres Problem auf: legitime Automatisierung. WordPress-Websites sind auf geplante Aufgaben, REST-API-Anfragen, Plugin-Integrationen, Zahlungsdienste, Überwachungstools und andere automatisierte Prozesse angewiesen, die du nicht unterbrechen möchtest. Die Option Typische WordPress-Automatisierungen zulassen von Kinsta hilft dabei, diese Aktivitäten aufrechtzuerhalten, wenn du stärkere Schutzstufen verwendest.
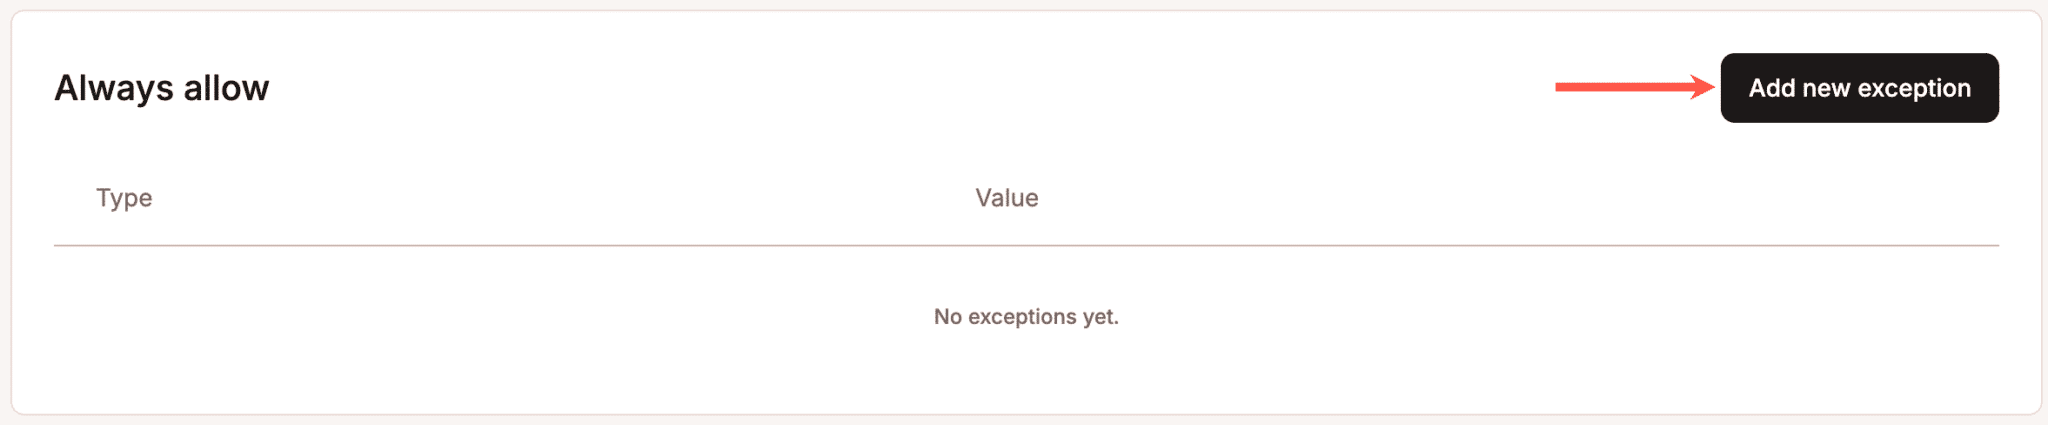
Für alles, was eine spezifischere Behandlung erfordert, kannst du mit den Ausnahmen unter Immer zulassen Traffic basierend auf einer IP-Adresse, einem Pfad oder einem User-Agent zulassen.
Zusammen geben dir diese Einstellungsmöglichkeiten Spielraum, deine Reaktion an veränderte Zugriffsmuster anzupassen. Du kannst nützlichen Such- und Automatisierungsdatentraffic zulassen, KI-Crawler einschränken, wenn sich das lohnt, und den Schutz erhöhen, wenn automatisierte Aktivitäten die Website zu sehr belasten.
Prüfe, ob dein Gleichgewicht tatsächlich funktioniert
Der Bot-Schutz funktioniert am besten als fortlaufender Prozess und nicht nur als einmalige Konfiguration. Nachdem du angepasst hast, wie deine Website mit automatisiertem Traffic umgeht, musst du überprüfen, ob die Änderung tatsächlich die Leistung verbessert, ohne nützliche Entdeckungskanäle zu unterbinden.
Vergleiche zunächst, was vor und nach einer Änderung passiert. Achte dabei auf:
- Anfragevolumen von KI-Crawlern
- Aktivitäten von KI-Crawlern mit übermäßiger Zugriffsrate
- Am häufigsten angeforderte Pfade
- Zulässige, angefochtene und blockierte Anfragen
- Leistung der Website bei Crawler-Spitzen
- Organischer Suchtraffic
- AI-Verweistraffic, den du messen kannst
- Conversions oder andere wertvolle Aktionen von durch KI weitergeleiteten Besuchern
Kinsta bietet dir in MyKinsta mehrere Möglichkeiten, diese Aktivitäten zu untersuchen. Die Ansicht Anforderungsaufschlüsselung gruppiert Anfragen in Kategorien, darunter verifizierte Bots, KI-Crawler, KI-Crawler mit übermäßiger Zugriffsrate, automatisierter Traffic und wahrscheinliche Bots. Der Bericht Top-Traffic hilft dir dann dabei, festzustellen, welche Pfade, User-Agents, IP-Adressen und Länder die meisten Anfragen generieren.
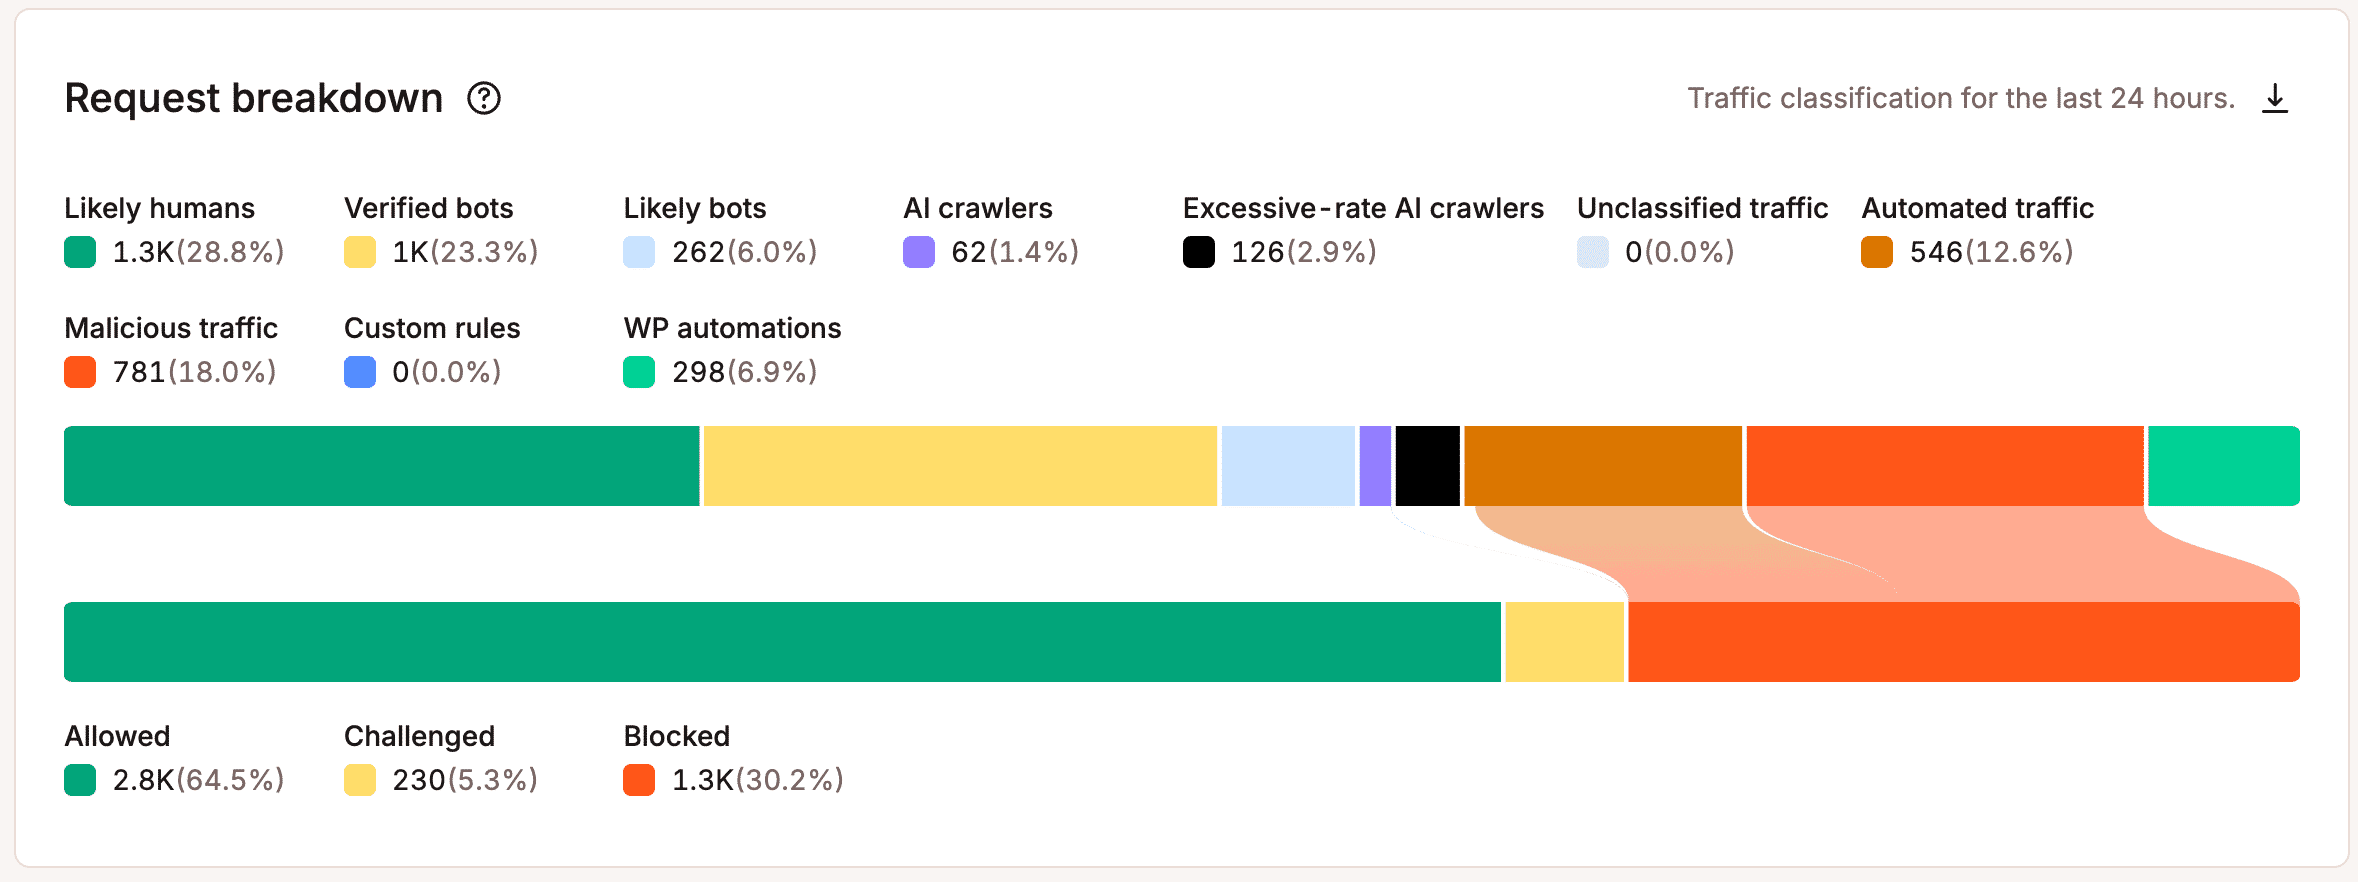
Diese Ansichten sind besonders nützlich, nachdem du eine Schutzstufe geändert oder eine Kategorie von Crawlern blockiert hast. Wenn die Serverauslastung sinkt, während Suchtraffic und KI-Verweise stabil bleiben, bewirkt die Änderung möglicherweise genau das, was du beabsichtigt hast. Wenn nützlicher Traffic ebenfalls abnimmt, hast du einen Grund, die Einstellung zu überprüfen oder eine gezieltere Ausnahme hinzuzufügen.
Das Gleiche gilt, wenn sich die Bedingungen ändern. Ein Crawler, der heute kaum Probleme verursacht, könnte später seine Anfragerate erhöhen, während ein KI-Entdeckungskanal, der derzeit nur wenig messbaren Traffic sendet, mit der Zeit an Wert gewinnen könnte.
Ein einfacher Zyklus funktioniert gut: Beobachten, anpassen, vergleichen und dann die Änderung beibehalten oder rückgängig machen.
Die neuen KI-Steuerungsfunktionen von Cloudflare zeigen, wohin die Entwicklung im Bot-Management geht
Die jüngsten Änderungen bei Cloudflare deuten auf dieselbe übergreifende Strategie hin: automatisierten Traffic basierend auf seinem Verhalten zu verwalten, anstatt auf jeden KI-Crawler dieselbe Regel anzuwenden.
Im Juli 2026 ersetzte Cloudflare seinen einheitlichen KI-Bot-Ansatz durch separate Steuerungsmöglichkeiten für Such-, Agent- und Trainings-Traffic. Websites-Betreiber können jede Kategorie zulassen, sie auf der gesamten Website blockieren oder nur auf Seiten sperren, auf denen Anzeigen geschaltet werden. Ab dem 15. September gelten für neue Domains Standardeinstellungen, die Suchtraffic zulassen, während Agent- und Trainingstraffic auf Seiten mit Anzeigen blockiert wird. Cloudflare ändert außerdem, wie seine Richtlinien auf Crawler mit gemischten Zwecken angewendet werden, die Aktivitäten wie Suche und Training kombinieren.
Die Änderung ist wichtig, weil sie ein Problem berücksichtigt, mit dem Websites-Betreiber bereits konfrontiert sind. Möglicherweise möchtest du, dass ein Crawler Inhalte zur Erfassung indexiert, ohne demselben Betreiber uneingeschränkten Zugriff für das Modelltraining zu gewähren. Ein einziger Schalter für „KI-Bots“ kann diese Präferenz nicht besonders gut widerspiegeln.
Wenn du bei Kinsta hostest, solltest du vorsichtig sein, wenn du zusätzlichen Bot-Schutz über die bereits vorhandenen Maßnahmen legst. Wenn du zusätzlich deine eigene Cloudflare-Konfiguration mit benutzerdefinierten WAF- oder Bot-Regeln nutzt, verarbeitet Cloudflare diese Anfragen zuerst. In manchen Fällen kann das bedeuten, dass legitimer Datentraffic blockiert wird, bevor Kinsta ihn überhaupt sieht.
Die Änderungen bei Cloudflare sind weniger als neuer Regelkatalog nützlich, den jede WordPress-Website kopieren sollte, sondern vielmehr als Hinweis darauf, in welche Richtung sich das Bot-Management entwickelt. Der binäre Ansatz weicht zunehmend Steuerungsmöglichkeiten, mit denen du nützlichen automatisierten Datentraffic beibehalten und gleichzeitig Aktivitäten einschränken kannst, die weniger Wert bieten.
Agenturen brauchen eine Richtlinie, nicht eine Einheitslösung für jeden Kunden
Für Agenturen gibt es keine einheitliche Bot-Richtlinie, die für jeden Kunden funktioniert. Ein Publisher ist vielleicht bereit, mehr Aktivitäten von KI-Crawlern zuzulassen, wenn dies der Sichtbarkeit dient, während eine stark frequentierte WooCommerce-Website strengere Beschränkungen benötigt, wenn diese Anfragen mit den Käufern um Serverressourcen konkurrieren.
Eine Fallstudie zur Zusammenarbeit mit Hall zeigt, warum diese Unterschiede wichtig sind. Einer der WooCommerce-Kunden der Agentur hatte vor dem Wechsel zu Kinsta mit Ausfallzeiten bei Traffic-Spitzen zu kämpfen. Als das Unternehmen von 3 Millionen Dollar auf über 50 Millionen Dollar Jahresumsatz wuchs, wurde eine zuverlässige Leistung in Spitzenzeiten immer wichtiger.
Bot-Regeln sollten widerspiegeln, wie jede Website tatsächlich funktioniert. Finde heraus, welche Crawler für den Kunden wichtig sind, welche die Website am stärksten belasten und welche automatisierten Dienste weiterhin zugänglich bleiben müssen. Passe die Regeln dann im Laufe der Zeit an, wenn sich der Traffic ändert und sich damit auch die Bedürfnisse des Kunden ändern.
Zugriff kontrollieren, ohne zu verschwinden
Du musst dich nicht entscheiden zwischen der Sichtbarkeit deiner Website für KI-Systeme und dem Schutz vor übermäßigem automatisiertem Traffic. Die bessere Frage ist, welche Aktivitäten Zugriff verdienen, wo dieser Zugriff sinnvoll ist und was es deine Website kostet, diesen zu gewähren.
Behalte den Such- und KI-Traffic bei, der Menschen hilft, deine Website zu finden, aber achte darauf, was passiert, sobald diese Crawler dort ankommen. Wenn ein Bot anfängt, viele Ressourcen zu verbrauchen, ohne viel Nutzen zu bringen, kannst du seinen Zugriff einschränken. Achte nur darauf, dass du dabei keine WordPress-Automatisierungen oder andere Dienste beeinträchtigst, auf die deine Website angewiesen ist.
Diese Entscheidungen können sich ändern, wenn sich das Verhalten von Crawlern, die KI-Verweis-Muster und deine eigenen Prioritäten weiterentwickeln. Wichtig ist, dass du genügend Einblick hast, um zu sehen, was passiert, und genügend Kontrolle, um darauf zu reagieren.
Erfahre mehr über den Kinsta-Bot-Schutz und schau dir die Ergebnisse in unserem KI- & Bot-Traffic-Bericht an.
Carlo ist ein leidenschaftlicher Liebhaber von Webdesign und Frontend-Entwicklung. Er beschäftigt sich seit über 10 Jahren mit WordPress, auch in Zusammenarbeit mit italienischen und europäischen Universitäten und Bildungseinrichtungen. Er hat Dutzende von Artikeln und Leitfäden über WordPress geschrieben, die sowohl auf italienischen und internationalen Websites als auch in gedruckten Magazinen veröffentlicht wurden. Du kannst Carlo auf X und LinkedIn finden.