Añádelo como fuente preferida en Google
Cuando descubres que una gran parte del tráfico de tu web viene de bots, bloquearlos puede parecer el siguiente paso lógico. En algunos casos, las cifras sí que exigen una respuesta inmediata.
PatronView ha registrado recientemente 3,6 millones de solicitudes en su sitio web en un solo día, con tráfico procedente de más de 360.000 direcciones IP. El propietario del sitio acabó creando un conjunto bastante estricto de reglas de Cloudflare para controlar el tráfico.
También hemos visto casos extremos en nuestra propia infraestructura. En nuestro informe sobre tráfico de IA y bots, un rastreador generó 3,75 millones de solicitudes a URLs de añadir al carrito en 24 horas. Otro patrón de bucle repetitivo generó cientos de millones de solicitudes antes de que introdujéramos una regla para detectarlo.
Esos casos son reales, pero no son representativos de todos los sitios web.
En nuestro último análisis de más de 5.000 sitios de WordPress, los bots de IA representaban solo el 1,57 % del ancho de banda en el sitio mediano, frente al 17,8 % en el percentil 90 y el 90,3 % en el 99, mientras que más de 1.000 sitios no registraron ningún consumo de ancho de banda por parte de bots de IA.
Esa diferencia es la razón por la que detectar el tráfico de bots de IA y diagnosticar un problema relacionado con ellos son dos cosas distintas.
Las decisiones que tomes a continuación pueden afectar al rendimiento del sitio, a las integraciones, a la visibilidad en los buscadores y a que las herramientas de IA puedan mostrar tu contenido. Antes de cambiar nada, tienes que saber qué están haciendo realmente los bots.
Estos son algunos de los errores que vemos que cometen los propietarios de sitios web cuando se saltan ese paso.
Error 1: considerar el porcentaje como el diagnóstico
Si los rastreadores de IA representan el 20 % de las solicitudes de tu sitio web, esa cifra por sí sola no te indica si hay un problema.
Una gran parte de las solicitudes a artículos almacenados en la caché puede suponer una carga relativamente pequeña para la aplicación, mientras que un número menor de solicitudes que acceden repetidamente a resultados de búsqueda, páginas de productos filtradas o URLs del carrito puede generar mucho más trabajo.
Esta es una de las razones por las que hay que tener cuidado al aplicar las estadísticas de bots de toda la red a un sitio concreto.
Nuestra última investigación reveló que el número medio de solicitudes de bots de IA por sitio web oscilaba entre 667 y 928 al día en las cuatro mediciones realizadas, frente a una mediana de tan solo entre 33 y 67 solicitudes, mientras que entre el 20 % y el 27 % de los sitios web no recibieron ninguna solicitud de bots de IA en los días analizados.
En otras palabras, un pequeño grupo de sitios web con un alto número de rastreos hace que la media suba.
Así que, si lees que los bots representan más de la mitad del tráfico web, o ves que el propietario de otro sitio web afirma que el 99 % de su tráfico son bots, no utilices esa cifra para decidir qué necesita tu propio sitio web.
Empieza por tu propio tráfico.
Para los clientes de Kinsta, la sección Protección contra bots de MyKinsta muestra cómo se clasifican las solicitudes, incluyendo usuarios probablemente humanos, bots verificados, probablemente bots, rastreadores de IA, rastreadores de IA con frecuencia excesiva, tráfico automatizado y tráfico malicioso.
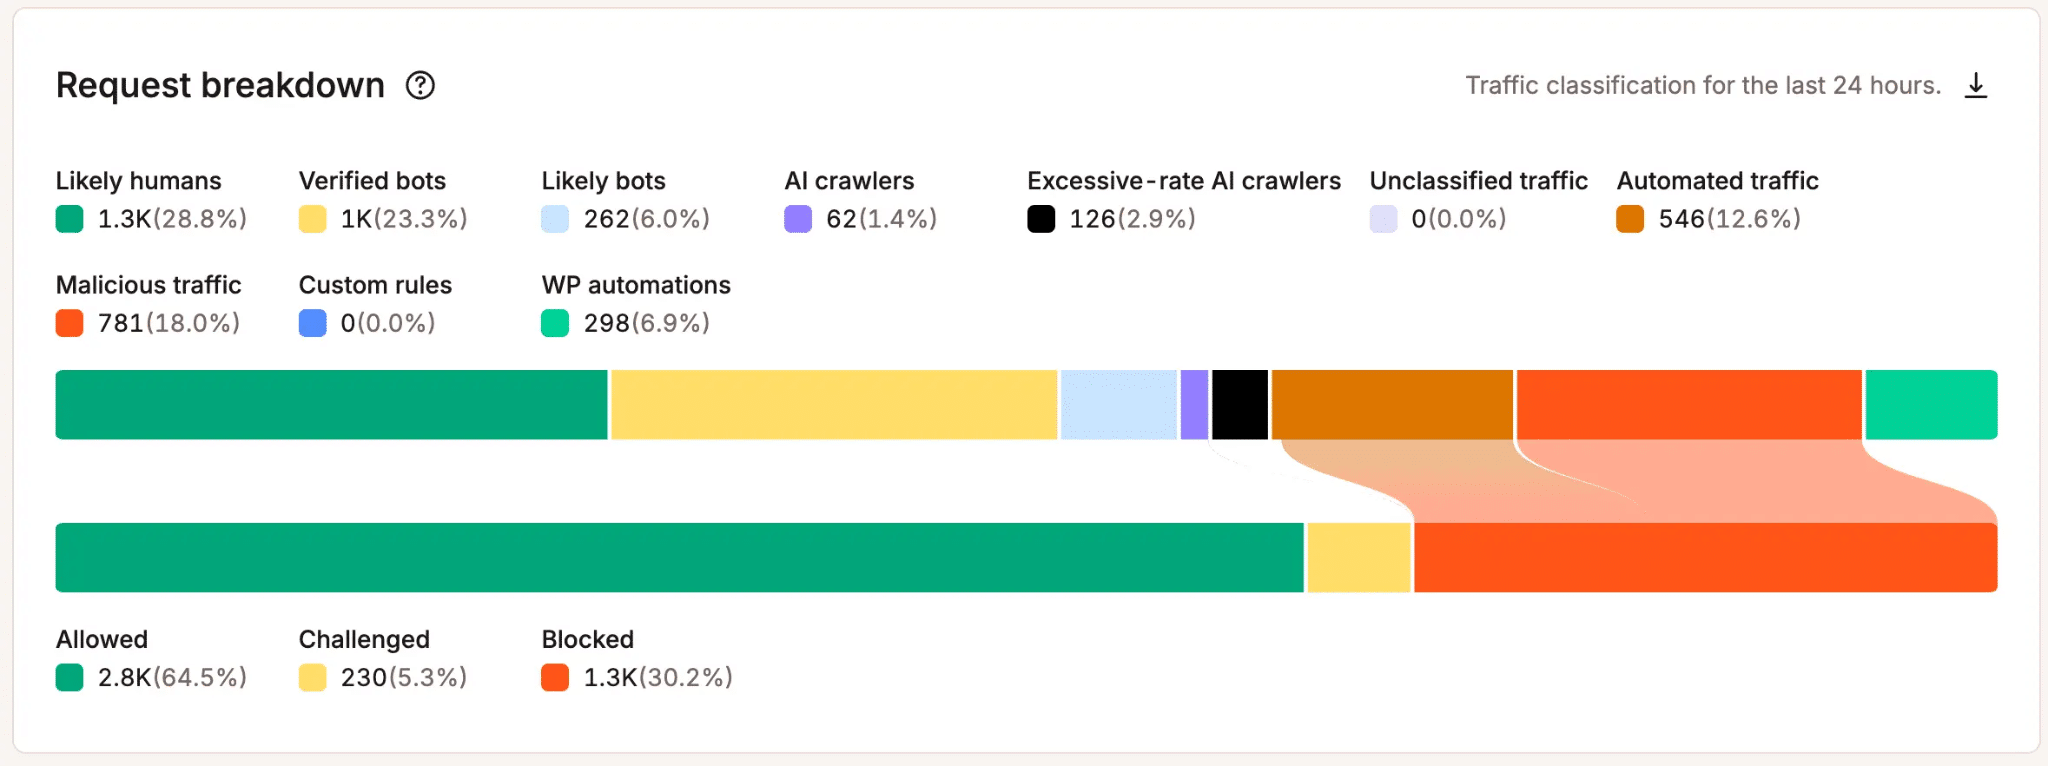
A continuación, puedes usar Tráfico principal para ver las rutas, los agentes de usuario, los países y las direcciones IP que hay detrás de un tipo de tráfico específico.
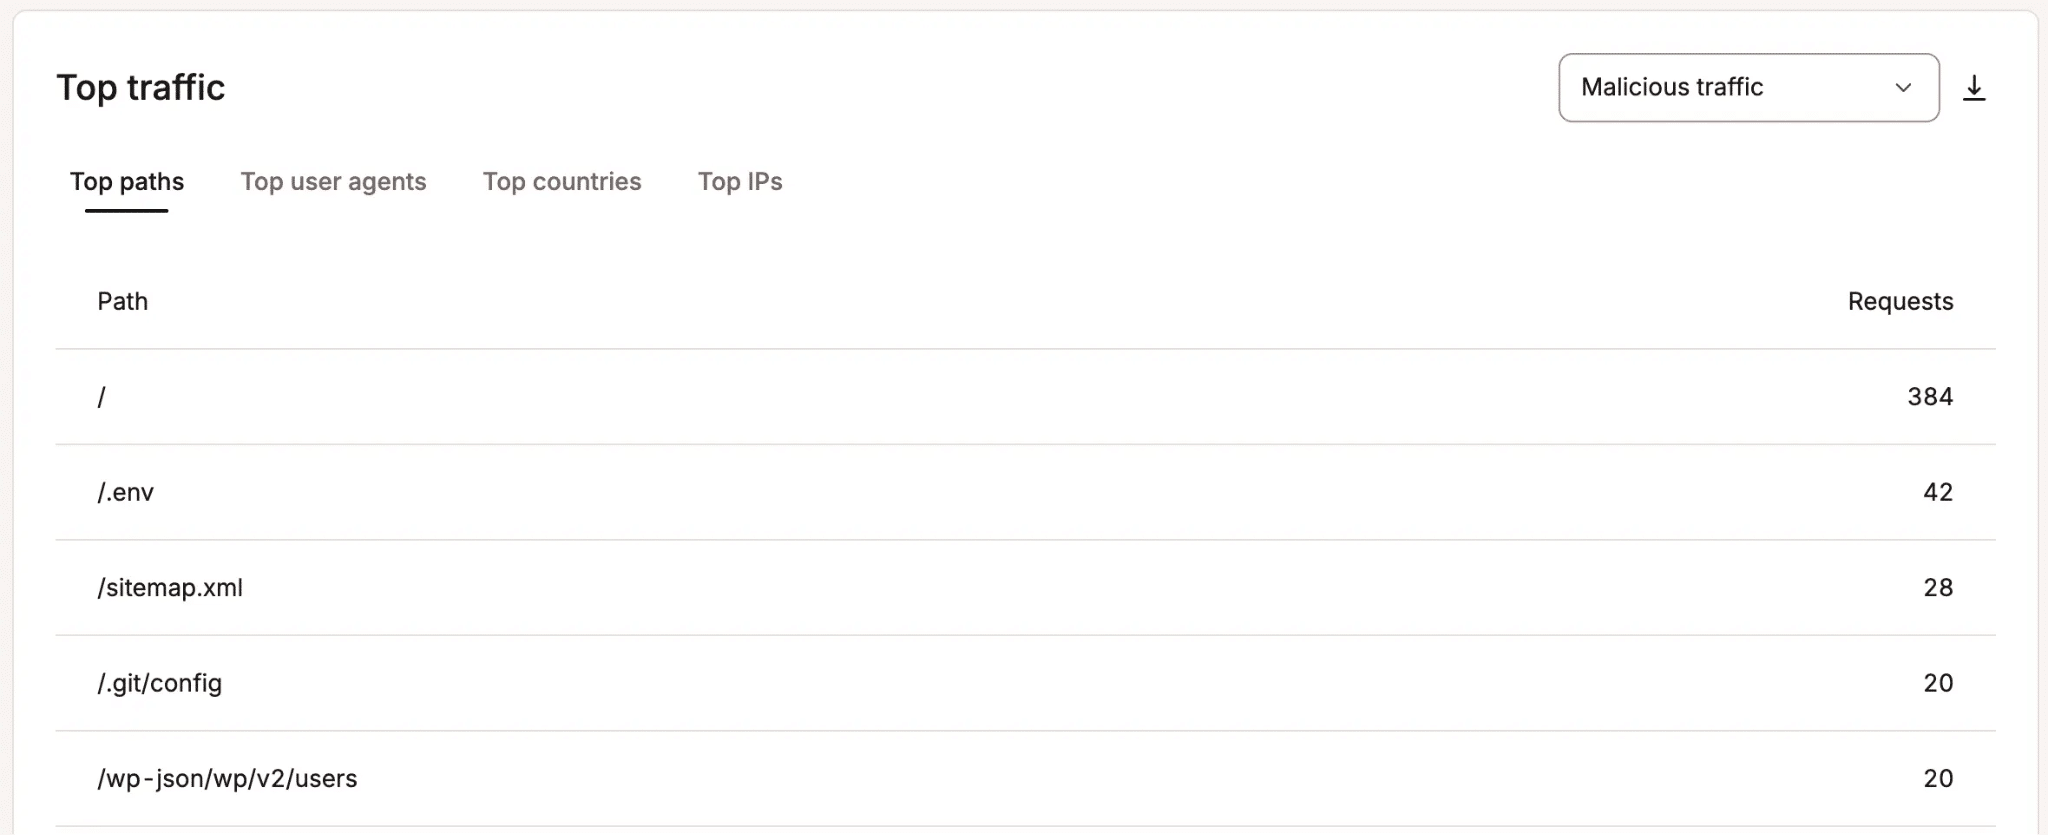
Antes de tomar medidas, deberías poder responder a unas cuantas preguntas básicas:
- ¿Cuánto tráfico de IA llega realmente al sitio?
- ¿Qué páginas o endpoints está solicitando?
- ¿Qué rastreadores, agentes u otros sistemas automatizados son los responsables?
- ¿Afecta parte de ese tráfico al rendimiento, al ancho de banda, a los hilos PHP o a la experiencia de los visitantes reales?
Nuestro último informe aborda esto analizando la posición, el patrón y el perfil del tráfico. Es posible que un sitio que reciba muy poco tráfico de IA con un comportamiento normal en las solicitudes no necesite ninguna medida, mientras que uno que registre un tráfico constante de rastreadores dirigido a URLs dinámicas costosas merezca un análisis mucho más detallado.
Error 2: bloquear todos los bots porque el tráfico es automatizado
El término bot de IA ahora abarca varios tipos de tráfico diferentes. Algunos rastreadores recopilan contenido público para entrenar modelos o para búsquedas con IA, mientras que otros recogen páginas en respuesta a la solicitud de un usuario.
Esas diferencias son importantes a la hora de decidir qué permitir. OpenAI, por ejemplo, utiliza GPTBot para contenidos que pueden servir para mejorar sus modelos, mientras que OAI-SearchBot ayuda a que los sitios web sean visibles en la búsqueda de ChatGPT. Por lo tanto, bloquear OAI-SearchBot puede afectar a que tu contenido aparezca o no en los resultados de búsqueda de ChatGPT.
Anthropic hace una distinción similar. ClaudeBot recopila contenido web que puede contribuir al entrenamiento de modelos, Claude-SearchBot se utiliza para la búsqueda y Claude-User puede recuperar un sitio web cuando alguien que usa Claude lo solicita.
Perplexity informa de que PerplexityBot se utiliza para su índice de búsqueda y Perplexity-User para las consultas que se realizan en respuesta a las preguntas de los usuarios.
Google ofrece a los editores un control independiente en Google-Extended sobre cómo se puede utilizar el contenido rastreado con Gemini. Google afirma explícitamente que cambiar esa configuración no afecta a la inclusión ni al posicionamiento en la Búsqueda de Google.
Si metes todos estos sistemas en el mismo saco de la «IA», estás desperdiciando información que podrías aprovechar.
Si prefieres no gastar recursos del sitio en el entrenamiento de modelos, puedes optar por restringir el acceso a los rastreadores de entrenamiento, dejando accesibles los sistemas de búsqueda y recuperación. Si tu problema es que un agente de IA accede repetidamente a un endpoint dinámico, es posible que cambiar la política de los rastreadores de entrenamiento no lo resuelva.
Aquí también hay una cuestión empresarial. Nuestro estudio de mercado reveló que el 44,7 % de los encuestados dijo que siempre o casi siempre visita la web de una empresa después de recibir una recomendación de la IA. Eso no significa que el acceso de los rastreadores de la IA genere automáticamente tráfico de referencia, pero sí que merece la pena tener en cuenta el descubrimiento mediante IA antes de tomar una decisión general sobre la visibilidad.
En Kinsta, la opción Bloquear rastreadores de IA te permite bloquear los rastreadores de IA, incluso los verificados, sin bloquear los rastreadores tradicionales de los motores de búsqueda, como Googlebot y Bing.
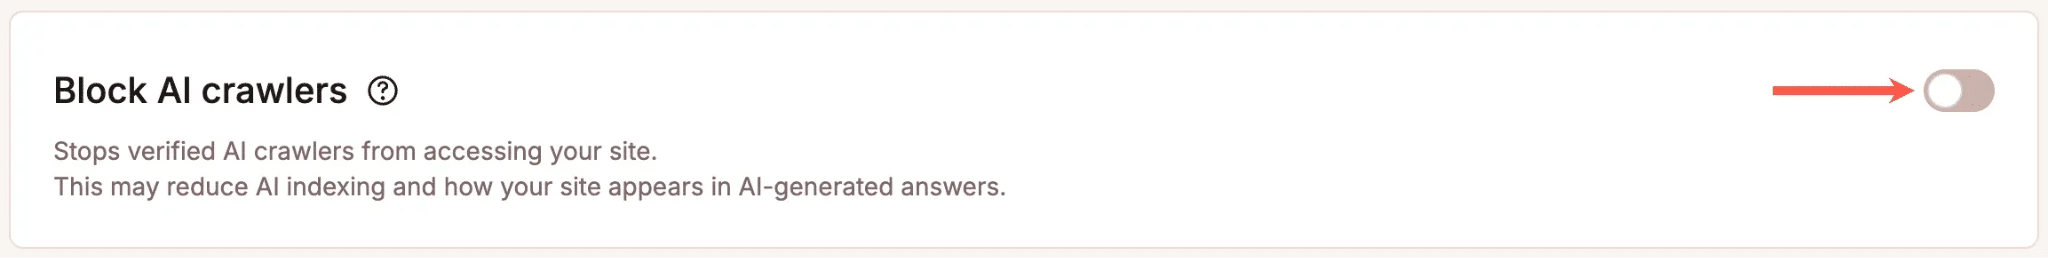
También avisamos a los clientes de que bloquear los rastreadores de IA puede reducir la visibilidad en los resultados de búsqueda, resúmenes o recomendaciones impulsados por IA.
Error 3: considerar cada pico de actividad de los rastreadores de IA como una emergencia de seguridad
Los bots pueden causar problemas de seguridad mediante intentos de fuerza bruta, ataques DDoS, ataques a credenciales y otras formas de automatización abusiva, pero un rastreador de IA verificado que envía demasiadas solicitudes legítimas supone un problema de otro tipo.
Durante nuestro evento en directo sobre el tráfico de bots, Daniel Pataki, director técnico de Kinsta, explicó por qué le preocupa la forma en que reaccionan los propietarios de las webs cuando se mezclan esas dos cosas:
«En este caso, me preocupa más una reacción exagerada que una reacción insuficiente, porque no se trata de un problema de seguridad.»
Se refería al problema más general de los rastreadores de IA, en el que gran parte del tráfico problemático que estamos viendo proviene de sistemas legítimos que rastrean de forma ineficiente, y no de un atacante que intente comprometer tu sitio.
La respuesta cambia cuando el sitio web ya está sufriendo problemas. Si los bots están acaparando recursos del servidor, ralentizando las páginas o impidiendo que los clientes reales usen el sitio, lo primero es estabilizar el sitio. Daniel recomendó bloquear temporalmente el tráfico de bots cuando esté causando un problema activo y, luego, investigar una vez que el sitio esté bajo control.
El error es convertir esa medida de emergencia en una política permanente sin averiguar qué ha pasado.
La protección contra bots de Kinsta te ofrece varios niveles de control, desde una protección básica contra el tráfico malicioso hasta el bloqueo de automatizaciones o la verificación de posibles bots cuando se necesita una protección más estricta. Los rastreadores de IA con una frecuencia excesiva también pueden ser sometidos a verificación en los niveles de protección adecuados.
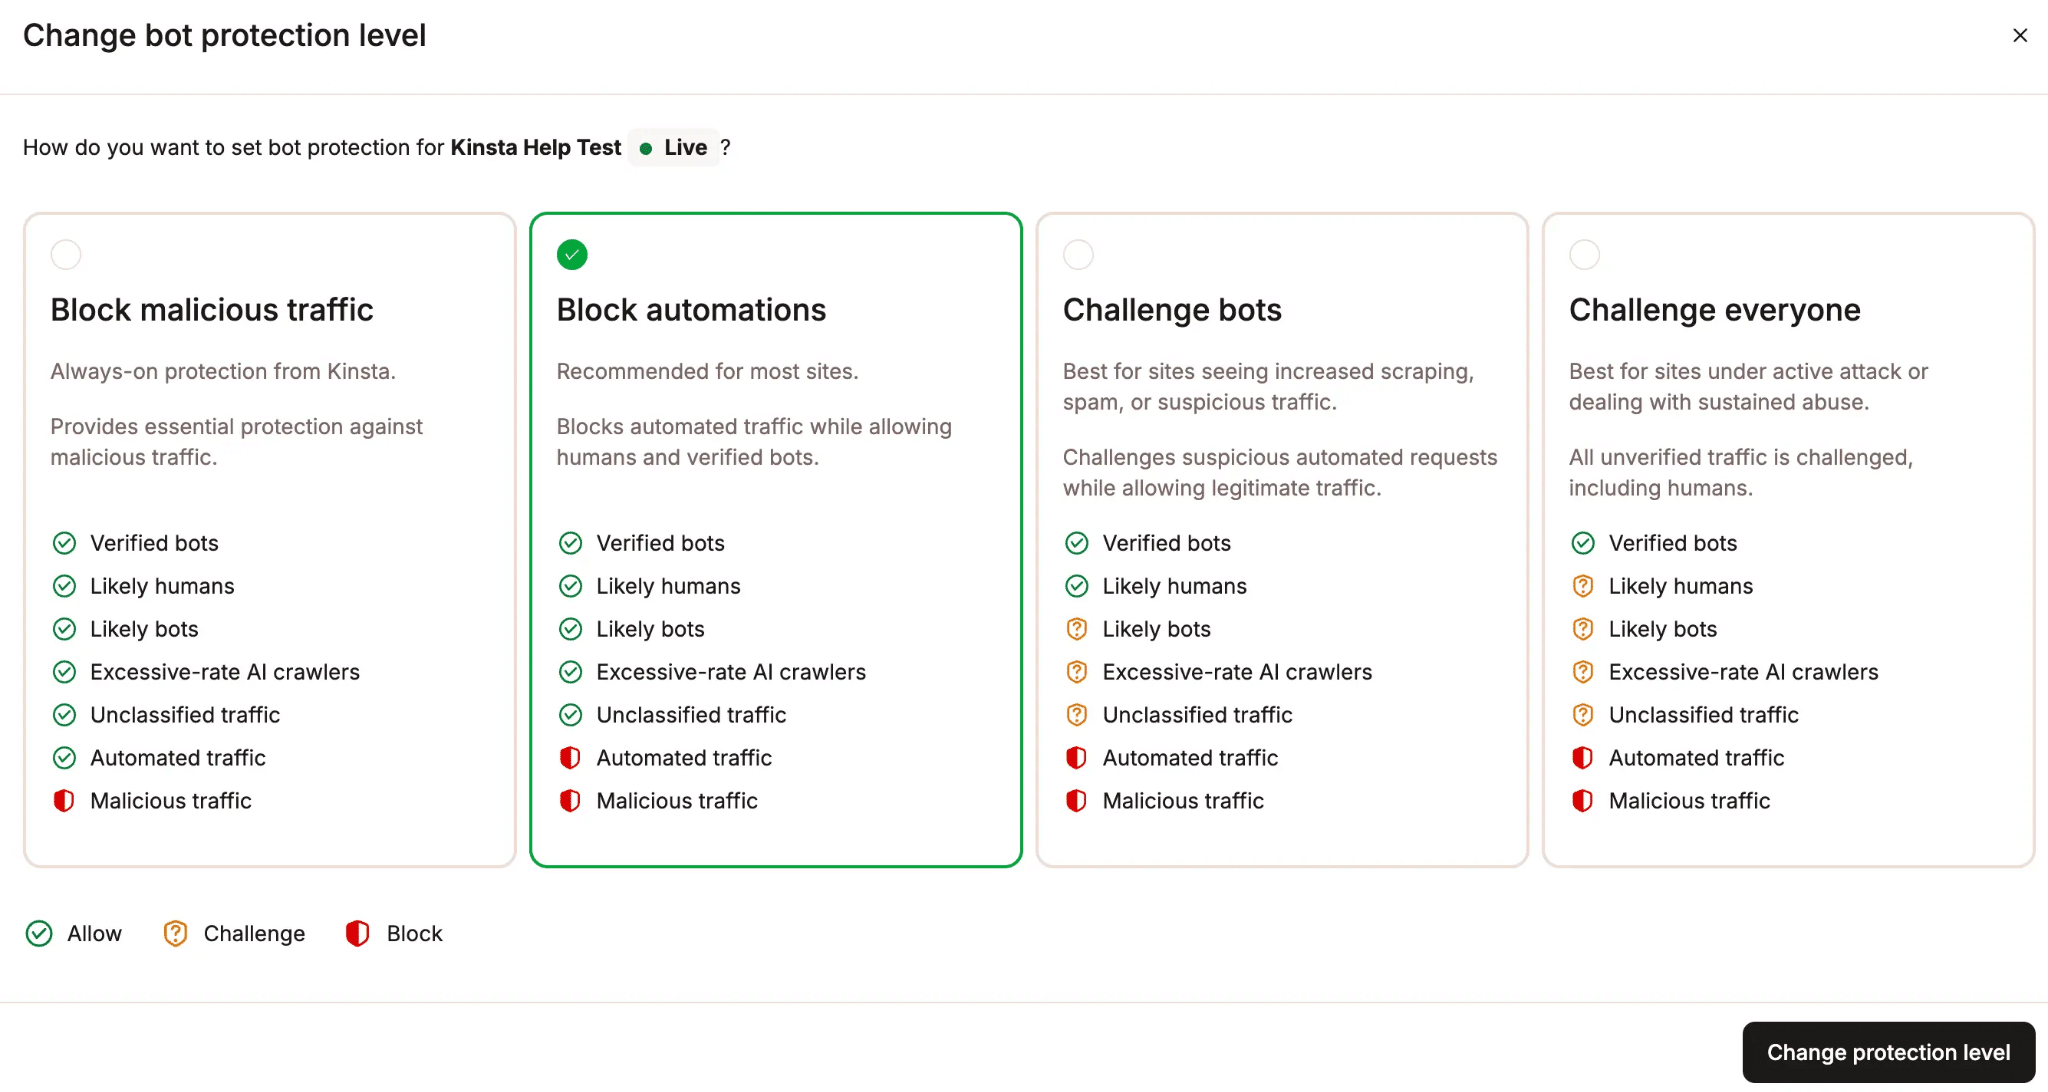
Un problema repentino de rendimiento puede justificar que se apliquen controles más estrictos en este momento. Una vez que el problema haya pasado, comprueba qué estaba afectando al sitio web y si esos controles más estrictos siguen teniendo sentido.
Error 4: fijarse en el volumen de solicitudes y no prestar atención a dónde van esas solicitudes
Nuestros datos de infraestructura dejan esta diferencia muy clara. Una solicitud de una entrada de blog en la caché y otra de una página de búsqueda de WooCommerce sin caché cuentan ambas como una sola solicitud, aunque la segunda pueda suponer mucho más trabajo para el servidor.
Aquí tienes una ilustración del evento en directo Realidad del Tráfico de Bots:
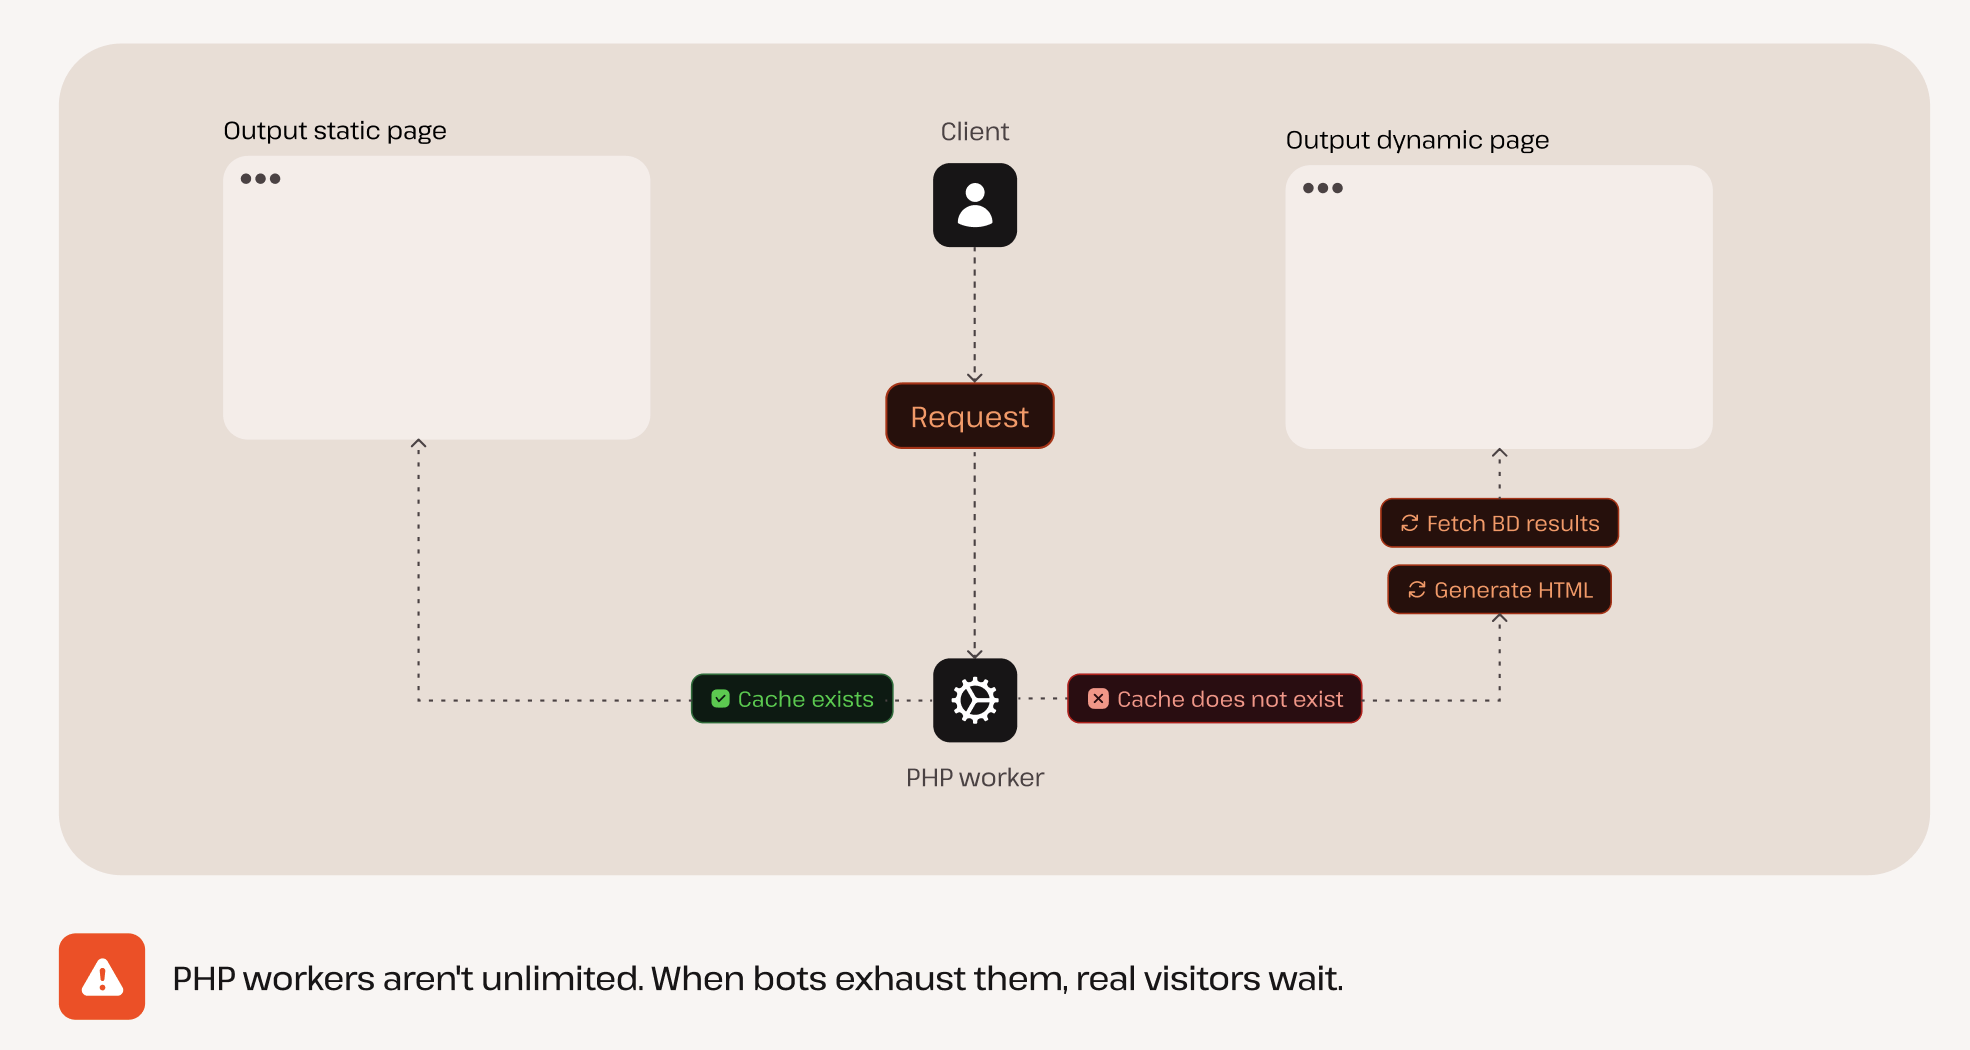
Cuando hay una página en la caché, WordPress puede gestionar gran parte de la solicitud sin necesidad de volver a generar la página.
Una solicitud dinámica puede necesitar un hilo de PHP (también conocido como Worker), consultas a la base de datos, generación de páginas y, a veces, gestión de sesiones antes de que WordPress pueda devolver algún resultado. Las operaciones relacionadas con el carrito y el proceso de pago pueden suponer una carga adicional.
Ahora repite ese proceso miles de veces.
En las tres mediciones de nuestro último estudio, entre el 76,9 % y el 90,5 % de las solicitudes de los rastreadores de IA se dirigieron a contenido dinámico. El tráfico humano se mantuvo entre el 18,3 % y el 18,9 %.
Esa diferencia te dice mucho más sobre la posible presión en la infraestructura que un simple recuento de solicitudes.
Piensa en el caso de las «añadir al carrito» que descubrimos en nuestro estudio sobre el tráfico de bots de IA. Un rastreador generó 3,75 millones de solicitudes en 24 horas, más o menos una solicitud cada 23 milisegundos. Cada solicitud podía hacer que WordPress realizara tareas para un «visitante» que nunca iba a comprar nada.
Por eso también dos sitios con el mismo porcentaje de tráfico de IA pueden comportarse de forma muy diferente.
Una web de contenidos en la que los rastreadores suelen solicitar artículos en caché pueden gestionar un gran volumen sin demasiados problemas, mientras que una tienda de WooCommerce puede notar el impacto mucho antes, incluso si un número menor de solicitudes incide repetidamente en la búsqueda, los filtros, las acciones del carrito, las páginas de cuenta u otras rutas sin caché.
En cuanto detectes un pico, no te fijes solo en el agente de usuario.
En MyKinsta, puedes filtrar el tráfico principal por rastreadores de IA y ver las rutas que solicitan con más frecuencia.
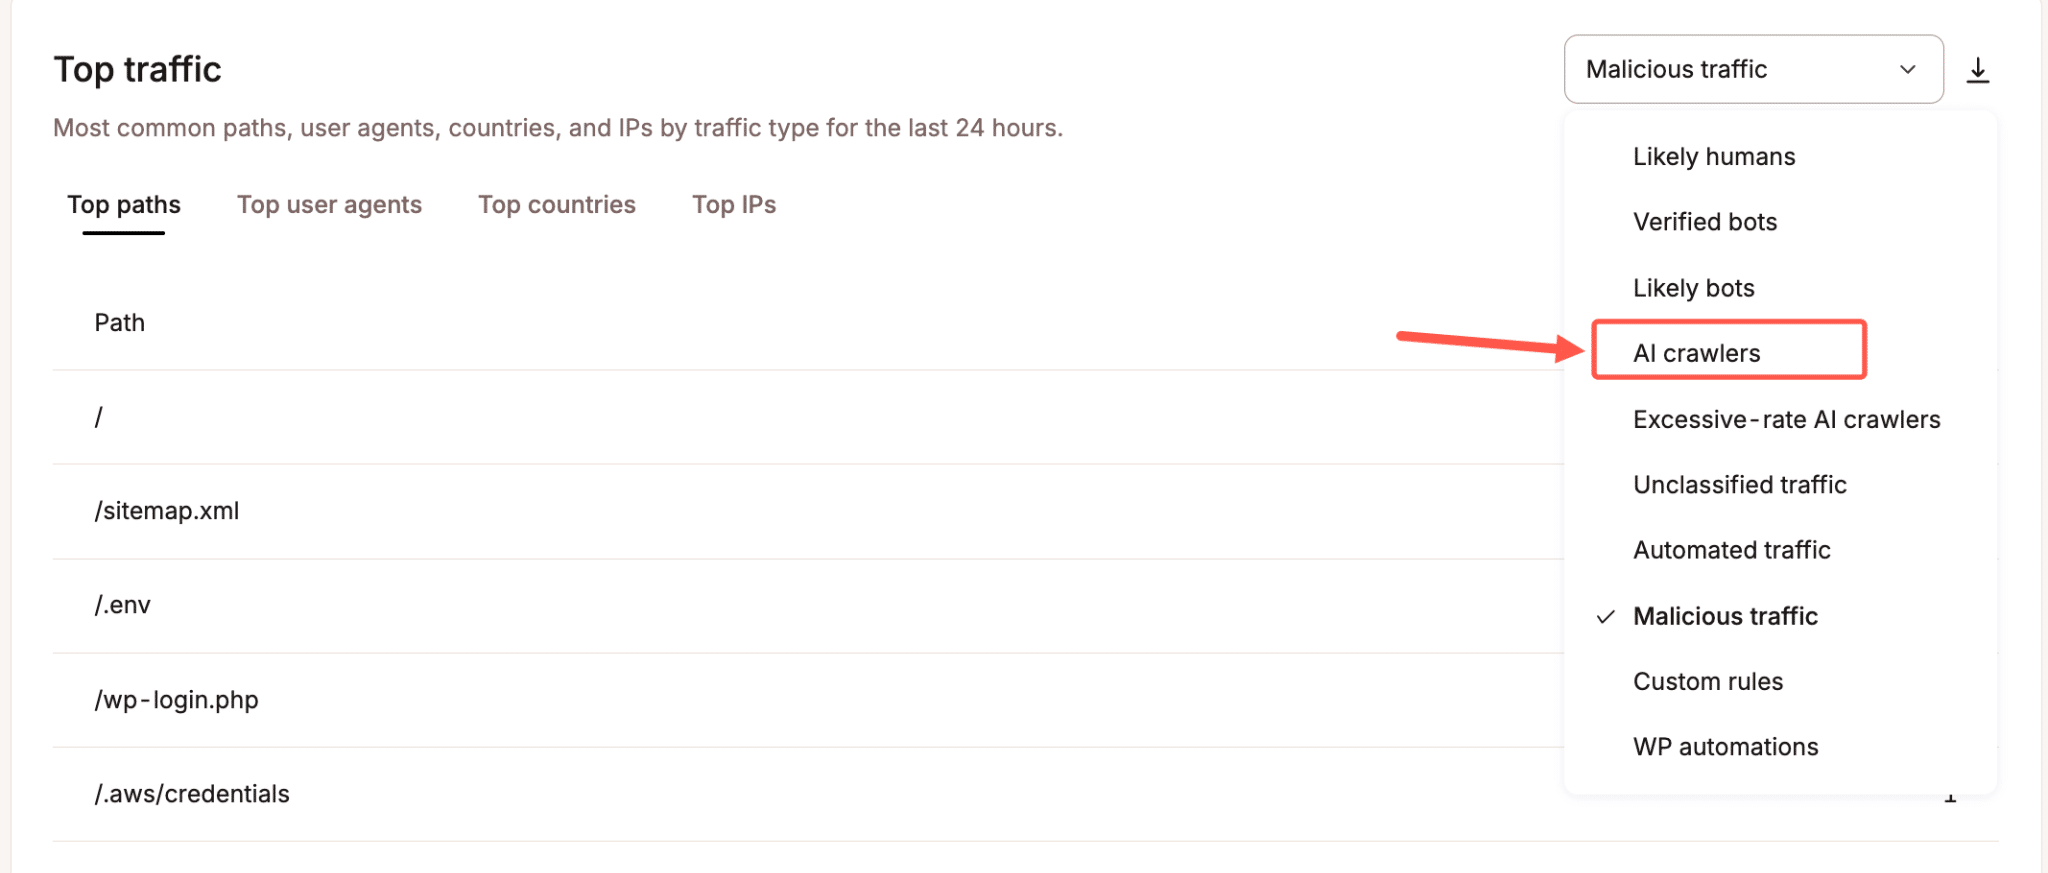
A continuación, compáralo con la información de la caché, el ancho de banda del servidor y los datos de rendimiento para ver si esas solicitudes llegan a la aplicación y generan carga de trabajo.
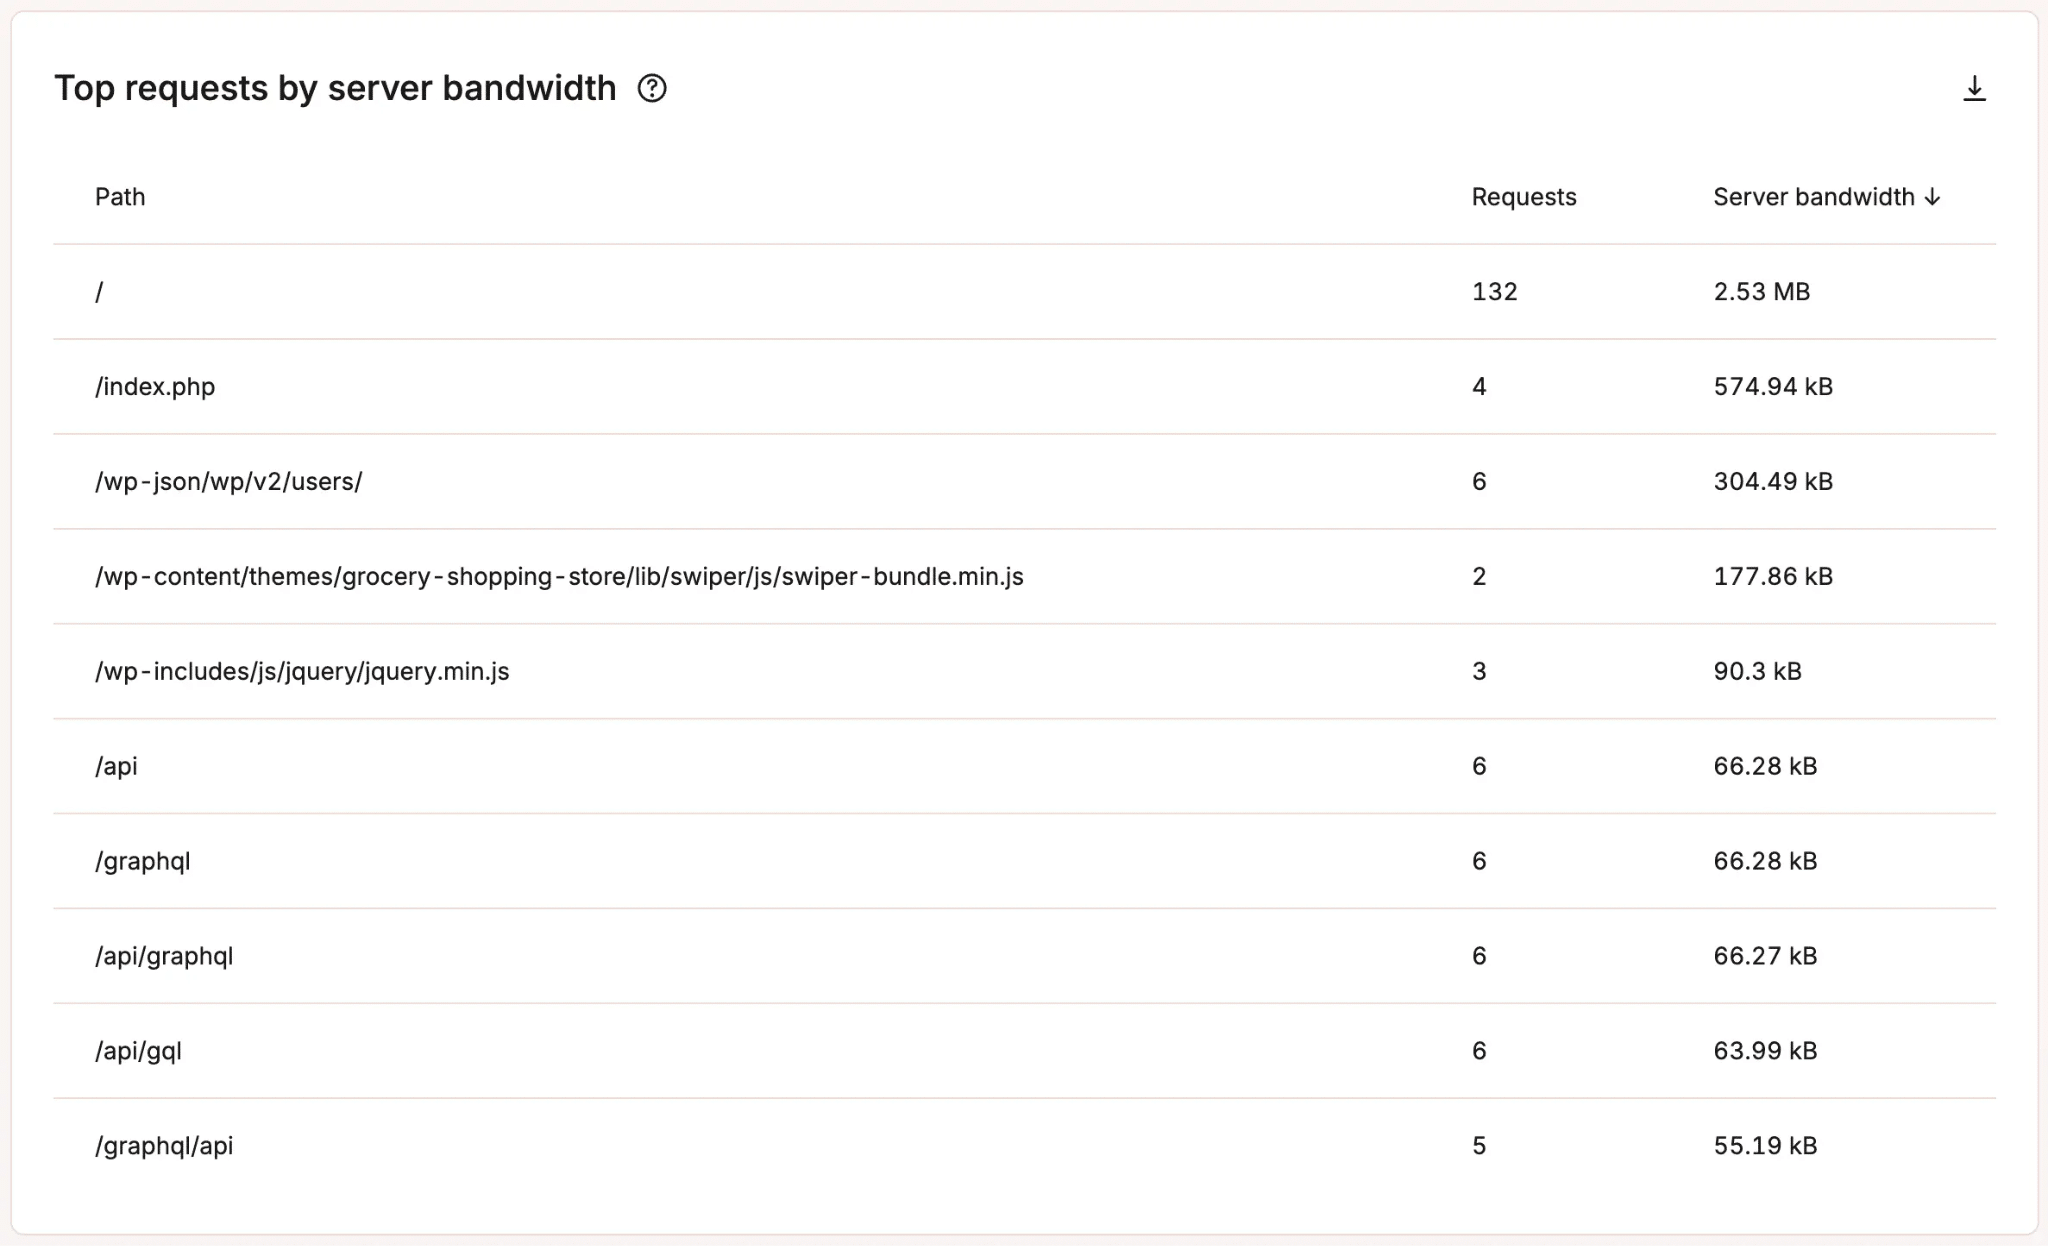
Ver GPTBot u otro rastreador en la parte superior de un informe es útil. Ver que miles de sus solicitudes van dirigidas a /blog/ te dice una cosa. Ver que van a los resultados de búsqueda o a una URL parametrizada de WooCommerce te dice otra cosa.
Error 5: bloquear al rastreador y dejar atrás la trampa de rastreo
A veces, el bot solo sirve para poner de manifiesto un problema que ya está presente en la estructura de tus URLs.
Los sitios de WordPress pueden generar muchas URLs a partir de parámetros de consulta, páginas de búsqueda, archivos filtrados, paginación, calendarios, variaciones de productos y acciones de comercio electrónico.
Una persona puede darse cuenta de que dos URLs ligeramente diferentes llevan básicamente a la misma página, mientras que un rastreador solo ve más enlaces que seguir.
Si cada página genera otro conjunto de URLs que parecen nuevas, el rastreador puede seguir explorándolas. Así es como acabas teniendo patrones que parecen mucho más agresivos de lo que nadie pretendía.
Ya lo vimos en nuestro anterior estudio sobre infraestructura. Un patrón recurrente llegó a ser tan frecuente que una sola regla diseñada para detectarlo filtró 550 millones de solicitudes en 30 días.
Bloquear el rastreador puede impedir que se carguen las páginas de forma inmediata, pero no elimina el patrón de URL que hizo que el rastreador encontrara nuevas páginas.
Cuando una ruta concreta empiece a acaparar de repente el tráfico de los rastreadores de IA, revisa esa ruta:
- ¿WordPress está generando un gran número de combinaciones de parámetros?
- ¿Puede un rastreador seguir avanzando indefinidamente por las URLs de calendario o de paginación?
- ¿Las páginas de búsqueda y filtrado están mostrando miles de variaciones de URLs?
- ¿Se pueden rastrear las URLs de acción, como los enlaces para añadir al carrito, cuando no es necesario?
- ¿Es necesario que todas las URLs que se generan existan y sean detectables?
Aún así, puedes decidir bloquear o rechazar el rastreador, pero primero intenta entender qué es lo que hacía que volviera una y otra vez.
Esto es especialmente importante para las agencias. Si varias páginas de clientes usan el mismo plugin, la misma configuración de WooCommerce, el mismo tema o el mismo patrón de URL, un rastreador agresivo puede provocar el mismo problema en más de una página. Solucionar este comportamiento puede ser más útil que mantener una lista cada vez más larga de nombres de bots.
Error 6: dar por hecho que el archivo robots.txt ha bloqueado el tráfico
Un cambio en el archivo robots.txt puede ser la solución adecuada cuando quieres indicarle a un rastreador de confianza que no acceda a parte o a la totalidad de tu sitio, pero aún así tienes que comprobar el tráfico después.
El archivo robots.txt se basa en que el rastreador respete la instrucción y no impide físicamente que la solicitud llegue a tu sitio web.
Hemos explicado esta distinción con detalle en nuestra guía sobre los rastreadores de IA. El archivo robots.txt indica las preferencias de rastreo, mientras que el llms.txt ofrece un índice de contenido estructurado para las herramientas que decidan leerlo. La aplicación de estas normas se lleva a cabo en otro sitio.
Esto es importante cuando descubres un problema de rendimiento, porque el simple hecho de editar un archivo puede darte la sensación de que el problema ya está resuelto.
Echa un vistazo a tus registros o a las estadísticas de bots. Si las solicitudes del rastreador disminuyen tras el cambio en tu robots.txt, tendrás la prueba de que ha funcionado. Si el tráfico sigue igual, o si te enfrentas a otro sistema automatizado que no sigue las instrucciones, necesitarás un control para hacer cumplir las normas.
Lo mismo ocurre cuando el problema es la frecuencia de las solicitudes, en lugar del acceso en sí. Es posible que se permita a un rastreador leer tu contenido, pero que lo solicite a un ritmo que tu sitio no pueda gestionar sin problemas.
Error 7: copiar las reglas del cortafuegos de otro sitio sin comprobar qué es lo que bloquearían
El ejemplo de PatronView es útil porque la respuesta del sitio se basó en sus propios datos.
Su público se concentra sobre todo en Norteamérica, así que el propietario desafía el tráfico que viene de otros continentes. Revisó sus datos reales de visitantes antes de lanzar el desafío a los usuarios con versiones antiguas del navegador. También controla cuántos de los visitantes a los que se les plantea el desafío lo superan realmente. En un periodo concreto, solo el 0,24 % de más de 100.000 desafíos fueron resueltos.
Esas cifras facilitan justificar las reglas para ese sitio, pero aplicar la misma configuración a una tienda online internacional podría terminar bloqueando a clientes legítimos. El mismo riesgo aparece cuando los equipos acumulan varias herramientas de seguridad porque cada una parece útil por separado.
Un sitio de WordPress podría tener protección contra bots a nivel de alojamiento, reglas de Cloudflare, un plugin de seguridad, limitación de tasa, bloqueos por país y reglas WAF personalizadas, todas ellas tomando decisiones sobre la misma solicitud. Depurar un falso positivo se vuelve mucho más difícil cuando no sabes qué capa tomó la decisión.
A los clientes de Kinsta les recomendamos expresamente que no combinen la Protección contra Bots de Kinsta con otras capas personalizadas de protección contra bots. Las clasificaciones contradictorias pueden provocar que se bloquee a visitantes legítimos o que se bloqueen integraciones.
Unos niveles de protección más altos también pueden afectar a la automatización legítima, como las APIs, las herramientas de monitorización, los webhooks y las integraciones de WordPress. Por eso, MyKinsta incluye una opción Permitir automatizaciones típicas de WordPress y excepciones que siempre permiten el acceso a direcciones IP, rutas y agentes de usuario de confianza.
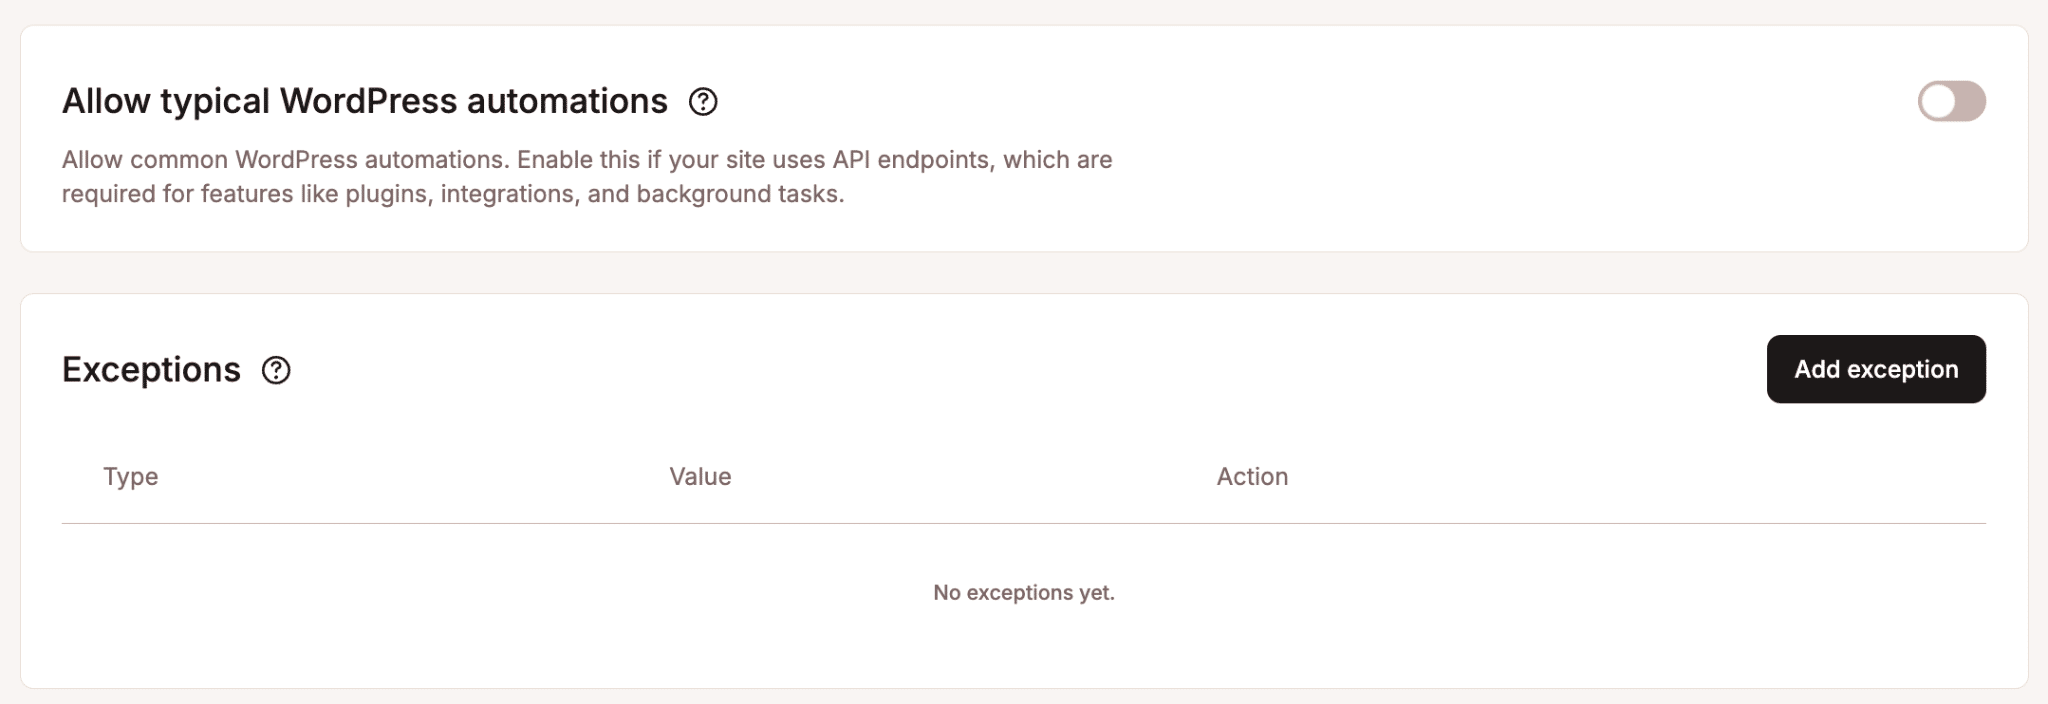
Si diriges una agencia, un proceso estándar resulta más útil que un conjunto de reglas estándar. Puedes aplicar el mismo proceso en 20 sitios web de clientes identificando el tráfico, inspeccionando sus rutas, comprobando el rendimiento, eligiendo un control, probándolo y monitorizando el resultado.
Qué hacer cuando detectas tráfico de bots de IA
Empieza por lo que está pasando en tu sitio web. Si el tráfico de bots está afectando a los visitantes reales, protege primero el sitio y, a continuación, comprueba cuánto tráfico estás recibiendo, a qué rutas llega y qué sistemas son los responsables.
A partir de ahí, elige el cambio más pequeño que resuelva el problema. Eso podría significar actualizar robots.txt, bloquear o rechazar un rastreador, corregir un patrón de URL rastreable o no hacer nada si el tráfico no causa ningún daño.
Los clientes de Kinsta pueden hacer gran parte de este análisis directamente en MyKinsta. Las analíticas de tráfico de bots distinguen entre rastreadores de IA, rastreadores de IA con frecuencia excesiva, bots verificados, tráfico automatizado y otros tipos de solicitudes, mientras que la sección Tráfico principal muestra las rutas, los agentes de usuario, los países y las direcciones IP que hay detrás de ellos.
También puedes comparar esa actividad con el comportamiento de la caché, el ancho de banda del servidor y el rendimiento de PHP para ver si el tráfico realmente está sobrecargando tu sitio antes de decidir qué bloquear.