Añádelo como fuente preferida en Google
Si quieres que tu sitio aparezca en las búsquedas de IA, permitir el acceso a los rastreadores puede parecer la opción más obvia. Pero si el tráfico automatizado consume demasiados recursos del servidor, bloquearlo parece igual de razonable. El problema es considerar esas dos opciones como mutuamente excluyentes.
No hace falta que le des a todos los bots el mismo nivel de acceso. Algunos rastreadores ayudan a que tu contenido aparezca en los resultados de búsqueda o de IA, mientras que otros pueden saturar tu sitio sin aportar mucho a tu visibilidad. Una vez que sepas cuáles son unos y cuáles otros, podrás decidir dónde mantener el acceso abierto y dónde restringirlo.
La categoría de «rastreador de IA» se está volviendo demasiado amplia
No todos los rastreadores de IA hacen lo mismo, así que tratarlos a todos igual puede provocar concesiones innecesarias entre la visibilidad y el rendimiento.
Cloudflare ahora agrupa el tráfico de IA en tres grandes categorías:
- Los rastreadores de búsqueda indexan el contenido para los futuros resultados de búsqueda.
- El tráfico de agentes proviene de herramientas que actúan en tiempo real en nombre de un usuario.
- Los rastreadores de entrenamiento recopilan contenido para entrenar o ajustar modelos de IA.
La composición del tráfico muestra por qué esas distinciones son importantes. Cloudflare informa de que, el entrenamiento de IA representa el 52 % de las solicitudes de los rastreadores a fecha de junio de 2026, mientras que los rastreadores de uso mixto suponen más del 36 %. El rastreo dedicado exclusivamente a búsquedas representa una proporción menor, pero sigue desempeñando un papel importante en la visibilidad.
La identidad del rastreador por sí sola tampoco te da mucha información. Una empresa puede tener varios bots para distintos fines, y un mismo rastreador puede desempeñar múltiples funciones. Incluso los bots verificados pueden causar problemas de rendimiento si el volumen de solicitudes es demasiado alto.
Por eso, las políticas generales de «permitir o bloquear» pierden su utilidad. Si quieres seguir apareciendo en los resultados de búsqueda y en el descubrimiento basado en IA, céntrate en lo que hace realmente cada rastreador y en el valor que aporta. Entender cómo se comportan los rastreadores de IA te da una mejor base para decidir qué permitir, restringir o monitorizar.
Empieza por preguntarte qué te ofrece a cambio el rastreador
Una vez que hayas clasificado los rastreadores según su finalidad, la siguiente pregunta es qué te aporta a cambio su actividad.
El tráfico automatizado ayuda con el posicionamiento en los resultados de búsqueda tradicionales, las menciones generadas por IA, el descubrimiento de productos, las recomendaciones y las búsquedas que se realizan en tu nombre. Algunas de esas interacciones pueden acabar dirigiendo visitantes a tu sitio. Otras pueden aumentar la visibilidad sin generar un clic que puedas medir fácilmente.
El rendimiento potencial varía bastante. Los datos de rastreo por referencia de Cloudflare muestran lo grande que puede ser la diferencia. A lo largo de 2025, Anthropic llegó a rastrear en ocasiones decenas de miles de páginas por cada referencia que enviaba a un sitio web. La proporción de OpenAI solía tener miles, mientras que Perplexity solía quedarse por debajo de unos pocos cientos de rastreos por referencia.
Esas cifras cambian con el tiempo, así que sirven más como prueba de la disparidad que como una clasificación definitiva de las plataformas de IA. Además, no reflejan todas las formas de valor. Cloudflare señala que el tráfico procedente de aplicaciones nativas de IA puede no incluir el encabezado tradicional Referer, lo que significa que algunas visitas no se atribuyen a la plataforma. Las menciones de IA también pueden dar a conocer una marca o un contenido a usuarios que nunca llegan a hacer clic.
Aun así, la pregunta básica sigue siendo útil: ¿Qué obtienes a cambio de las solicitudes que atiende tu sitio?
Puedes evaluar esa relación analizando varios factores:
| Pregunta | Lo que intentas averiguar |
| ¿El rastreador admite la búsqueda o el descubrimiento mediante IA? | Visibilidad potencial |
| ¿Genera tráfico de referencia cuantificable? | Rendimiento directo |
| ¿Qué páginas o endpoints solicita? | Coste de infraestructura |
| ¿Con qué frecuencia realiza el rastreo? | Impacto operativo |
| ¿Es el usuario quien activa la solicitud? | Valor inmediato para el usuario |
| ¿Si lo bloquearas, se perdería un canal de descubrimiento importante? | Riesgo de visibilidad |
Diez mil solicitudes de rastreadores no tienen el mismo valor solo por el hecho de que provengan de sistemas automatizados. Si tienes en cuenta tanto el rendimiento como el coste, tendrás una base más sólida para decidir qué tráfico conviene conservar.
Protege las solicitudes de alto coste en lugar de considerar que todo el tráfico de bots es igual de perjudicial
El tipo de rastreador importa, pero también lo que solicita una vez que llega a tu sitio. Un bot que carga periódicamente artículos almacenados en la caché genera una carga de trabajo muy diferente a la de uno que accede repetidamente a los resultados de búsqueda de WordPress, a páginas de productos filtradas, a las URLs del carrito y del proceso de pago, a los endpoints de la API REST o a URLs con parámetros de consulta variables. Esas solicitudes pueden obligar a WordPress a generar una respuesta nueva en lugar de servir el contenido desde la caché.
Esa diferencia se acumula rápidamente. Según el análisis de Kinsta sobre la actividad de los bots, el tráfico automatizado generó 7,67 millones de solicitudes a URLs de añadir al carrito en un solo periodo de 24 horas. ClaudeBot fue responsable de 3,75 millones de ellas. El problema no era simplemente que un rastreador de IA visitara los sitios web. Era que millones de solicitudes se dirigían a URLs dinámicas, donde cada visita podía suponer más trabajo para la aplicación.
Ya hemos hablado con más detalle en otros artículos sobre la relación entre el tráfico de bots y la carga del servidor de WordPress, así como sobre el coste de la infraestructura que puede generar un tráfico automatizado excesivo. Lo importante aquí es que el acceso de los rastreadores no tiene por qué significar un acceso igualitario a todas las partes de un sitio web.
Puede que tenga sentido dejar que un servicio de IA lea un artículo público o la página de un producto si eso ayuda a que tu contenido aparezca en los resultados de búsqueda o de la IA. Pero no sirve de mucho dejar que el mismo rastreador acceda una y otra vez a las URLs del carrito, a las páginas de búsqueda interna o a otras partes de la web que tardan mucho en cargarse y que no mejoran la visibilidad.
Esto te ofrece otra forma de plantearte la protección contra bots. En lugar de preguntarte solo qué rastreadores debes bloquear, pregúntate también qué solicitudes merece la pena atender.
Crea tu política de bots en función del tráfico que quieras conservar
Una vez que sepas qué solicitudes están sobrecargando más tu sitio, te resultará más fácil decidir qué permitir y qué limitar. Por lo general, una sola lista de permitidos o de bloqueados no es suficiente, ya que los distintos rastreadores tienen fines diferentes y no todos aportan el mismo valor.
Rastreadores de búsqueda tradicionales
Lo normal es que quieras dejar pasar a los rastreadores de búsqueda legítimos, como Googlebot y Bingbot. Siguen siendo importantes para la búsqueda orgánica, y esos mismos índices de búsqueda también se usan para impulsar experiencias de búsqueda más basadas en la IA.
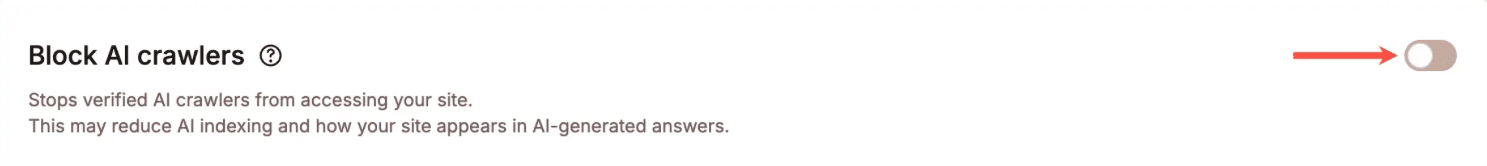
Kinsta considera que los principales rastreadores de búsqueda son bots verificados, y su opción Bloquear rastreadores de IA no bloquea a Googlebot ni a Bingbot. Esa distinción es muy útil, porque proteger tu sitio web del tráfico de los rastreadores de IA no significa automáticamente que vaya a desaparecer de los resultados de búsqueda tradicionales.
Rastreadores de búsqueda y recuperación de IA
Si la visibilidad en la IA es importante para tu negocio, los rastreadores de búsqueda y recuperación merecen una política diferente a la de los bots que recopilan principalmente datos de entrenamiento.
Estos rastreadores pueden acceder al contenido actual para que las herramientas de IA puedan responder preguntas, realizar búsquedas, recomendar productos o dirigir a los usuarios hacia páginas útiles. Permitirlos no garantiza que te citen o te mencionen, pero bloquearlos puede eliminar una de las formas en que un sistema de IA encuentra o recupera tu contenido más reciente.
Para los sitios web que buscan activamente ganar visibilidad en las búsquedas de IA, lo mejor es dejar que llegue ese tráfico cuando aporte valor y observar cómo se comporta.
Rastreadores de entrenamiento
Los rastreadores de entrenamiento plantean una disyuntiva diferente. Recopilan contenido para entrenar o ajustar modelos, así que su actividad tiene una relación menos directa con que alguien pueda encontrar tu último artículo o producto a través de la búsqueda con IA.
Eso no significa que todos los sitios web deban bloquearlos automáticamente. Tu decisión puede depender de la frecuencia con la que los rastrean, de los recursos que consumen esas solicitudes, de tu estrategia de contenido y de si quieres que tu contenido se utilice para el desarrollo de modelos.
Si el tráfico de entrenamiento genera una carga considerable sin aportar un beneficio medible o estratégico, resulta más fácil justificar su restricción.
Tráfico automatizado desconocido o excesivo
Incluso un rastreador legítimo puede convertirse en un problema cuando su frecuencia de solicitudes es lo suficientemente alta.
La Protección contra Bots de Kinsta distingue los rastreadores de IA con una frecuencia excesiva del tráfico habitual de rastreadores de IA. Esto incluye a los rastreadores verificados cuando su actividad alcanza niveles que podrían afectar al rendimiento de tu sitio. Dependiendo del nivel de protección que elijas, Kinsta puede bloquear ese tráfico en lugar de considerar la verificación como un permiso permanente para realizar solicitudes ilimitadas.
Las reglas de tu rastreador pueden cambiar según varíe el tráfico. Quizá te parezca bien permitir el acceso a ciertos bots la mayor parte del tiempo, para luego restringirlo si empiezan a consumir demasiados recursos o a afectar al rendimiento de tu sitio.
Kinsta te ofrece varias opciones de configuración, no solo un botón para activar o desactivar la IA
Una política selectiva para bots funciona mejor cuando ajustas cómo gestiona tu sitio los diferentes tipos de tráfico automatizado. La Protección contra Bots de Kinsta te ofrece varios controles para hacerlo, en lugar de reducir la decisión a un único ajuste de permitir o bloquear.
Kinsta ofrece cuatro niveles de protección:
- Bloquear tráfico malicioso bloquea las solicitudes maliciosas conocidas, mientras que deja pasar el resto del tráfico.
- Bloquear automatizaciones añade restricciones al tráfico automatizado confirmado.
- Desafiar a los bots aplica un desafío al tráfico que Kinsta identifica como automatizado o probablemente automatizado.
- Desafiar a todos aplica el nivel de protección más estricto y desafía a todos los visitantes.
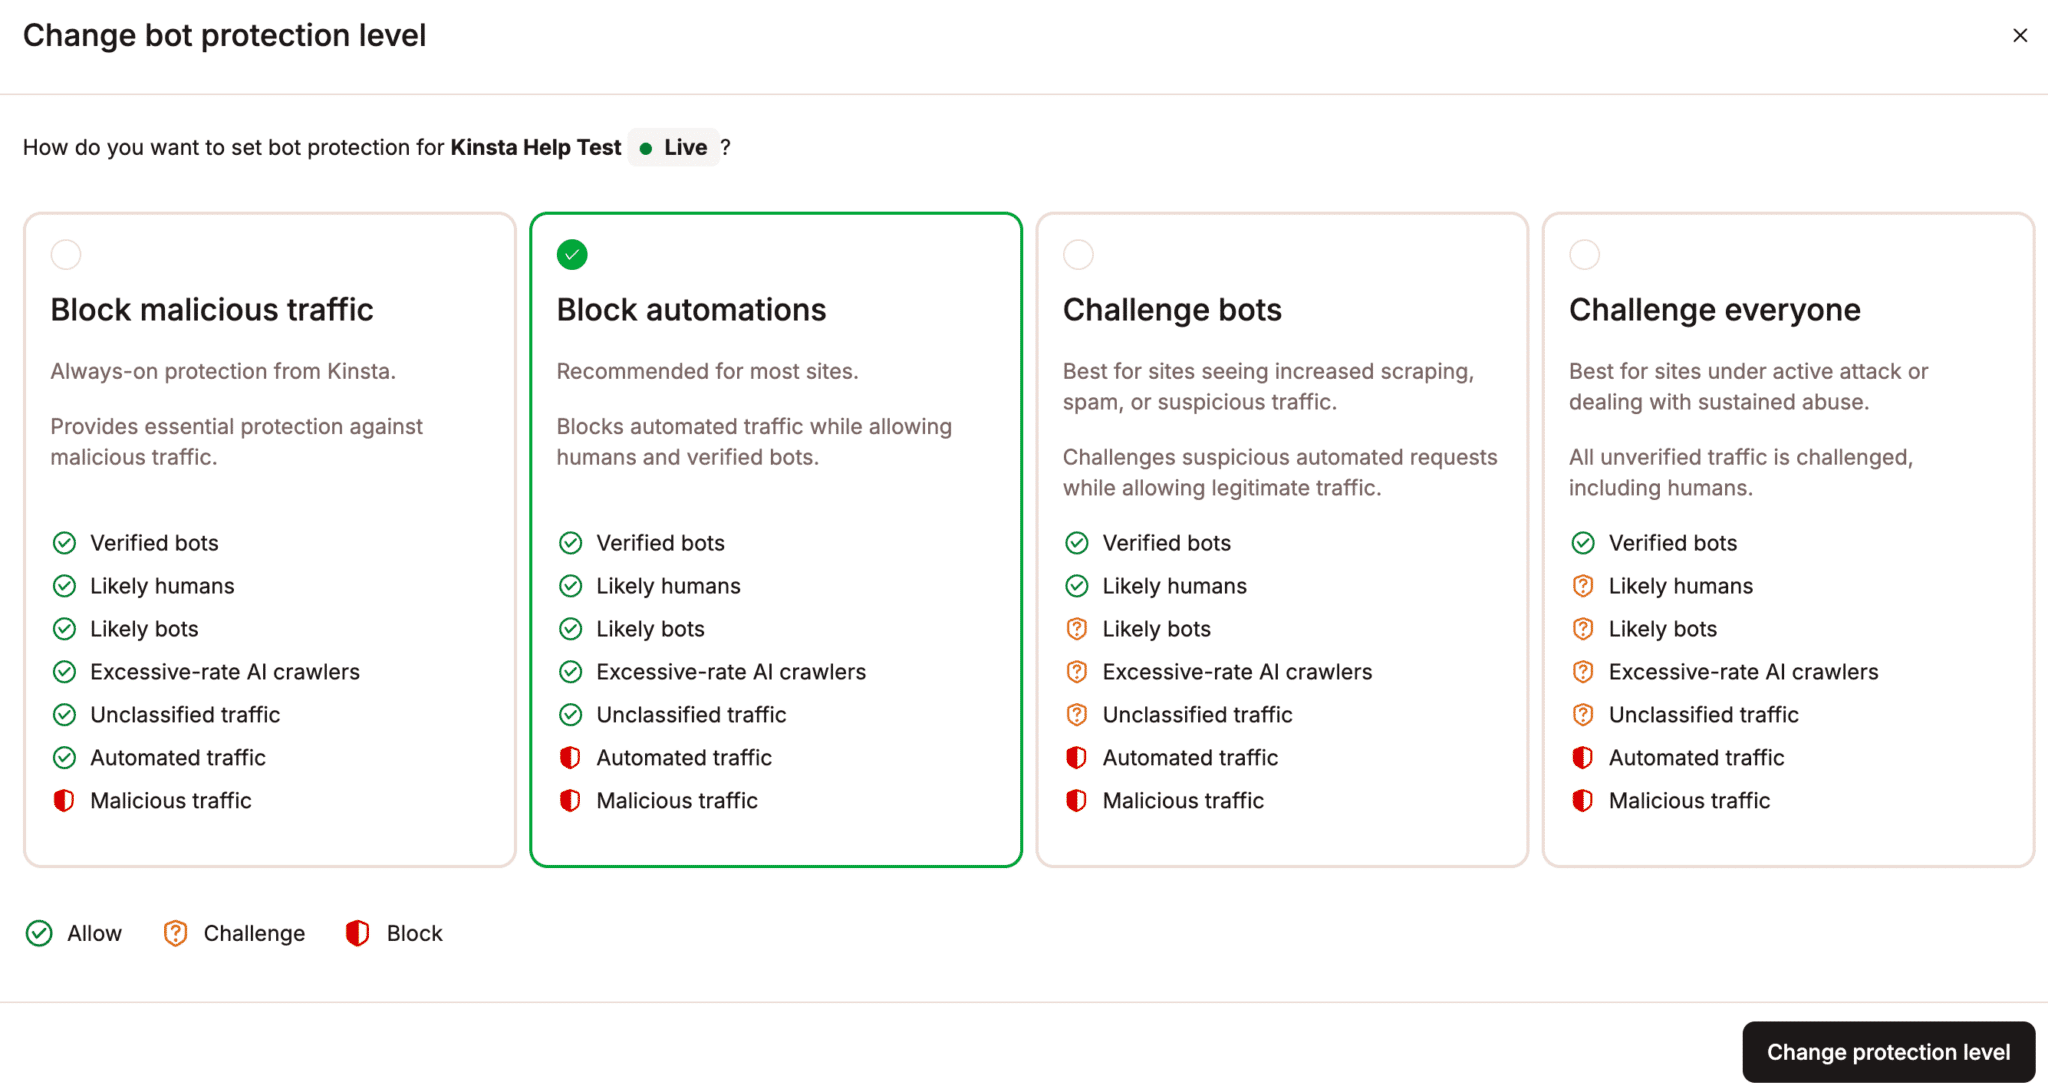
Estos niveles te permiten reforzar la protección cuando el tráfico de bots se convierte en un problema, sin tener que crear manualmente reglas para cada rastreador o agente de usuario.
Como ya hemos mencionado, Kinsta también ofrece una opción independiente llamada Bloquear rastreadores de IA. Cuando está activada, bloquea los rastreadores de IA soportados, incluidos los verificados, pero no bloquea a Googlebot ni a Bingbot. Esto te permite restringir ciertos rastreos específicos de IA sin que tu sitio quede excluido de los motores de búsqueda tradicionales.
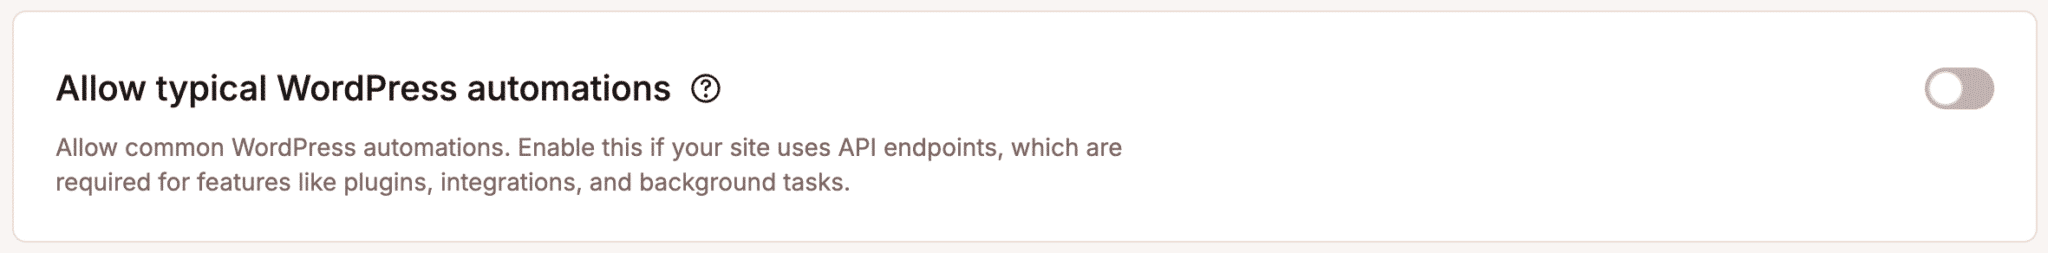
Una protección más estricta plantea otra preocupación: la automatización legítima. Los sitios de WordPress dependen de tareas programadas, solicitudes de la API REST, integraciones de plugins, servicios de pago, herramientas de monitorización y otros procesos automatizados que no quieres interrumpir. La opción de Kinsta Permitir automatizaciones típicas de WordPress ayuda a mantener esa actividad cuando utilizas niveles de protección más estrictos.
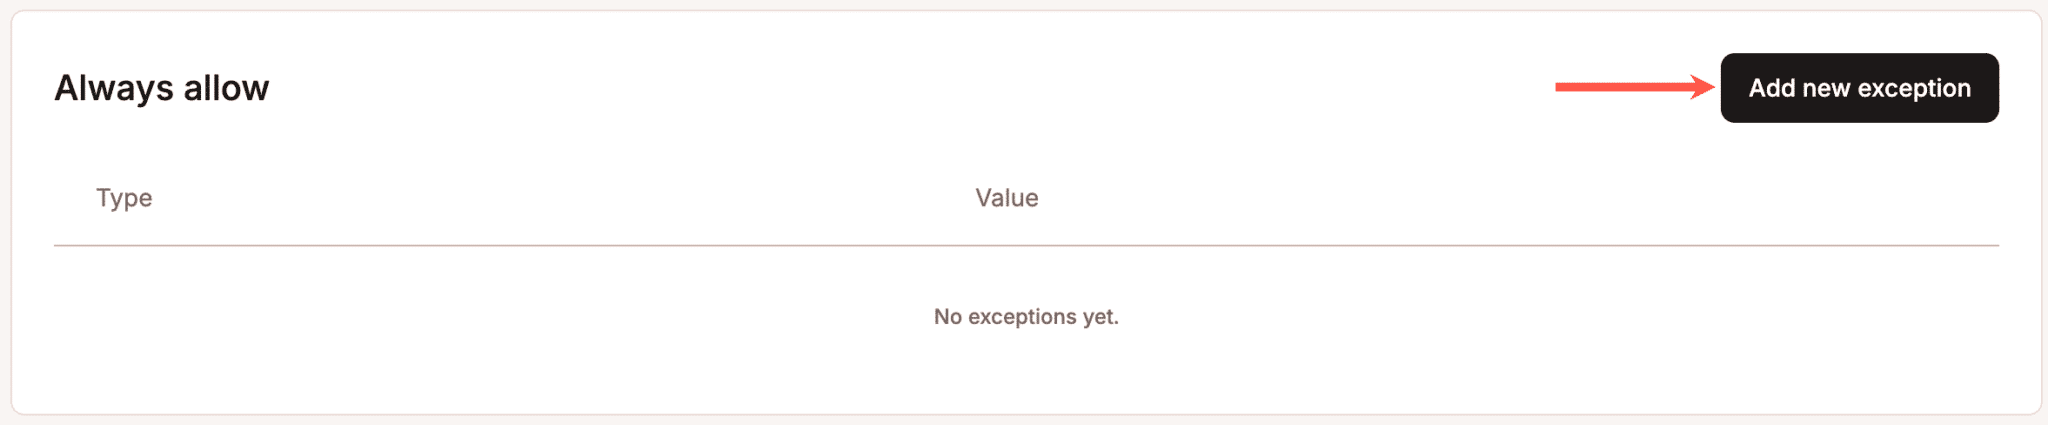
Para cualquier cosa que requiera un tratamiento más específico, las excepciones Permitir Siempre te permiten autorizar el tráfico en función de una dirección IP, una ruta o un agente de usuario.
En conjunto, estos controles te dan margen para ajustar tu respuesta a medida que cambia el tráfico. Puedes mantener el tráfico útil de búsquedas y automatización, restringir los rastreadores de IA cuando la compensación merezca la pena y aumentar la protección cuando la actividad automatizada empiece a ejercer demasiada presión sobre el sitio web.
Comprueba si tu equilibrio funciona de verdad
La protección contra bots funciona mejor como un proceso continuo y no solo como una configuración puntual. Una vez que hayas ajustado cómo gestiona tu sitio el tráfico automatizado, debes comprobar si el cambio mejora realmente el rendimiento sin cortar canales de descubrimiento útiles.
Empieza comparando lo que ocurre antes y después de realizar un cambio. Fíjate en:
- El volumen de solicitudes de los rastreadores de IA
- Actividad de los rastreadores de IA con frecuencia excesiva
- Las rutas más solicitadas
- Solicitudes permitidas, rechazadas y bloqueadas
- Rendimiento del sitio web durante los picos de actividad de los rastreadores
- Tráfico de búsqueda orgánica
- Tráfico de referencia de IA que puedes medir
- Conversiones u otras acciones valiosas de los visitantes referidos por IA
Kinsta te ofrece varias formas de analizar esa actividad en MyKinsta. La vista Desglose de solicitudes agrupa las solicitudes en categorías, como bots verificados, rastreadores de IA, rastreadores de IA con frecuencia excesiva, tráfico automatizado y posibles bots. El informe Tráfico principal te puede ayudar a identificar qué rutas, agentes de usuario, direcciones IP y países generan más solicitudes.
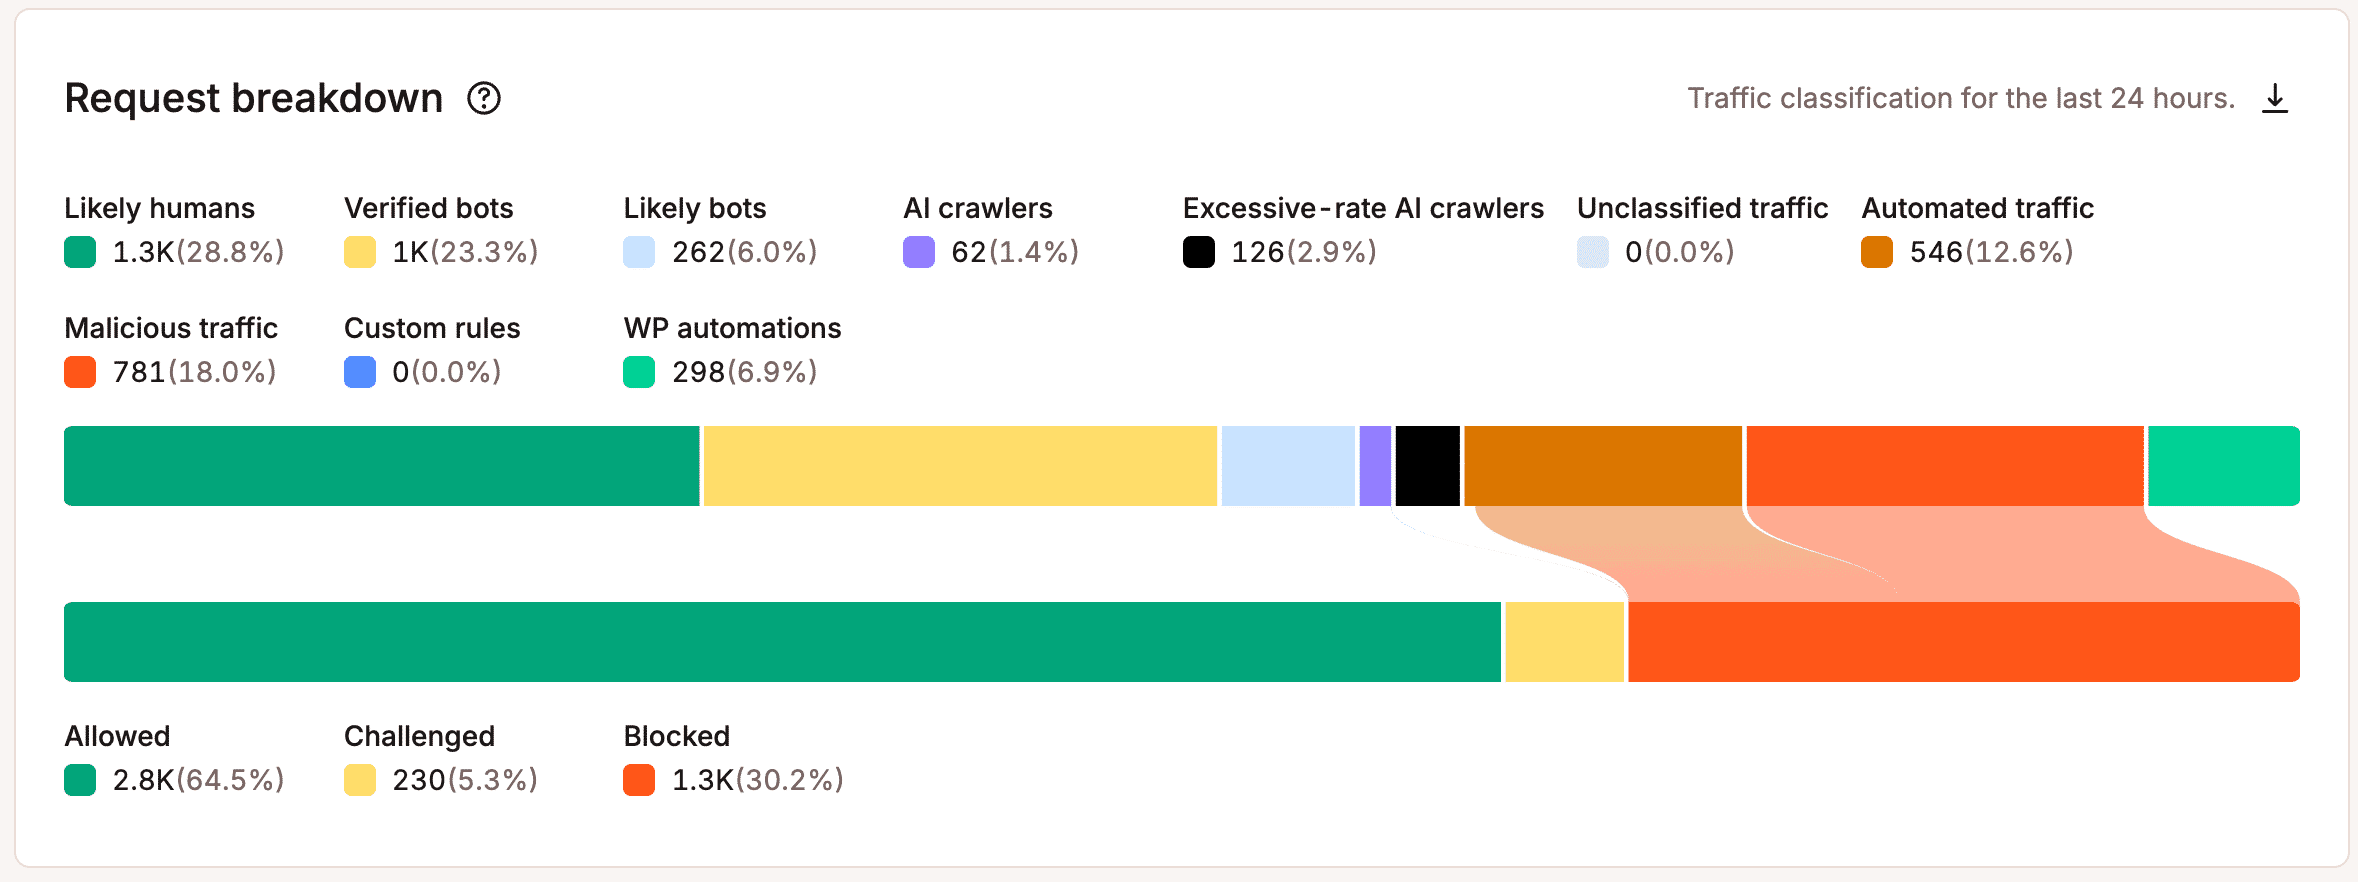
Esas estadísticas resultan especialmente útiles después de cambiar un nivel de protección o bloquear una categoría de rastreadores. Si la carga del servidor baja mientras que el tráfico de búsqueda y las visitas procedentes de la IA se mantienen estables, es posible que el cambio esté surtiendo exactamente el efecto que buscabas. Si el tráfico útil también disminuye, tienes un motivo para revisar la configuración o añadir una excepción más específica.
Lo mismo ocurre cuando cambian las circunstancias. Un rastreador que hoy apenas da problemas puede aumentar su frecuencia de solicitudes más adelante, mientras que un canal de descubrimiento basado en IA que ahora envía poco tráfico cuantificable puede llegar a ser más valioso con el tiempo.
Un ciclo sencillo funciona bien: observar, ajustar, comparar y, a continuación, mantener o revertir el cambio.
Los nuevos controles de IA de Cloudflare muestran hacia dónde se dirige la gestión de bots
Los recientes cambios de Cloudflare apuntan a la misma estrategia general: gestionar el tráfico automatizado en función de lo que hace, en lugar de aplicar la misma regla a todos los rastreadores de IA.
En julio de 2026, Cloudflare sustituyó su enfoque único para los bots de IA por controles independientes para el tráfico de búsqueda, agente y entrenamiento. Los propietarios de los sitios web pueden permitir cada categoría, bloquearla en todo el sitio o bloquearla solo en las páginas que muestran anuncios. A partir del 15 de septiembre, los nuevos dominios utilizan ajustes predeterminados que permiten el tráfico de búsqueda, mientras que bloquean el de agente y entrenamiento en las páginas con anuncios. Cloudflare también cambia la forma en que se aplican sus políticas a los rastreadores de doble finalidad que combinan actividades como la búsqueda y el entrenamiento.
Este cambio es importante porque reconoce un problema al que ya se enfrentan los propietarios de sitios web. Puede que quieras que un rastreador indexe el contenido para que se pueda encontrar, pero sin darle a ese mismo operador acceso ilimitado para entrenar modelos. Un simple interruptor de «bots de IA» no basta para expresar bien esa preferencia.
Si tienes tu sitio alojado en Kinsta, ten cuidado al añadir capas adicionales de protección contra bots a las que ya hay. Si además usas tu propia configuración de Cloudflare con reglas personalizadas de WAF o contra bots, Cloudflare se encarga primero de esas solicitudes. En algunos casos, eso puede significar que el tráfico legítimo se bloquee antes de que Kinsta llegue a verlo.
Los cambios de Cloudflare no son tanto un nuevo conjunto de reglas que todos los sitios de WordPress deberían copiar, sino más bien una señal de hacia dónde va la gestión de bots. El enfoque binario está dando paso a controles que te permiten conservar el tráfico automatizado útil, al tiempo que restringen la actividad que aporta menos valor.
Las agencias necesitan una política, no una configuración única para todos los clientes
Para las agencias, no hay una política única sobre bots que sirva para todos los clientes. Puede que un editor esté dispuesto a permitir más actividad de los rastreadores de IA si eso ayuda a que el contenido se encuentre más fácilmente, mientras que una página de WooCommerce con mucho tráfico puede necesitar límites más estrictos cuando esas solicitudes empiecen a competir con los compradores por los recursos del servidor.
Un caso de estudio sobre el trabajo realizado con Hall demuestra por qué esas diferencias son importantes. Uno de los clientes de WooCommerce de la agencia tenía problemas de caídas del servicio durante los picos de tráfico antes de pasarse a Kinsta. A medida que el negocio crecía de 3 millones de dólares a más de 50 millones de dólares en ingresos anuales, contar con un rendimiento fiable durante los picos de demanda se volvió cada vez más importante.
Las reglas para los bots deben reflejar cómo funciona realmente cada sitio web. Averigua qué rastreadores son importantes para el cliente, cuáles están ejerciendo más presión sobre el sitio y qué servicios automatizados deben seguir siendo accesibles. Después, ve ajustando las reglas con el paso del tiempo, a medida que cambia el tráfico y, con él, las necesidades del cliente.
Controla el acceso sin desaparecer
No tienes por qué elegir entre que tu sitio sea visible para los sistemas de IA y protegerlo del tráfico automatizado excesivo. La pregunta más importante es qué actividad merece tener acceso, en qué casos tiene sentido ese acceso y cuánto le cuesta a tu sitio atenderla.
Mantén el tráfico de búsqueda y de IA que ayuda a la gente a encontrar tu sitio web, pero presta atención a lo que ocurre una vez que esos rastreadores llegan allí. Si un bot empieza a consumir muchos recursos sin aportar gran beneficio, puedes limitar su acceso. Eso sí, ten cuidado de no interferir con las automatizaciones de WordPress ni con otros servicios de los que depende tu sitio web.
Esas decisiones pueden cambiar a medida que evolucionen el comportamiento de los rastreadores, los patrones de referencia de la IA y tus propias prioridades. Lo importante es tener suficiente visibilidad para ver lo que está pasando y suficiente control para responder.
Descubre más sobre la Protección contra Bots de Kinsta y echa un vistazo a las conclusiones de nuestro Informe sobre tráfico de IA y bots.